MySQL面试总结
归纳整理人: 魏姚
个人博客: https://www.zhihu.com/column/c_1876380493982867456
更新时间:2026.1.18
更新日志: 添加目录模式,方便查看
题库总数量: 454
目录
MySQL面试总结目录基础面试题1.1.1 MySQL 安装方式有哪些,你们公司用的哪个方式,为什么?1.1.2 关系型数据库与非关系型数据库的区别?1.1.3 MySQL 5.6,5.7/8.0 版本安装过程有什么区别?1.1.4 MySQL 5.7,8.0 在用户管理功能上有什么区别,请举例说明1.1.5 请描述 MySQL 的授权表有哪些,都有什么作用?1.1.6 简述你在工作中使用 MySQL 连接的方式?1.1.7 MySQL 的配置文件标签有哪些?(my.cnf)1.1.8 MySQL 忘记root 用户密码怎么办?1.1.9 在公司中一般给开发,运维,管理员授予什么权限1.1.10 请列举 MySQL 配置文件的读取顺序?1.1.11 请列举 MySQL 启动和关闭方式?1.1.12 你们公司使用多实例环境吗?在什么地方用的?1.1.13 如何查看数据库当前连接情况1.1.14 简述数据库启动不了,如何排查?1.1.15 数据库连接不上如何排查?1.1.16 MySQL常用数据类型有哪些1.1.17 MySQL 约束有哪些?1.1.18 MySQL 列的属性设置有哪些?1.1.19 MySQL 如何设置自增列 自增列是否可以自定义起始值1.1.20 MySQL 自增列的范围?1.1.21 MySQL服务模式有哪些常用参数,什么时候会用到?1.1.22 MySQL 查询表中数据中文字体乱码,原因可能是什么?如何修改?1.1.23 什么是实例1.1.24 简述 MySQL 程序结构?1.1.25 简述一条 select 语句的执行过程?1.1.26 请简述 MySQL 逻辑结构和宏观物理结构?1.1.27 请简述段、区、页的构成1.1.28 你们公司用的 MySQL 版本,为什么选择?1.1.29 数据库文件损坏最大原因?1.1.30 MySQL 用户安全规范1.1.31 授权权限 3 条红线1.1.32 inplace 升级至 5.7、8.0,升级方式上有什么区别?8.0 要注意什么 ?1.1.33 MySQL 中 TEXT 类型最大可以存储多长的文本1.1.34 MySQL 中 AUTO_INCREMENT 列达到最大值时会发生什么?1.1.35 MySQL 中 EXISTS 和 IN 的区别是什么?1.1.36 MySQL数据库的优缺点?1.1.37 什么是隐式转换?1.1.38 MySQL 怎么查看系统资源(内存,CPU)?1.1.39 数据库启动时间与哪些因素有关?1.1.40 有一个 8核心 16g 服务器,活动会话数达到多少个会不正常?1.1.41 MySQL 如何管理用户连接的?1.1.42 MySQL 5.7 和 MySQL 8.0 有哪些区别?1.1.43 MySQL 5.6 和MySQL 5.7 有什么区别?1.1.44 MySQL 从5.6 升级到5.7 是不是大版本升级?1.1.45 MySQL 数据库升级,你常用的是哪个数据库版本的升级?1.1.46 idb 和 frm 文件是用来干什么?1.1.47 ibdata 和 ib_log_file 放的什么?1.1.48 你们一台物理机是部署一个MySQL还是多套?因为是多实例的,有遇到过实例之间的影响案例吗?1.1.49 哪些不是活跃连接?用什么语句看?1.1.50 MySQL 碎片信息怎么看?1.1.51 mysql结构体系和工作原理?1.1.52 mysql 8.0 新特性SQL 1.2.1 请简述select语句的各个子句的执行顺序?1.2.2 请列举 SQL 语句的种类和代表命令?1.2.3 请简述SQL_MODE的作用?ONLY_FULL_GROUP_BY是干什么用的?1.2.4 SQL_MODE 的常用参数,什么使用应用这些参数?1.2.5 请简述MySQL utf8和utf8mb4区别?1.2.6 请简述tinyint、int、bigint 如何计算的存储位数?1.2.7 请简述 CHAR(10) 和 VARCHAR(10) 区别,生产如何选择?并阐述为什么?1.2.8 请简述 DATETIME 和 TIMESTAMP 区别?1.2.9 什么是数据库的视图?1.2.10 请简述你们数据库开发过程,选择数据类型的规范是什么?1.2.12 请简述你们公司在 Schema 设计过程中有哪些开发规范?1.2.13 请简述 DROP TABLE、TRUNCATE TABLE、DELETE FROM TABLE 的区别?1.2.14 请简述如何利用 UPDATE 替换 DELETE 语句实现伪删除?1.2.15 如果要你规划一个 10 亿的大表,你有什么好的方案?1.2.16 如果这张10亿单表已经存在了,想要删除1000W数据如何处理?1.2.17 生产中使用过分区表吗?你们使用的是什么分表策略?分区表有什么优势和劣势?1.2.18 请简述 GROUP BY 语句的执行原理?1.2.19 WHERE 和 HAVING 语句的区别?1.2.20 生产中进行数据库资产统计,都统计什么?如何统计?1.2.21 请介绍你常用的聚合函数及其作用1.2.22 简述多表连接的方式1.2.25 什么是笛卡尔乘积?1.2.26 你们公司 Online DDL 如何处理的?1.2.27 5.6、5.7、8.0 在 Online DDL 的改变?1.2.28 简述 pt-osc 或者 gh-ost 第三方工具在处理 DDL 时的原理?1.2.29 为什么在MySQL 中不推荐使用多表 Join ?1.2.30 MySQL中count(*) count(1) count (字段名) 的区别是什么?1.2.31 MySQL 中 int(11) 的 11 表示什么?1.2.32 MySQL 中 varchar 和 char 有什么区别?1.2.33 MySQL 中如何进行 SQL 调优?1.2.34 select * 和 select 所有字段区别?1.2.35 select * 一定会全表遍历吗?1.2.36 连表查询怎么看哪个是驱动表,哪个是被驱动表?1.2.37 嵌套连结和hash join原理 ?1.2.38 update一条语句的流程?索引1.3.1 请列举 MySQL 索引的类型1.3.2 MySQL 索引算法演变:二叉树,二叉平衡树,红黑树,B -Tree, B+Tree?1.3.3 索引树高度影响因素有哪些?1.3.4 详细说一说B+树在磁盘IO方面的优势1.3.5 MySQL 8.0 索引的新特性1.3.6 创建索引时应当注意什么(什么时候适合创建索引)?1.3.7 什么时候不适合创建索引1.3.8 什么情况会造成索引失效?1.3.9 如何获取执行计划?如何理解分析执行计划的输出?1.3.10 什么是回表查询?如何减少回表1.3.11 聚簇索引和非聚簇索引有什么区别?1.3.12 描述 MySQL 的 B+ 树中查询数据的全过程1.3.13 唯一索引与普通索引的区别?1.3.14 详细说说最左前缀匹配1.3.15 能说说什么是索引下推吗?1.3.16 执行计划中你一般关注哪些点?1.3.17 MySQL为什么选择 B+tree 查找算法?1.3.18 一条select语句平常查询时很快,一天突然变慢了的原因?1.3.18 聚簇索引构建条件 聚簇索引是如何构建的?1.3.19 索引有哪些自优化能力?1.3.20 如何建立索引才能加快查询?1.3.21 建立索引后还会出现慢查询后如何解决及原因?1.3.22 MySQL 中的数据排序是怎么实现的?1.3.23 MRR多范围读取优化?1.3.24 MySQL 中的索引数量是否越多越好?为什么?1.3.25 联合索引与单列索引的区别?1.3.26 你能看到你查询时间?查询速度?1.3.27 ⽐如说我查询的表结构是string类型,然后我⽤varchar类型的会⾛索引吗?1.3.28 varchar类型的不是要加单引号吗,然后你不加单引号直接查⼀个数字能查出了吗?(⽐如说;varchar类型是123456,查id=123456能查出来吗?不加单引号)?1.3.29 explain查执⾏计划,ID列的执⾏顺序是怎么样的?1.3.30 B+tree构建过程1.3.31 MySQL 中使用索引一定有效吗?如何排查索引效果?1.3.32 MySQL 的覆盖索引是什么?1.3.33 索引下推如何开启?1.3.34 如何使用 MySQL 的 EXPLAIN 语句进行查询分析?存储引擎1.4.1 MySQL 中 InnoDB 存储引擎与 MyISAM 存储引擎的区别是什么?1.4.2 MySQL 有哪些存储引擎?1.4.3 TokuDB 等存储引擎相较于 InnoDB 有什么优势?在什么场景应用?1.4.4 MySQL 的碎片是如何产生的?你是如何处理的?1.4.5 简述 InnoDB 物理存储结构1.4.6 简述 InnoDB 内存结构?1.4.7 InnoDB 的共享表空间在不同版本有什么变化?1.4.8 简述表空间迁移的过程1.4.10 共享表空间如何扩容?1.4.11 如何独立 Undo 表空间?1.4.12 MySQL 的 Doublewrite Buffer 是什么?它有什么作用?1.4.13 从 MySQL 获取数据,是从磁盘读取的吗?(buffer pool)1.4.14 MySQL 中的 Log Buffer 是什么?它有什么作用?1.4.15 MySQL 中如何解决深度分页的问题?1.4.16 什么是 Write-Ahead Logging (WAL) 技术?它的优点是什么?MySQL 中是否用到了 WAL?1.4.17 MySQL 的查询优化器如何选择执行计划?1.4.18 MySQL 三层 B+ 树能存多少数据?1.4.19 什么是数据库的逻辑删除?数据库的物理删除和逻辑删除有什么区别?1.4.20 表空间迁移的背景?1.4.21 独立表空间迁移中 5.7 版本的数据库如何迁到 8.0 版本的数据库?N1.4.22 如何调整buffer pool区域大小, 建议设置多大比较合理?1.4.23 如何调整Change buffer区域大小,建议设置多大比较合理?1.4.24 Innodb 页的结构有哪些部分,都有什么作用?1.4.25 Innodb 存储引擎中的buffer pool 能介绍一下吗?1.4.26 链表和数组相比,链表和数组适用于的什么访问?1.4.27 SQL语句扫描行太多,回表次数太多如何解决?1.4.28 在执行器中是怎么生成的执行计划?1.4.29 MySQL的存储机制和MySQL的索引的存储机制?(mysql的表数据存在哪?索引数据在哪⾥?落到磁盘展现形式)1.4.30 缓冲池机制?1.4.31 缓冲池为了加快查询或写⼊速度,⼀般先写⼊缓冲池。那么缓冲池和磁盘之间的数据差异,通过什么样的机制去保证数据的⼀致性?1.4.32 你们⼀般将缓冲池设置成多少?你们的机器规格是多⼤?1.4.33 MySQL 的 Change Buffer 是什么?它有什么作用?1.4.35 索引树的高度多少合适?1.4.36 innodb的核心特性?日志1.5.1 如何配置开启通用日志,二进制日志,错误日志,慢查询日志?1.5.2 如何查看二进制日志1.5.3 binlog二进制日志有哪些格式?有什么区别?你们公司用什么格式?1.5.4 二进制日志如何切割1.5.5 二进制日志如何清理1.5.6 二进制日志相关配置有哪些?1.5.7 什么是双一配置?1.5.8 你是如何截取二进制日志的?与GTID 有什么不同点?1.5.9 如何配置慢查询?1.5.10 慢日志如何处理?慢日志在什么时候使用,如何用?1.5.11 数据库优化流程?1.5.12 慢日志的配置参数?1.5.13 SBR(statement-based replication)与RBR(Row-Based Replication)记录的优缺点分析 ?数据备份与恢复1.6.1 你在备份这块都做过什么具体工作?/你公司的备份策略?1.6.2 你们公司使用什么工具备份 / 备份策略?1.6.3 请介绍 mysqldump 核心参数:--master-data 和 --single-transaction 的功能?1.6.4 请简述 mysqldump 备份原理1.6.5 mysqldump 是否属于热备份?1.6.6 mysqldump 是否需要锁表?1.6.7 请介绍 xtrabackup 工具的备份原理1.6.8 晚上 23:00 开始备份 mysqldump 和 xtrabackup 两个工具理论上能将数据恢复至几点?1.6.8 xtrabackup 的增量备份是如何实现的?1.6.9 xtrabackup 增量备份恢复要注意什么?1.6.10 mysqldump 和 xtrabackup 备份如何实现基于时间点的恢复?1.6.11 请列举数据库数据损坏场景,然后针对性地提出最佳的恢复方案(假设具有多种类型备份)?1.6.12 如何实现分库分表,备份数据库中的表?1.6.13 数据库宕机没有全量备份,但有物理文件,如何恢复数据?1.6.14 delete 了数据库中一个表,如何恢复?1.6.15 备份方案中保存 3-7 天和 7-15 天的原因,依赖什么依据这么保存的?1.6.15 mysqldump 全备时如何保证数据的不丢失?mysqldump 全备时会对业务造成影响吗?1.6.16 (单表恢复)8:00全备了一张表,9:00误删除了一张小表,但有binlog,怎么恢复?1.6.17 生产中备份的文件50G数据库,误删除了一张 t1 表,10M大小,有什么思路可以快速恢复?1.6.18 进行独立表空间迁移时遇到没有提前保存表结构信息怎么办?1.6.19 进行独立表空间迁移时遇到数据库中有多张表如何批量进行迁移 (有多个库多个表)?1.6.20 为什么mysqldump 为什么不在第一次执行 flush tables 操作的时候加上锁呢?1.6.21 线上备份是怎么实现的?加什么参数?1.6.22 xtrabackup 备份过程中怎么确保数据一致性?在备份过程中有新增加的数据怎么办?新增加的数据有没有必要进进⾏备份?1.6.23 mysqldump 进行数据补偿后,新增加的数据怎么办?1.6.24 mysql的备份⽅式?备份⼯具?是否锁表?1.6.25 你们是怎么做数据恢复的?流程?⽤什么⼯具?(业务说⼏⼗万条数据删错了,你是怎么把它恢复回来)1.6.26 mysql运⾏到⼀半,遭遇断电宕机,在做恢复的时候怎么保障mysql缓冲池中的数据落盘或者不落盘的?可能缓冲池和磁盘数据不⼀致嘛?1.6.27 你这500G数据用什么工具备份,花费多长时间,恢复要多久?1.6.28 一张表使用mysqldump备份,用什么参数保证这三张表在同一时间备份数据?1.6.29 flush table 命令有什么作用?1.6.30 MySQL CR 恢复机制,是怎样恢复数据数据的 redo log 和 DoubleWrite buffer 是如何配合的?1.6.31 数据恢复方案?1.6.32 周日做的备份,昨天删除了drop了一张表,如何恢复,不知什么时间删除的?1.6.33 数据损坏了怎么恢复(断电了,误删了)?事务和锁1.7.1 MySQL 是如何实现事务的?1.7.2 什么是事务的 ACID?ACID 是如何保证的?1.7.3 MySQL 中长事务可能会导致哪些问题?1.7.4 MySQL 中的 MVCC 是什么?1.7.5 如果 MySQL 中没有 MVCC,会有什么影响?1.7.6 MySQL 中的事务隔离级别有哪些?1.7.7 MySQL 默认的事务隔离级别是什么?为什么选择这个级别?1.7.8 数据库的脏读、不可重复读和幻读分别是什么?1.7.9 什么是死锁?1.7.10 什么是快照读,什么是当前读?1.7.11 read-view 是如何判断当前事务的看见性的?1.7.12 幻读是怎样产生的,会造成什么问题?1.7.13 InnoDB是怎样在可重复读隔离级别下解决幻读的?1.7.14 简述 MySQL 中锁的种类及作用?1.7.15 MySQL 的乐观锁和悲观锁是什么?1.7.16 MySQL 中如果发生死锁应该如何解决,如何检测死锁?1.7.17 lock in share mode、for update、update、insert、delete分别上什么锁?1.7.18 MySQL的加锁原则能介绍一下嘛1.7.19 next-key lock加锁的过程是怎样的?1.7.20 MySQL 插入一条 SQL 语句,redo log 记录的是什么?1.7.21 MySQL 事务的二阶段提交是什么?1.7.22 redo log 重做日志作用 ?1.7.23 undo log 回滚日志作用 ?1.7.24 RC 和 RR 在构建 mvcc 的 read view 时有什么区别?1.7.25 Innodb 支持事务的原因?1.7.26 MVCC 中是如何判断其他事务是否可见?1.7.27 事务的持久性是如何实现的?主要参数是什么?1.7.28 为什么需要两阶段提交,那么如果没有两阶段提交,会发生什么呢?1.7.29 MySQL 如何监控长事务,避免长事务?1.7.30 如何解决幻读?1.7.31 MVCC 解决幻读了吗?1.7.32 MySQL为什么会需要redo日志,redo日志的特点和好处?1.7.33 如何理解undo日志?1.7.34 MVCC机制、事务隔离级别、undo、redo之间的相互作用?1.7.35 从数据操作角度锁分为哪几种?从数据粒度来划分,锁分为哪几种?1.7.36 死锁你是怎么监控?其他还有遇到过锁的?元数据锁?1.7.37 事务没有提交?事务的堵塞情况?事务运⾏多久?1.7.38 redo log占⽤磁盘太多是什么导致的?(⽐如说500G的实例,这个⽇志就占200G)1.7.39 单机的redo log是做什么的?集群1.7.40 什么时候redo log进⾏数据落盘?1.7.41 redo 和undo与双写⽂件之间的关系?1.7.42 mysql读视图概念1.7.43 间隙锁和意向锁?1.7.44 redo log和binlog⽂件写⼊顺序1.7.45 mysql DDL操作哪些方式不会锁表?1.7.46 直接先写完 redo log,再写 binlog,崩溃恢复后直接判断两个日志数据是否完整不就好了? 为什么还要分二阶段?1.7.48 MySQL 插入一条 SQL 语句,redo log 记录的是什么?1.7.49 插入操作 redo log 具体执行流程?1.7.50 死锁情况避免方法?1.7.51 插入操作 redo log 具体执行流程1.7.52 什么是事务?1.7.53 MySQL 死锁可以通过哪些视图检测到,如何手动Kill 死锁线程?主从复制与架构1.8.1 简述主从复制原理1.8.2 如何为运行了 2 年的数据库,构建一个从库(主从构建步骤)?请说明步骤?是否需要停主库?1.8.3 如何监控主从复制?请说明监控要点?1.8.4 请简述你遇到过的主从复制故障?分析、规避、处理?1.8.5 传统的主从复制是异步还是同步?会不会出现主从不一致?出现有什么好的方法解决或预防?1.8.6 延时从库的实现原理?主要可以解决什么问题?1.8.7 半同步复制实现原理?作用(解决主从数据最终一致性问题)1.8.8 请简述 MGR 的工作原理?Paxos 协议工作原理?1.8.9 如何处理 MySQL 的主从同步延迟?1.8.10 请介绍一下你们公司的数据库架构或什么是 MySQL 集群?1.8.11 请介绍你熟悉的高可用解决方案?1.8.12 请简述 MHA 的搭建过程?1.8.13 请介绍 MHA 重要的脚本及作用?1.8.14 请简述 MHA 高可用架构原理?1.8.15 MHA 如何选主?1.8.16 MHA 优缺点?1.8.17 请介绍你在维护公司 MHA 架构时主要做了哪些工作或遇到的问题?1.8.18 是否使用过分布式数据库架构?请说明你是如何设计的?1.8.19 简述 PXC(Percona XtraDB Cluster)高可用集群的工作原理1.8.20 简述 ProxySQL 读写分离操作步骤1.8.21 普通半同步与增强性半同步分别在哪个阶段返回 ACK?1.8.22 在配置读写分离架构中,下单了一件商品,查询订单时发现没有查寻到结果,说明主从同步还没有写入从库,怎么解决这种问题?1.8.23 构建多主 mysql 架构,多主同时写,用什么架构搭建?1.8.24 什么是双写(架构)?1.8.25 在跨版本搭建主从架构的时候,你遇到过哪些问题,如何解决?1.8.26 MHA 的探测机制?如何判断主库存活?如何判断MySQL库是否异常?1.8.27 克隆同步用过吗?克隆同步用来干什么的?1.8.28 克隆同步的原理?1.8.29主从同步中 如何实现同步过滤?1.8.30 同步过滤用过吗?有什么作用?1.8.31 主从中断,数据如何恢复?1.8.32 延迟从库有什么好处?1.8.33 如果主库宕机后,HA发⽣切换,这个HA是怎么做的判断?这个没有的⼼跳的机制解决⽹络层⾯或主机层⾯的问题?1.8.34 什么是GTID,在架构中主库宕机,从库当新主的时候。毕竟主的GTID比从要高,那么从库如何确保GTID?1.8.35 主库宕机了,哪个从库更接近主库,怎么判断?1.8.36 新主和从库数据不一致,怎么解决?1.8.37 主从复制是用GTID实现的吗?原理是什么?GTID起到什么作用?1.8.38 GTID复制的优点?⽐如说表⾥⾯没有主键怎么处理的?1.8.39 GTID出来以后为什么推崇使⽤GTID⽅式做复制1.8.40 ProxySQL读写分离是怎么配置?1.8.41 半同步什么时候会退化成异步?1.8.42 MHA哪个配置参数是不做候选主节点?1.8.43 ProxySQL能做到一主几从有限制吗?从库能做到负载均衡吗?1.8.44 如何让使用人员只能连接主库防止连接错误?1.8.45 延迟从库是怎么实现?有什么好处?1.8.46 MHA 哪个参数手动指定默认选主1.8.47 如何利用延时从库恢复数据?1.8.48 半同步要关注哪些参数?1.8.49 MHA 是如何检查主从数据不一致的1.8.50 proxy sql原理1.8.51 mha切换遇到过什么问题,manager在哪个节点,切换原理1.8.52 如何MHA 脑裂会产生什么影响?如何防止MHA脑裂?1.8.53 分库分表带来了哪些问题?1.8.54 半同步复制技术与传统主从复制技术不同之处?1.8.55 主从同步中哪些线程是多线程?1.8.56 SQL 相关参数有哪些,怎么修改SQL 线程数量?1.8.57 描述增强半同步复制和普通半同步复制的区别?1.8.58 MHA是怎么预防数据丢失的?1.8.59 MySQL 8.0 对死锁的优化?1.8.60 MySQL 如何实现读写分离?1.8.61 什么是读写分离1.8.62 mysql一个表上亿条的数据怎么保证同步过去,如何解决延时?1.8.63 使用延时同步恢复数据,比如延时5分钟,怎么保证你停止slave后,新的数据不会丢失1.8.64 MySqL 并行复制都有哪些 具体说说?1.8.66 MySQL 8.0 死锁检测视图有哪些?监控1.9.1 MySQL zabbix 你都监控哪些指标?1.9.2 现在有⼀个MySQL有很多慢查询,现在要通过监控,主要观察哪些指标?1.9.3 shell 脚本都监控那些指标?1.9.4 日常工作需要监控 MySQL 哪些指标?1.9.5 数据库集群监控信息?1.9.6 你平常如何监控锁状态的?1.9.7 数据库主从监控有哪些方式?数据库设计1.10.1 数据库范式有哪些?1.10.2 数据库的三大范式是什么?1.10.3 为什么要分库分表1.10.4 什么是分库分表?分库分表有哪些类型(或策略)?1.10.5 大厂数据库架构1.10.6 对数据库进行分库分表可能会引发哪些问题?优化1.11.1 CPU load 和 CPU使用率有了解吗?1.11.2 集群的稳定性的优化都有哪些方法?1.11.3 MySQL 的碎片是怎么优化的?1.11.4 你观察到⼀个表/库性能下降,现在的引擎已经是innoDB引擎了如何做优化?(你们当时是在什么规格的数据库上,有多少条数据,然后导致性能下降)1.11.5 在mysql出现性能问题的时候,你是怎么处理的?性能优化案例1.11.6 MySQL的CPU使⽤率100%,你会怎么处理?1.11.7 某⼀个库导致性能慢,你怎么处理?1.11.8 SQL语句的优化你是怎么优化的?有遇到没有⾛索引的情况?1.11.9 对于大表你们以前是怎么做优化?1.11.10 单表多大合适?1.11.11 怎么测试mysql的性能?1.11.12 怎么提升mysql的性能?1.11.13 MySQL中SQL语句执行慢的排查过程?以及对应怎么进行处理?1.11.14 MySQL会做哪些性能优化设置?1.11.15 为什么创建视图可以提升性能?1.11.16 MySQL8.0 中默认连接数是多少?除了调整连接数 如何优化连接数?1.11.18 MySQL数据库负载高如何处理?1.11.19 numa 是什么? 为什么要关闭?1.11.20 THP 是什么? 为什么要关闭1.11.21 一张很大的表,现在要对这个表结构进行更改,你要怎么做 PT1.11.22 一条语句执行有问题了,怎么看出来的?数据库升级与迁移1.12.1 你们的升级是怎么升级的?遇到过哪些故障?1.12.2 你做过异构数据库之间的数据迁移吗?(我操作的Redis-mysql)迁移过程中字符集有影响吗?1.12.3 如何实现数据库的不停服迁移?1.12.4 MySQL 如何进行数据迁移?1.12.6 数据库中有张表,怎么移出这张表?故障排错1.13.1 你最近遇到哪些案例 说一下 你工作中印象最深的一个故障案例 ?1.13.2 你有没有遇到过MySQL本身有问题?比如写法有问题,你遇到过吗?1.13.3 在工作中,你是如何发现bug的,什么样算bug,你们是怎么处理的?1.13.4 在日常维护高可用架构的时候,你发现过哪些问题?1.13.5 工作中遇到哪些主从延时问题,你是怎么解决的?1.13.6 主从架构你遇到过什么问题?1.13.7 主从同步中 slave_IO 出现错的代码你都见过哪些,都是什么问题,你是怎么处理的?1.13.8 mysql的逻辑和物理备份 哪个流程你更清楚?请具体说一个备份方式的流程?1.13.9 客户说11.30 分的时候我删除了一张表,你怎么给他恢复?1.13.10 遇到的问题,以及解决方法?1.13.11 你遇到过mysql进程突然没了或突然重启了?如何排查1.13.12 oom了解吗?(内存溢出)1.13.13 使用pt工具遇到过哪些故障?1.13.14 数据库内存飙高如何处理?1.13.15 有没有遇到内核上的问题无法解决的?1.13.16 mysql 引起cpu很高的原因?1.13.17 从库出现 slave 延时你是如何处理的?(魏)1.13.18 安装部署时遇到过什么故障?1.13.19 数据库版本升级时遇到过什么故障?1.13.20 数据库连接不上,可能原因是什么,如何排查?1.13.21 连接数设置不生效,最多为214,是什么原因?1.13.22 http 409错误,达到连接数上限。可能是什么原因导致?1.13.23 在做DDL操作时,数据库夯住了,原因是什么?1.13.24 一条SQL语句,昨天执行很快,突然变慢可能是什么原因?1.13.25 Ibdata1共享表空间文件损坏,导致数据库无法启动,备份也失效,有什么好的解决思路1.13.26 基于binlog+gtid方式截取的日志无法正常恢复,是什么原因导致?怎么解决?1.13.27 使用mysqldump方式构建主从,添加了-- set-gtid-purged =off导致主从构建失败?1.13.28 由于宕机,导致主从数据不一致,如何解决?1.13.29 Zabbix监控2000+台主机,监控显示缓慢,每隔三四个月重新搭建,存储空间经常被占满1.13.30 有规律的一段时间,会产生性能低谷1.13.31 过度条带化导致的性能问题1.13.32 MySQL 连接长时间(7200和1200秒)无法释放1.13.33 开启QC ,导致性能降低。 QPS ,TPS降低 是为什么?安全1.14.1 MySQL 安全方面你是如何优化的?Linux 与 Shell1.15.1 看内存⽤什么命令?看磁盘⽤什么命令?1.15.2 shell脚本都监控那些指标?1.15.3 grep命令1.15.4 awk命令1.15.5 sed命令NOSQL1.16.1 你们公司Redis的是什么架构?1.16.2 Redis的故障案例?1.16.3 Redis 集群(哨兵)的原理?如何搭建哨兵集群?1.16.4 Redis 怎么搭建主从?主从搭建的过程?怎么产生主从关系?1.16.5 Redis 集群执行slaveof以后,发生了什么?1.16.6 Redis你们⽤来⼲什么?⽤做过分布式锁?1.16.7 Redis你们平常都会监控什么指标?1.16.8 Redis的内存是怎么监控的?1.16.9 redis 用的什么版本 rdb和aof的优缺点?1.16.10 Redis持久化方式有哪些?有什么区别?1.16.11 redis存储原理?1.16.12 在Redis缓存服务中,常用的数据类型有哪些?1.16.13 MongoDB中oplog的作用是什么? 写满后会怎样?1.16.14 redis 淘汰策略有哪些?1.16.15 请简述redis数据类型及应用场景?1.16.16 请简述redis事务和MySQL事务的区别?1.16.17 请简述redis主从原理1.16.18 请简述redis sentinel(哨兵)高可用实现原理?1.16.19 请简述redis cluster分布式集群实现原理1.6.20 redis 集群用的什么协议??1.6.21 redis 的数据类型,业务用到了哪些,怎么做的?云数据库1.17.1 阿里云或者AWS的RDS使用过程中遇到的问题?1.17.2 你对阿⾥云的RDS有了解过或者使⽤过吗1.17.3 阿里云的DTS 你有使用和了解过吗?容器1.18.1Docker,部署MySQL,会遇到什么问题(在⽣产中)?1.18.2 实现docker持久化,通过什么实现?其他数据库1.19.1 Oracle加⼀个字段就很快,MySQL却很慢?(同样是千万⾏的表)1.19.2 分布式数据库ob架构?1.19.3 OB是怎么将数据分布式存储的?工作经验1.20.1 个人及家庭状况1.20.2 现处城市1.20.3 未来发展规划1.20.4 公司规模1.20.5 业务架构与规模1.20.6 你们的一套MySQL的qps是多少?(几百)1.20.7 你们一台物理机是部署一个MySQL还是多套?因为是多实例的,有遇到过实例之间的影响案例吗?1.20.8 数据规模?(单台实例数据量大小)1.20.9 MySQL使用的版本和规模?5.7.26 8.0.22?1.20.10 工作中运维的数据库集群是什么类型的?1.20.11 mysql 流量你怎么用监控软件监控的?1.20.12 用户部署了套新架构,你怎么给用户做监控,监控哪些指标?1.20.13 mysql数据库升级,你常用的是哪个数据库版本的升级?1.20.14 你们负责数据的ddl和dml的数据发布吗?1.20.15 DBA应该有哪些品质?如何当好DBA?1.20.16 你做的好的地方有哪些?1.20.17 你用过Oracle吗?1.20.18 DBA 工作职责是什么?1.20.19 DBA 工作内容1.20.20 公司几个dba怎么分工1.20.21 mysql你遇到⽐较严重的问题,收到什么告警,怎么解决的?1.20.22 binglog 被运维删了,你怎么办?1.20.23 在不影响业务的情况下怎么进行delete操作,使用的是什么?1.20.24 你们公司mysql灾难恢复 机制是怎样的1.20.25 公司用的什么服务器,配置什么样1.20.26 接手一个新的项目,怎么很快的开展工作?1.20.27 数据库规模有多大,存储量情况,QPS数值 TPS数值?真实面试题腾讯一面工作中运维的数据库集群是什么类型的MySQL使用的版本和规模?5.7.26 8.0.22MySQL 5.7 和 8.0 的区别?索引的优化?MySQL 的索引用的那种?B+ TREE 和 B TREE 的区别 B+TREE 有什么好处?链表和数组相比,链表和数组适用于的什么访问?MySQL 存储引擎有哪些?Innodb 和 MyISAM 有什么区别?Innodb 支持事务的原因?Innodb 的MVCC 原理?MVCC 中是如何判断其他事务是否可见?MVCC 是判断哪些版本可以访问?idb 和 frm 文件是什么?如何从 frm 中提取表结构?ibdata 和 ib_log_file 放的什么?工作中遇到哪些主从延时问题,你是怎么解决的?某外包二面你们公司生产环境中,什么样的情况算bug,bug是怎样发现怎么处理的,你又是如何收到这些bug的?如何形成闭环?在日常维护高可用架构的时候,你发现过哪些问题?你用过Oracle吗?你在公司中使用的什么版本的mysql?你在工作中主从架构遇到过哪些问题?英姿舞动(上海)之前在别的城市为什么来上海?MHA 的流程 和 探测机制?mysql的逻辑和物理备份 哪个流程你更清楚?请具体说一个备份方式的流程?xtrabackup 备份原理和流程你说一下?acid 是什么?事务的隔离级别有哪几个?客户说11.30 分的时候我删除了一张表,你怎么给他恢复?mysql数据库升级,你常用的是哪个数据库版本的升级?mysql从5.6 升级到5.7 是不是大版本升级?你做的好的地方有哪些?redo 和 undo 的区别?用户部署了套新架构,你怎么给用户做监控,监控哪些指标?mysql 流量你怎么用监控软件监控的?双照科技一面(银行外包)公司是甲方还是乙方?有没有驻场经验?有没有做过数据迁移?是从哪里迁移 mysql迁移到mysql 还是别的数据库迁移到另一个数据库?迁移是怎么做的?shell 和 python 的开发技能怎么样?如果运维数据库中,有客户反应sql很慢?很卡 你排查的思路?实际中遇到的慢查询的经典案例?部署主从的必要条件?主从用途是什么?你有没有部署过主从?主从部署的时候主库要做什么操作配置从库要做什么配置?mysql千万级的大表怎么优化?之前有做过这个方面的经验吗?过多的索引有什么问题?我创建了索引但是不走索引可能有哪些原因?如何理解死锁,如何避免死锁?如何检测死锁?上海某公司一面(外包 到金融服务,证券公司)你之前在公司使用的数据库架构是怎样的?MHA 了解过吗?MHA的探测机制?如何判断主库存活,如何判断MySQL库是否异常?MHA 会去检查 MySQL 进程正常吗?(主动去查询,和插入数据去探测)MGR有了解过吗?复制原理能说一下吗?慢查询的思路?如何有个客户说CPU比较高,你是怎么定位到是哪个SQL? 造成的 top mysql - 线程mysql 执行计划你是怎么看的?mysql 隔离级别,你能说一下吗?什么是RR 级别?主从同步的流程?如何搭建的?如何使用主从同步延时恢复数据?你在项目中怎么使用的?你常用的mysql备份是怎么做的?xtrabackup 备份流程是怎样的?是否了解过 oceanbase TIDB openguass;上海某公司一面面试公司黑名单面试技巧回答文本尽量全面熟悉的技术问题,不要一次性所有相关知识都说清楚,保留一部分让面试官去问面试回答问题最好结合业务去回答,可以举一些例子
基础面试题
1.1.1 MySQL 安装方式有哪些,你们公司用的哪个方式,为什么?
| 安装方式 | 速度 | 能否定制 | 能否解决依赖 | 复杂度 |
|---|---|---|---|---|
| Yum | 快 | 不能 | 是 | 最简单 |
| rpm | 慢 | 不能 | 否 | 复杂 |
| 二进制 | 较快 | 简单定制 | 简单 | |
| 源码 | 最慢 | 完全定制 | 最复杂 |
1.1.2 关系型数据库与非关系型数据库的区别?
关系型数据库: 具有复杂功能性,追求数据一致性,但降低了性能和可拓展性
非关系数据库: 具有超高的性能(内存特性),可拓展性,使用灵活,同时降低了数据一致性与关系型数据库互补
1.1.3 MySQL 5.6,5.7/8.0 版本安装过程有什么区别?
初始化命令路径,命令区别
5.6:
/usr/local/mysql/scripts/mysql_install_db5.7及其以上:
/usr/local/mysql/bin/mysqld
不同的初始化参数
5.6 无初始化参数
5.7 及其以后:
--initialize生成随机密码放在MySQL日志文件中 默认安装的话在/var/log/mysql/目录中--initalize-insecure密码为空
1.1.4 MySQL 5.7,8.0 在用户管理功能上有什么区别,请举例说明
5.7:
创建用户和授权可以用一条命令解决 (给用户授权的时候可以直接创建用户)
grant all on *.* to oldboy@'10.0.0.%' identified by 'oldboy123';密码加密插件:
mysql_native_password
8.0:
创建用户时必须先创建用户再授权
引入了角色机制
密码加密方式
caching_sha2_password增加了可以锁定账户的功能
1.1.5 请描述 MySQL 的授权表有哪些,都有什么作用?
mysql.user存储全局权限 (用户全局权限,创建用户,管理服务)mysql.db记录数据库级别权限,控制用户对特定数据库的操作权限(如 SELECT INSERT)mysql.tables_priv存储表级权限(如对某张表的增删改查权限)mysql.colums_priv记录列级权限(如仅允许用户修改某表的特定列)mysql.procs_priv管理存储过程和函数的权限(如执行或修改存储过程的权限)mysql.proxies_priv控制代理用户权限(允许用户以其他用户的身份执行操作)mysql.global_grants存储动态全局权限(如角色管理、审计相关权限)
1.1.6 简述你在工作中使用 MySQL 连接的方式?
本地连接
利用套接字文件连接 (客户端加载socket文件 =(路径/名称)= 服务端创建socket文件)
远程连接 (利用TCP/IP协议)
利用客户端命令进行连接
mysql登录访问服务端命令mysqladmin登录管理服务端命令 (密码 运行状态)mysqldump登录保存服务端数据
利用客户端工具进行连接
MySQL workbench
Navicat
1.1.7 MySQL 的配置文件标签有哪些?(my.cnf)
客户端标签:影响客户端连接命令,可以省略命令参数信息 (加载客户端标签信息 不用重新启动服务)
全局标签:[client] 局部标签:
[mysql][mysqladmin][mysqldump]
服务端标签:影响数据库服务功能(使配置生效需要重启服务)
全局标签:
[server]局部标签:[mysqld][mysqlserver][mysqld_safe]
1.1.8 MySQL 忘记root 用户密码怎么办?
关闭数据库服务 (需提前联系通知用户和相关业务部分)
/etc/init.d/mysqld stop
采用安全模式启动数据库 (跳过授权表,停止网络连接)
mysqld --skip-grant-tables --skip-networking &
重置密码信息
flush privileges;-- 重新将磁盘授权表加载到内存中`alter user root@'localhost' identified by '012012';
重新正常启动
pkill mysql/etc/init.d/mysqld start mysql -uroot -p012012
1.1.9 在公司中一般给开发,运维,管理员授予什么权限
针对管理员设置权限:DBA
grant all on *.* to xiaoA@'localhost';如果需要给其他用户授权需要再授予一个grant option
grant all on *.* to xiaoA@'localhost with grant option';针对运维人员设置权限:SA
grant Alter,Create,Delete,Drop,Insert,Select,Update on www.* to xiaoB@'localhost';针对开发人员设置权限:DEV
grant Delete,Insert,Select,Update on www.t1 to xiaoC@'localhost';
1.1.10 请列举 MySQL 配置文件的读取顺序?
xxxxxxxxxx/etc/my.cnf ➔ /etc/mysql/my.cnf ➔ /usr/local/mysql/etc/my.cnf ➔ ~/.my.cnf1.1.11 请列举 MySQL 启动和关闭方式?
启动
使用
systemctl使用
/etc/init.d/mysqld使用
support-files/mysql.server
关闭
使用
systemctl使用
/etc/init.d/mysqld使用
support-files/mysql.server使用
kill使用
mysqladmin -u*** -p*** -S *** shutdown(推荐)
1.1.12 你们公司使用多实例环境吗?在什么地方用的?
业务量、并发量小的业务,且项目多,要求相对物理隔开
测试环境大量使用
1.1.13 如何查看数据库当前连接情况
xxxxxxxxxxSHOW PROCESSLIST;1.1.14 简述数据库启动不了,如何排查?
错误日志排查:
log_error=对应路径/主机名手工启动检查:
mysqld --defaults-file=/etc/my.cnf初始化数据库(不推荐轻易操作)
1.1.15 数据库连接不上如何排查?
确认网络连通性
数据库端口检查 (
telnet,nc,nmap)
确认网络硬件设备
路由器,交换机,防火墙
确认服务端配置
检查是否创建了用户信息和密码
检查用户登录白名单
确认客户端配置
检查输入用户信息
检查输入密码喜喜
检查密码加密方式(旧版本客户端加密使用
mysql_native_password)
1.1.16 MySQL常用数据类型有哪些
字符类型
char
varchar
整型
tinyint微小整数 1个字节 范围(-128~127) 范围(0~255) 2的8=256smallint小型整数 2个字节 范围(-32768~32767) 范围(0~65535) 2的16=65536mediumint中型整数 3个字节 范围(-8388608~8388607) 范围(0~16777215) 2的24=16777216int标准整数 4个字节 范围(-2147483648~2147483647bigint 大型整数 8个字节 范围(+-9.22*10的18次方)
浮点型
float单精度浮点类型 可以保留的小数位最多 6double双精度浮点类型 可以保留的小数位最多 17decimal定点数类型 可以自定义
日期类型
date日期类型 存储年月日time时间类型 存储小时分钟秒datetime日期时间类型 存储年月日 小时分钟秒 1000~9999timestamp日期时间类型 存储年月日 小时分钟秒 1970~2037
ENUM 枚举类型
SET集合类型
。。。。。。。
1.1.17 MySQL 约束有哪些?
主键约束
唯一约束
非空约束
外键约束
1.1.18 MySQL 列的属性设置有哪些?
default设定默认数据信息,可以实现自动填充auto_increment设定数值信息自增,可以实现数值编号自增填充(一般配合主键使用)comment设定数据注释信息unsigned设定数值信息非负,可以实现数值信息列不能出现负数信息
1.1.19 MySQL 如何设置自增列 自增列是否可以自定义起始值
alter table test02 auto_increment=100;auto-increment-increment=100此配置项影响自增的间隔数值,默认为1 2025110001
1.1.20 MySQL 自增列的范围?
自增列数值自增范围: 根据表字段数据类型定义
tinyint(0~255)
1.1.21 MySQL服务模式有哪些常用参数,什么时候会用到?
参数:
only_full_group_by禁止一行信息对应多行信息显示输出(在表进行分组处理时)strict_trans_tables录入的数据信息,超过数据类型的限制后,会自动录入失败no_zero_in_date,no_zero_date录入的日期信息,不可能出现0000-00-00errror_for_division_by_zero当出现数值运算。,不能出现除数为0
应用场景:
低版本数据库中
sql_mod配置信息更简单,更不完善,当低版本数据库迁移到高版本的时候,(逻辑迁移)会出现失败迁移时,将高版本数据库服务的sql_mode功能关闭,再进行数据迁移绕开
sql_mod可以使用物理迁移(set global sql_mode='')
1.1.22 MySQL 查询表中数据中文字体乱码,原因可能是什么?如何修改?
原因:
字符集不一致导致:
操作系统级别
操作系统客户端级别
MySQL 实例级别
库级别
表级别
列级别
MySQL 客户端
开发端(如 Java/Python 等程序连接)
修改方法:
查看字符集
SHOW VARIABLES LIKE 'character_set%';修改字符集 在
/etc/my.cnf中修改服务端和客户端配置
1.1.23 什么是实例
实例 =
mysqld+ 线程(master thread,IO, SQL,purge)+ 内存结构 + 磁盘结构
1.1.24 简述 MySQL 程序结构?
客户端连接器 → MySQL 服务层 → 存储引擎层 → 文件系统层
1.1.25 简述一条 select 语句的执行过程?
先通过连接器校验用户身份,权限 处理客户端的请求;
利用分析器进行SQL语句的词法分析和语法,语义分析,构建解析树;
使用优化器生成多个执行计划,评估执行计划的成本,选出最优的执行计划交给执行器
利用执行器,通过API接口调用引擎层查询数据,返回结果集给客户端
1.1.26 请简述 MySQL 逻辑结构和宏观物理结构?
逻辑结构:
实例
库:库名/库属性(字符集,校对规则)
表:列(列名 + 列属性)+ 行(元数据 + 数据)+ 表属性 + 表名
宏观物理结构:系统上库对应数据库库名及目录
1.1.27 请简述段、区、页的构成
一个段由多个区构成。
一个区由连续 64 个页构成,每页 16k
一个段约1M大小
1.1.28 你们公司用的 MySQL 版本,为什么选择?
版本选择:
5.7.22 或 5.7.30 或 5.7.36
8.0.22 使用较多,将成为主流
1.1.29 数据库文件损坏最大原因?
kill -9强制关闭数据库引起数据丢失损坏突然断电
磁盘坏道
1.1.30 MySQL 用户安全规范
主机域范围尽量小,最好细化到单一 IP,本机用
localhost禁止使用
%模糊匹配授权用户名应有实际意义,一目了然
删除无用用户
密码复杂性
为每个项目设置一个对应用户,禁止使用
root用户作为项目用户
1.1.31 授权权限 3 条红线
授权一定不用
all,而是select, insert, update, delete权限库表不用
*.*,而用oldboy.*格式具体到库主机域不要用
%,而应用内网的 IP 网段,如172.16.1.%
1.1.32 inplace 升级至 5.7、8.0,升级方式上有什么区别?8.0要注意什么 ?
5.6升级5.7
本地升级 (
Inplace) 必须进行业务中断 需要提前告知用户中断时间创建MySQL 5.6 版本实例 (安装部署)
创建测试数据
下载部署5.7数据库程序
提前部署新版本5.7 数据库多实例
进行原有5.6 数据库数据备份(
mysqldump xbp克隆本地)mysqldump和 xbp 恢复速度太慢了 建议选择 克隆备份重新编写配置文件,实现数据库升级(挂库升级 让)basedir5.6 和basedir5.7 数据目录上进行关联
进入mysql.5.7 的配置文件 修改
datadir修改启动端口为56实例的端口以安全模式启动数据库服务(5.7)
mysqld --default-files=/data/3357/my.cnf --skip-grant-tables --skip-networking避免无法正常启动启动成功时会出现报错(表结构错误)但是不用管,可以正常进入数据库
usr/local/mysq57/bin/mysql_upgrade -S /tmp/mysql3357.sock /tmp/mysql3357.sock --force重新启动mysql5.7
进行升级后数据库备份 (mysqldump)
异地升级(Merging)不停止业务进行数据库升级
需要在新的数据库节点安装mysql5.6 程序 (实现主从同步)( 5.6 直接和5.7 简历主从会出现数据无法正常加载)
在从节点安装部署新版本5.7 数据库服务
在从节点上实现 5.6 到5.7 的挂库升级
重新启动5.7 数据库程序,和主库进行数据同步(此时再同步就是业务库信息)
利用MHA高可用服务,实现手工切换主节点
可以再将其他节点依次进行升级
5.7升级8.0
mysql 8.0 以安全模式启动的时候会自动的去调整表结构 其余步骤与上面一样
注意事项
5.7.30 -- 8.0.36
数据库服务版本升级时,只支持在GA(General Availability)版本之间进行升级
数据库服务版本升级时,支持从数据库5.6到5.7再到8.0,跨版本升级,但是需要先将5.6升级到最新小版本,在进行跨版本升级
数据库服务版本升级时,需要提前考虑好版本回退的方案,最好升级前做好数据备份(特别是向8.0版本升级)
数据库服务版本升级时,制定的升级方案和升级步骤,需要尽可能降低数据库服务停机的时间 数据库服务官方参考资料:https://dev.mysql.com/doc/refman/8.0/en/upgrade-paths.html
1.1.33 MySQL 中 TEXT 类型最大可以存储多长的文本
TINYTEXT: 最大存储 255 字节(约 255 个字符)
TEXT: 最大存储 65,535 字节(约 64 KB)
MEDIUMTEXT: 最大存储 16,777,215 字节(约 16 MB)
LONGTEXT: 最大存储 4,294,967,295 字节(约 4 GB)
1.1.34 MySQL 中 AUTO_INCREMENT 列达到最大值时会发生什么?
当 MySQL 中 AUTO_INCREMENT 列达到其数据类型的最大值时,插入操作将失败,并返回一个错误
1.1.35 MySQL 中 EXISTS 和 IN 的区别是什么?
在执行机制和性能上有区别
EXISTS是检查子查询是否有结果返回,返回布尔值。而IN则是判断某个值是否在子查询的结果集中。IN的执行过程是先执行子查询,得到一个结果集,然后主查询再和这个结果集做匹配。而EXISTS则是主查询的每一行都去执行子查询,直到找到匹配项就停止,也就是所谓的“短路”机制
性能方面,当子查询结果集大时,用EXISTS更好,因为EXISTS一旦找到匹配就会停止,而IN需要处理整个结果集。相反,当子查询结果集小,主表大时,IN可能更高效,因为可以利用索引。比如,如果子查询结果集小,IN可以快速匹配,而EXISTS需要对主表每一行都执行子查询,可能更慢
IN在内外表都可能用到索引,而EXISTS主要在子查询(内表)使用索引。比如,当子查询表有索引时,EXISTS的效率会更高,因为它可以快速定位到匹配行
NOT EXISTS通常比NOT IN效率高,因为NOT IN会对内外表都做全表扫描,而NOT EXISTS可以利用索引,特别是在子查询结果集大的时候
1.1.36 MySQL数据库的优缺点?
优点:
体积小,开源,且支持多种操作系统,大型数据库,具有稳定性,同时具有高度多样性(命令行客户端操作,网页浏览器,及各种程序语言,C+,Java)可用于Windows,Linux
缺点:
不支持热备,数据读写比经过sql解析,大量数据,高并发下读写能力不足
数据读写时或修改数据结果时需要加锁,影响并发操作
1.1.37 什么是隐式转换?
隐式转换也叫自动类型转换,指不需要书写代码,由系统自动完成的类型转换
1.1.38 MySQL 怎么查看系统资源(内存,CPU)?
在操作系统层面,用 free 命令查看系统内存资源使用情况,用 top-c 命令查看进程使用内存占用情况
1.1.39 数据库启动时间与哪些因素有关?
硬件因素: CPU,内存,磁盘IO,网络
操作系统: Linux
数据库引擎: innodb 文件系统采用XFS
数据库配置参数:
1.1.40 有一个 8核心 16g 服务器,活动会话数达到多少个会不正常?
正常:3,4,5 个。满配 8 个。不正常:1 倍或 1.5 倍
1.1.41 MySQL 如何管理用户连接的?
查看用户连接
show processlist# 查看系统连接用户信息max_connections# 最大连接数,如果达到最大连接时,会给管理员一个额外名额去连接这里的管理是指root 或授权时赋予 all 的用户
1.1.42 MySQL 5.7 和 MySQL 8.0 有哪些区别?
字符集
8.0 默认使用 uft-8
5.7 默认使用 lantin
用户管理
8.0加入了角色机制
8.0 创建用户时必须先创建用户再授权 5.7 可以授权的时候直接创建用户
增加了可以锁定账户的功能
移除PASSWORD()函数。这就意味着无法通过“SET PASSWORD..=PASSWORD(auth_string)“命令修改用秦户密码
密码插件
5.7 采用了
mysql_native_password加密8.0 采用了
caching_sha2_password加密方式
索引机制
隐藏索引:8.0 开始支持隐藏索引,不可见索引不会被优化器使用,但仍需维护
降序索引:8.0 开始真正支持降序索引
隐式索引:不再对
GROUP BY操作进行隐式排序函数索引:支持在索引中使用函数计算后的值
缓存
MySQL 8.0 不再支持查询缓存,因为之前的查询缓存命中率太低了(必须SQL语句一模一样)
主从信息表
mysql 8.0 中取消了master.info 文件 改用 slave_master_info表存储主库信息
通过参数可以修改库信息存放方式 master_info_repository table/file
表空间文件
mysql 8.0 使用了 idb 存放表空间和表结构
mysql 5.7 使用了idb 存放数据 .frm 存放表结构
双写文件缓冲区
mysql 8.0 将 double write buffer 放到了独立的空间
mysql 5.0 将 double write buffer 放到了系统表空间
在MySQL 5.7版本中,只能通过重启以实现主节点的自动切换,不能手动切换
MySQL 8.0 自增主键的持久化
MySQL 8.0 对redo log 进行大改 可以并行写入redo log
MySQL 8.0 从库并行回放加入了 Writeset
MySQL 8.0 undo log 可以在线调整 undo log 数量
MySQL 8.0 默认的内存临时表由MEMORY引擎更改为TempTable引擎,相比于前者,后者支持以变长方式存储VARCHAR,VARBINARY等变长字段
MySQL 8.0 新增 LOCKINSTANCE FOR BACKUP
MySQL 8.0 新增 performance_schema.data_locks 和 data_lock_waits 表
1.1.43 MySQL 5.6 和MySQL 5.7 有什么区别?
MySQL 从 5.6 版本开始支持多线程复制 BinLog
在 MySQL 5.6 中引入了 BLGC (Binary Log Group Commit),这有助于提高并发提交性能
到 MySQL 5.7,进一步增强了多线程复制的功能,使得可以在 Slave 上实现真正的多线程并发复制,不再局限于同一 Schema 下的不同表之间的并行处理
1.1.44 MySQL 从5.6 升级到5.7 是不是大版本升级?
是大版本升级 从5.7 以后 MySQL大版本升级版本号为 8 9 10 依次命名
1.1.45 MySQL 数据库升级,你常用的是哪个数据库版本的升级?
mysql 5.7 升级 mysql8.0.22 现在的话(2025)推荐 升级到8.0.35 因为bug少更加稳定
1.1.46 idb 和 frm 文件是用来干什么?
idb 表空间文件,用于存放数据
frm 文件是用于存储表数据和元数据的关键文件
1.1.47 ibdata 和 ib_log_file 放的什么?
ibdata
InnoDB 表的元数据:这是指关于表结构的信息。
Undo Logs:用于回滚未提交的事务以保持数据库的一致性。
Change Buffer:优化非唯一二级索引更新操作的一种机制。
DoubleWrite Buffer:一种提高崩溃恢复性能的安全措施,在写入主数据之前先将其复制到一个临时区域
ib_log_file 是 redo 日志文件的一部分
1.1.48 你们一台物理机是部署一个MySQL还是多套?因为是多实例的,有遇到过实例之间的影响案例吗?
1.1.49 哪些不是活跃连接?用什么语句看?
show processlist
状态是sleep 的就是 不活跃的
1.1.50 MySQL 碎片信息怎么看?
通过
information_schema.TABLES表查看data free字段
1.1.51 mysql结构体系和工作原理?
1.1.52 mysql 8.0 新特性
SQL
1.2.1 请简述select语句的各个子句的执行顺序?
From→on→join→where→group by→having+聚合函数→select→order by→limit
1.2.2 请列举 SQL 语句的种类和代表命令?
DDL:数据定义语言,对元数据修改,create创建,alter修改,drop删除
DCL:数据控制语言,权限,数据提交grant用户授权,revoke权限回收,commit提交,rollbake回滚
DML:数据操作语言,表内容处理update,delete,insert
DQL:数据查询语言,表内容查询select
1.2.3 请简述SQL_MODE的作用?ONLY_FULL_GROUP_BY是干什么用的?
Sql_mode是对SQL语法控制和校验的一套规则 用于保证数据录入的合理性Sql_mode对group by的控制:only_full_group_by是控制select语句中带group by子句的检测,要求select后的选择列,要么是group by的条件,要么是通过聚合函数处理,否则语句就会报错
1.2.4 SQL_MODE 的常用参数,什么使用应用这些参数?
参数
only_full_group_by 禁止一行信息对于多行信息显示输出(在表进行分组处理时)
strict_trans_tables 录入的数据信息,超过数据类型的限制后,会自动录入失败
no_zero_indate,no_zero_date 录入的日期,不可能出现 0000-00-00
error_for_division_by_zero 当出现数值运算的,不能出现除数为0
应用
正常不做更变,常用于数据库版本升级(低版本向高版本升级,会临时清空 sql_mod 变量)
1.2.5 请简述MySQL utf8和utf8mb4区别?
utf8mb4字符范围大于utf8,utf8实际是utf8mb3,是utf8mb4的子集
utf8一个汉字占3个字节,utf8mb4一个汉字占4个字节
8.0默认字符集是utf8mb4,8.0之前默认latin1,但常修改为utf8字符集
1.2.6 请简述tinyint、int、bigint 如何计算的存储位数?
| 列类型 | 存储容量 | 说明 |
|---|---|---|
TINYINT | 1 byte | 最大 3 位数 |
INT | 4 bytes | 最大 10 位数 |
BIGINT | 8 bytes | 最大 20 位数 |
1.2.7 请简述 CHAR(10) 和 VARCHAR(10) 区别,生产如何选择?并阐述为什么?
不同点:
CHAR(10):定长,浪费存储空间,但作为条件列查询会更快。VARCHAR(10):变长,节省空间。
相同点:
都是字符串类型
生产选择:
定长列选择
CHAR。变长列选择
VARCHAR。
1.2.8 请简述 DATETIME 和 TIMESTAMP 区别?
存储空间:
TIMESTAMP:占用 4 个字节。DATETIME:占用 8 个字节。
存储范围:
DATETIME:范围更大。TIMESTAMP:有时间限制。
时区:
TIMESTAMP:受时区变化影响。DATETIME:不受时区变化影响。
1.2.9 什么是数据库的视图?
数据库的视图是一种虚拟表,其内容由查询定义。视图并不是实际存储在数据库中的数据集合,而是基于一个或多个现有表(称为基表)构建出来的动态结果集。每次使用视图时,都会执行定义视图的那个查询语句来获取最新的数据。
1.2.10 请简述你们数据库开发过程,选择数据类型的规范是什么?
数字类型:
分类:整数、浮点数(小数放大 n 倍存储)。
字符串类型:
CHAR:固定长度。VARCHAR:变长。
时间类型:
DATETIMETIMESTAMP
选择规范:
变长列选择
VARCHAR定长列选择
CHAR不在数据库中存储图片等二进制数据
将字符转化为数字存储(例如:IP 存储使用
INT无符号存储)1.2.11 请列举你了解的数据库的约束有哪些?他们的特点是什么?
PRIMARY KEY (PK):
设置在主键列,非空且唯一,用于必填且不能重复。
NOT NULL:
表示列的内容是否非空,空列不利于数据库优化。
UNIQUE KEY (UK):
表示列的内容唯一(例如:手机号)。
FOREIGN KEY (FK):
表示表的外键,用于多个表之间的关联。
CHARSET_NAME:
指定表的字符集,默认是
utf8mb4。
1.2.12 请简述你们公司在 Schema 设计过程中有哪些开发规范?
库的 DDL 规范:
禁止线上业务系统出现
DROP操作。显示设置字符集。
库名不能大写字母,不能是关键字,不能以数字开头,一般与业务有关。
表的 DDL 操作规范:
列名要与业务有关。
列的数据类型讲究:完整、简洁、合适、精度不高浮点数,n 放大 n 倍。
每列要有注释。
更改数据库需要在数据库低谷时间点进行。如果紧急,使用
pt-osc或gh-ost
1.2.13 请简述 DROP TABLE、TRUNCATE TABLE、DELETE FROM TABLE 的区别?
| 序号 | 操作命令 | 解释说明 |
|---|---|---|
| 01 | Delete | 用于删除行数据,但保留表结构和相关的对象; |
| 02 | Truncate | 只删除数据,不会删除表结构和索引等其他结构; |
| 03 | Drop | 用于完全删除数据库表,包括数据和结构; |
从性能来看,Drop>Truncate>Delete
Delete
本质上这个删除其实就是给数据行打个标记,并不实时删除,因此delete之后,空间的大小不会变化。
而且delete操作会生成binlog、redolog 和 undolog,所以如果删除全表使用delete的话,性能会比较差! 但是它可以回滚.
Drop
在InnoDB中,每张表数据内容和索引都存储在一个以,ibd 后缀的文件中,drop 就是直接把这个文件给删除了;
还有一个.frm后缀的文件也会被删除,这个文件包含表的元数据和结构定义。
文件都删了,所以这个操作无法回滚,表空间会被回收,但是如果表存在系统共享表空间,则不会回收空间。
默认创建的表会有独立表空间,把 innodb_file_per_table的值改为 OFF 后,就会被放到共享表空间中,即统一的ibdata1文件中。
Truncate
Truncate会对整张表的数据进行删除,且不会记录回滚等日志,所以它无法被回滚。
并且主键
1.2.14 请简述如何利用 UPDATE 替换 DELETE 语句实现伪删除?
添加
state状态字段,默认为1。查询数据时使用:
xxxxxxxxxxSELECT * FROM stu WHERE state = 1;伪删除,将要删除的行
state改为0:xxxxxxxxxxUPDATE stu SET state = 0 WHERE id = 4;查询时实际上并没有删除:
xxxxxxxxxxSELECT * FROM stu;
1.2.15 如果要你规划一个 10 亿的大表,你有什么好的方案?
考虑索引应用和存储问题:
分区表
归档表
分布式架构
1.2.16 如果这张10亿单表已经存在了,想要删除1000W数据如何处理?
1.2.17 生产中使用过分区表吗?你们使用的是什么分表策略?分区表有什么优势和劣势?
使用过
MyCAT做分区分表可以解决单库单表,在数据量大和高并发请求时带来的性能问题和扩展问题
1.2.18 请简述 GROUP BY 语句的执行原理?
取需要聚合的列及分组列,然后按分组列值进行排序去重,最后用聚合函数对要聚合的列进行聚合
1.2.19 WHERE 和 HAVING 语句的区别?
WHERE:分组前的条件过滤。
不能使用聚合函数。
HAVING:GROUP BY分组后的条件过滤。可以使用聚合函数。
1.2.20 生产中进行数据库资产统计,都统计什么?如何统计?
统计数据库的库表等元数据信息:
使用
information_schema.tables和information_schema.columns
业务上:
定时分析
binlog
1.2.21 请介绍你常用的聚合函数及其作用
聚合函数:
COUNT():返回指定组中数据的量,括号内可加列名SUM():返回指定组中数据之和,只能用于数字列,空值被忽略AVG():返回指定组中的平均值,空值被忽略MAX():返回指定数据的最大值MIN():返回指定数据的最小值GROUP_CONCAT():返回指定的数据,按逗号分隔为一行
1.2.22 简述多表连接的方式
内连接:
INNER JOIN
左外连接:
LEFT JOIN
右外连接:
RIGHT JOIN
全外连接:
FULL JOIN(MySQL 不支持,可用UNION ALL连接左连接和右连接来实现)
1.2.25 什么是笛卡尔乘积?
每张表的一行与另一张表的每一行做关联,逐行对比
1.2.26 你们公司 Online DDL 如何处理的?
评估需求:
在执行任何Online DDL之前,首先评估DDL操作的必要性,确保它对业务的正面影响超过可能带来的风险。
选择合适的工具:
利用MySQL内置的Online DDL功能,如INPLACE和COPY算法,或者第三方工具如pt-osc、gh-ost或NineData等,这些工具提供了更高级的在线变更能力,尤其是对于不支持原生Online DDL的操作。
测试与验证:
在生产环境部署前,先在测试环境中模拟相同的DDL操作,确保不会对现有数据造成意外影响,并验证性能影响。
最小化影响:
选择在业务低峰期执行DDL,减少对用户的影响。
监控与备份:
在执行前确保有完整的数据库备份,同时开启详细的监控,以便在操作过程中或之后快速响应任何异常。
使用自适应工具:
如NineData SQL开发专业版和企业版,它们提供了自适应Online DDL能力,自动选择最适合当前操作的执行方法,减少人工判断的复杂度。
实施Rollback计划:
准备好回滚策略,一旦出现错误,能够迅速恢复到操作前的状态。
并发控制:
确保在执行DDL时,通过锁定机制或工具的内置机制来管理并发,避免数据不一致。
文档与沟通:
记录整个过程,包括决策依据、执行步骤和结果,同时与团队成员保持沟通,确保每个人都了解变更的细节和时间表。
持续学习与优化:
根据每次操作的经验,不断调整策略,优化未来Online DDL的执行流程
1.2.27 5.6、5.7、8.0 在 Online DDL 的改变?
MySQL 5.6
初步支持: 引入了在线DDL的概念,允许某些类型的ALTER TABLE操作在不完全阻塞DML操作的情况下执行。这主要通过INPLACE算法实现,但其能力有限,对于一些操作,如添加索引,仍然可能导致较长时间的锁表。
并发性提升: 开始支持在DDL过程中进行一定程度的并发DML,但具体支持的操作类型有限。
MySQL 5.7
更多操作支持: 在5.6的基础上,增加了对更多类型DDL操作的支持,比如重命名索引、调整数值类型大小和VARCHAR长度的在线增大等。
性能优化: 对Online DDL的性能进行了优化,减少了数据拷贝的需求,提高了操作效率,特别是在处理大型表时。
稳定性增强: 提高了在线DDL的稳定性和可靠性,减少了操作失败的风险。
MySQL 8.0
INSTANT算法: 引入了革命性的INSTANT算法,允许在表的最后添加新列时,仅修改元数据而不涉及数据移动,这几乎不影响DML操作,且执行速度极快。
原子DDL: 实现了原子性DDL操作,确保DDL要么完全成功,要么完全回滚,提高了数据的一致性。
更灵活的并发控制: 提供了更细粒度的LOCK选项,如LOCK=NONE允许在DDL执行期间进行查询和DML操作,进一步减少了对业务的影响。
改进的算法选择: 默认算法更加智能,能够根据操作自动选择最合适的执行方式(COPY, INPLACE, 或 INSTANT)。
增强的元数据管理: 改进了数据字典的处理,使得某些DDL操作更加高效,减少了系统锁定时间。
1.2.28 简述 pt-osc 或者 gh-ost 第三方工具在处理 DDL 时的原理?
pt-online-schema-change (pt-osc)
原理步骤
创建影子表:
创建一个与原始表结构相同的影子表(例如_original_table_new)
应用DDL操作:
在影子表上执行指定的DDL操作(如添加、修改或删除字段)
创建触发器:
在原始表上创建三个触发器(分别用于INSERT、UPDATE和DELETE操作),将这些操作的应用也同步到影子表中。这样可以保证在数据迁移的过程中,对原始表的所有DML操作都被正确反映到影子表中。
xxxxxxxxxxCREATE TRIGGER `pt_osc_schema_original_table_del` AFTER DELETE ON `schema`.`original_table` FOR EACH ROW ...CREATE TRIGGER `pt_osc_schema_original_table_upd` AFTER UPDATE ON `schema`.`original_table` FOR EACH ROW ...CREATE TRIGGER `pt_osc_schema_original_table_ins` AFTER INSERT ON `schema`.`original_table` FOR EACH ROW ...全量数据复制:
执行批量COPY操作,将原始表中的数据逐步复制到影子表中。这个过程可能涉及分批次读取和写入,以减轻对数据库的压力。
xxxxxxxxxxINSERT LOW_PRIORITY IGNORE INTO `_original_table_new` (...) SELECT ... FROM `original_table`;Cut-over 切换:
最终阶段,当所有数据都已成功复制并且触发器捕获了所有增量变化后,通过原子性操作交换两张表的角色。具体做法是在极短的时间窗口内禁用触发器并对原始表加锁,然后重命名原始表为备份名称(例如 _original_table_old),并将影子表重命名为原始表的名称。
xxxxxxxxxx ALTER TABLE original_table RENAME TO _original_table_old; ALTER TABLE _original_table_new RENAME TO original_table;清理工作:
移除不再需要的临时对象,包括触发器、备份表和其他辅助表。
xxxxxxxxxxDROP TRIGGER IF EXISTS pt_osc_schema_original_table_del;DROP TRIGGER IF EXISTS pt_osc_schema_original_table_upd;DROP TRIGGER IF EXISTS pt_osc_schema_original_table_ins;DROP TABLE IF EXISTS _original_table_old;特点
最小化停机时间: 由于大部分操作都在后台异步进行,因此不会严重影响正在运行的服务。
兼容性强: 支持大多数MySQL版本,并能适应各种类型的DDL操作。
易于使用: 提供详细的文档和支持丰富的命令行参数,便于配置和调试。
gh-ost
原理步骤
创建影子表:
创建一个与原始表结构相同的影子表(例如_original_table_ghost)。
应用DDL操作:
在影子表上执行指定的DDL操作。
BinLog Streaming:
设置一个二进制日志流监听器(类似于从库的行为),实时读取并解析原始表上的binlog事件,将这些变更应用到影子表中。这种方式消除了对触发器的需求,减少了潜在的性能瓶颈。
xxxxxxxxxx # 内部实现类似以下伪代码 binlog_streamer := NewStreamer(original_table) for event in binlog_streamer.ReadEvents() { ApplyEventToGhost(event, shadow_table) }全量数据复制:
使用高效的算法将原始表中的全部数据复制到影子表中。这个过程尽量减少对数据库的影响,确保尽可能小的停机时间。
xxxxxxxxxxINSERT /* low_priority */ INTO `_original_table_ghost` (...) SELECT ... FROM `original_table`;Cut-over 切换:
在完成数据复制并通过一系列检查确认一切正常后,执行最终的切换单元操作。这部分操作非常迅速且几乎不影响正在进行的其他活动。
x -- 锁定原始表防止新数据进入 FLUSH TABLES WITH READ LOCK;
-- 记录最后一个binlog位置 last_binlog_pos := GetLastAppliedPosition();
-- 解锁表允许继续写入 UNLOCK TABLES;
-- 继续应用剩余的日志事件至shadow_table while current_position < last_binlog_pos { ApplyNextEvent(); } -- 原子性重命名表 RENAME TABLE original_table TO _original_table_old, _original_table_ghost TO original_table;清理工作:
清理不再需要的对象,包括备份表和其他中间产物。
xxxxxxxxxxDROP TABLE IF EXISTS _original_table_old;STOP SLAVE; -- 如果设置了slave线程特点
零停机时间: 整个过程几乎没有停机时间,适用于要求极高可用性的生产环境
高性能: 通过利用binlog而不是触发器来跟踪数据的变化,提高了系统的整体性能
灵活扩展: 易于与其他自动化工具和服务集成,支持分布式架构下的部署
社区活跃: 来自GitHub的强大社区提供了持续的支持和技术改进
1.2.29 为什么在MySQL 中不推荐使用多表 Join ?
MySQL 不推荐使用多表 JOIN 的核心原因可归结为 性能、扩展性、维护性 三大问题,具体分析如下:
一、性能瓶颈
1. 查询复杂度激增
指数级计算量:多表 JOIN 的查询复杂度随表数量增加呈指数级上升(如 3 表 JOIN 可能涉及百万级行匹配)
磁盘 I/O 压力:若关联字段无索引或数据量大,需频繁全表扫描,导致磁盘 I/O 激增(参考案例:无索引时 1 亿数据查询超时)
内存消耗高:临时表存储中间结果,可能触发内存交换(如 Using temporary; Using filesort),降低响应速度
2. 锁竞争与并发限制
行锁/表锁冲突:高并发场景下,JOIN 可能因锁等待导致吞吐量下降(如事务隔离级别为 REPEATABLE READ 时的间隙锁竞争)。
资源争抢:数据库 CPU、内存资源被复杂查询独占,影响其他业务操作。
3. 优化器局限性
执行计划不稳定:MySQL 优化器可能因统计信息不准确或索引变化选择低效执行路径(如误选 Nested-Loop Join 而非 Hash Join)。
索引设计难度:需为多表关联字段分别建索引,维护成本高且易遗漏。
二、扩展性缺陷
1. 分库分表困境
跨库 JOIN 失效:分布式场景下,数据分散在不同节点,无法直接关联(如分库分表后 user 表和 order 表不在同一物理库)。
中间件支持不足:主流分库中间件(如 ShardingSphere)对跨库 JOIN 支持有限,通常需业务层手动分片聚合。
2. 水平扩容困难
数据分布不均:JOIN 依赖数据局部性,扩容后关联查询可能跨多节点,网络延迟成为瓶颈(如电商订单与用户信息分散存储)。
三、维护成本高
1. 耦合性强
业务逻辑侵入:JOIN 条件与表结构深度绑定,表结构变更(如字段类型修改)需同步调整所有关联查询,易引发错误。
可复用性差:复杂 JOIN SQL 难以复用,不同业务需重复编写相似逻辑(如订单关联用户、商品、物流等多表查询)。
2. 缓存利用率低
查询缓存失效:任意关联表数据变更均导致缓存失效(如 user 表更新,user JOIN order 的缓存结果需清除)。
部分缓存不可行:无法单独缓存单表数据,需全量缓存关联结果,内存占用高。
1.2.30 MySQL中count(*) count(1) count (字段名) 的区别是什么?
| 表达式 | 统计规则 | 是否包含 NULL 值 |
|---|---|---|
| COUNT(*) | 统计所有行数,与具体字段无关。 | 包含 NULL 行 |
| COUNT(1) | 统计所有行数,1 是常量表达式,与具体字段无关。 | 包含 NULL 行 |
| COUNT(字段名) | 统计指定字段的非空值数量。 | 不包含 NULL 行 |
| COUNT(DISTINCT 字段名) | 统计去重后的非空值数量。 | 不包含 NULL 行 |
1.2.31 MySQL 中 int(11) 的 11 表示什么?
MySQL 中 int(11) 的 11 表示 显示宽度(Display Width),其作用仅限于 控制数值的显示格式,与存储范围、存储字节数无关
1.2.32 MySQL 中 varchar 和 char 有什么区别?
存储方式
CHAR(M) 固定长度,存储时填充空格至长度 M,检索时自动删除尾部空格
VARCHAR(M)可变长度,存储实际字符+1~2字节长度标记,保留尾部空格
最大长度
CHAR(M) 255 字符(与字符集无关)
VARCHAR(M) 65535 字节(字符数受字符集影响,如 UTF8 最多 21844 字符)
存储空间
CHAR(M) 占用空间大小固定有空间浪费
VARCHAR(M) 实际存储的大小,空间浪费小
性能对比
CHAR(M) 读/写更快(无需计算长度,适合索引查询)
VARCHAR(M) 读/写略慢(需解析长度标记,碎片化存储可能增加 I/O)
本质区别
varchar 在行格式中 使用一个可变长字段记录实际长度
使用场景
CHAR(M) 固定长度字段,如手机号、身份证号, 数据量小
VARCHAR(M) 长度波动较大的字段(如地址、描述、评论)数据量大
排序性能影响
当使用varchar 进行排序的时候,带来一个问题,mysql 加载排序的字段时,sort_buffer 是按照 varchar(n) 里面的 n 进行分配空间的,这样就会导致有可能因为varchar 字段设置长度过长,而选择了了双路排序,这样的话就需要回表,带来性能损耗,如果是单路排序的话就你减少IO次数,提升性能
1.2.33 MySQL 中如何进行 SQL 调优?
平时进行SQL调优,主要是通过观察SQL,然后利用explain分析查询语句的执行计划,识别性能瓶颈,优化查询语句:
合理设计索引,利用联合索引进行覆盖索引的优化,避免回表的发生,减少查询过程的随机I/O消耗;
避免SELECT * ,只查询必要的字段
避免在SQL中进行函数计算等操作,使得无法命中索引
避免使用like %,导致全表扫描
注意联合索引需要满足最左匹配原则
不要对无索引字段进行排序操作
连表查询需要注意不同字段的字符集是否一致,否则也会导致全表扫描
还可以利用缓存来优化,一些变化少或者访问频繁的数据设置到缓存中,减轻数据库的压力,提升查询的效率;
还可以通过业务优化,尽量少展示一些不必要的字段,减少多表查询的情况,将列表查询替换成分页分批查询;
1.2.34 select *和 select 所有字段区别?
SELECT *,需要数据库先Query Table Metadata For Columns,一定程度上为数据库增加了负担 但是实际上,两者效率差别不大
1.2.35 select *一定会全表遍历吗?
本质是索引失效问题* 可以回答索引失效的点
SELECT * 不一定总是导致全表遍历 具体行为依赖于表上的索引和查询条件
合理的索引设计 可以显著提高查询效率,避免不必要的全表扫描
使用 EXPLAIN 工具 可以帮助您诊断和优化查询性能
1.2.36 连表查询怎么看哪个是驱动表,哪个是被驱动表?
驱动表(Driving Table):这是查询过程中首先被访问的表。它的数据会被用来与其他表进行比较和连接。
被驱动表(Driven Table):这是根据驱动表的数据来进行查找和匹配的表。只有当驱动表中的某一行满足连接条件时,才会去被驱动表中查找相应的行
使用 EXPLAIN 语句:可以通过
table和ID字段的顺序知道 哪个是驱动表,哪个是被驱动表默认情况会选择小表作为驱动表,大表作为被驱动表
可以利用外连接设置,影响驱动表和被驱动
当连接查询有
where条件时,带where条件的表是驱动表,否则是被驱动表
观察 SQL 语句
LEFT JOIN / RIGHT JOIN: 默认情况下,左边的表是驱动表,右边的表是被驱动表如果有 WHERE 条件限制了某些表的行为,则按照 WHERE 条件来决定驱动表
INNER JOIN: 如果没有 WHERE 条件,MySQL 会选择较小的表作为驱动表。如果有 WHERE 条件,通常会优先选择有 WHERE 条件的表作为驱动表
使用
STRAIGHT_JOIN强制指定驱动表 有时自动选择的驱动表并不是最优的,这时可以使用STRAIGHT_JOIN来强制指定驱动表
1.2.37 嵌套连结和hash join原理 ?
1.2.38 update一条语句的流程?
update t1 set name=xiaoB where 条件;
调取数据过程 (
select name from t1 where条件 )经过数据库server层进行处理,获取数据存储位置点(连接器 分析器 优化器 执行器);
经过数据库engine层进行处理,会加载索引页信息(辅助索引-回表过程-聚簇索引)
经过异常数据库服务层和引擎层处理,会将磁盘中的数据加载到内存区域(
buffer pool)
修改数据过程(
存储过程)创建新信息事务信息,会将内存中的数据页进行修改;
会将数据页修改前的信息,保存到
undo日志中,会将数据页修改后的信息,保存到redo日志中;(只是完成事务第一阶段操作 prepar )会将修改数据SQL语句信息保存到
binlog文件中,确认事务完成提交(完成事务第二个阶段操作binlog redo-commit)最后会将
buffer pool脏页数据信息进行落盘操作会先将数据页16kb信息保存到双写缓冲区,利用双写缓冲区将信息保存到双写文件中;
会再将数据页16KB信息保存到磁盘文件中(t1.ibd)
索引
1.3.1 请列举 MySQL 索引的类型
依据功能分类:
隐藏索引(8.0 开始支持)隐藏索引不会被优化器使用。
降序索引(8.0 开始支持)
普通索引
唯一索引
主键索引
全文索引
空间索引
联合索引
从InnoDB B+Tree索引树角度看:
聚簇索引(
`clustered index)辅助索引(
`non-clustered index)
从数据结构角度看:
B+TREE索引
哈希索引
倒排序索引(Full-Text)
R-Tree索引;(多维空间树)
功能应用
B+树索引: 通过树形结构存储数据,适用于范围査询(如 BETEEN)和精确査询(如=),支持有序数据的快速査找、排序和聚合操作 是MySQL 默认的索引类型,常用于InnoDB 和 MyISAM 引擎
哈希索引: 基于哈希表的结构,适用于等值査询(如 =),查询速度非常快,但不支持范围査询(如>、<)哈希索引不存储数据的顺序常用于 Memory 引擎
倒排索引(Full-Text):
用于全文搜索,将全文分词,通过存储词与文档的映射,支持模糊匹配和关键字搜索 特别适合用于大文本字段,如TEXT类型的列,用于查找包含特定词语的记录R-树索引: 专为多维空间数据(如地理坐标)设计,适用于空间査询(例如,计算地理位置的最近距离、区域查询等)。 常用于存储和査询地理信息系统(GIS)中的空间数据
聚簇索引: InnoDB 中主键索引就是聚簇索引。它基于主键排序存储。之所以叫聚簇索引是因为索引的叶子节点存储完整数据行数据
非聚簇索引: 指的是 InnoDB 中非主键索引的索引,之所以称之为非聚簇是因为这个索引的叶子节点仅保存索引字段和主键的值 如果要查询完整的数据行中的数据,需要再从聚簇索引即主键索引中通过主键查询,一个表可以有多个非聚簇索引
普通索引: 一般指非主键索引且非唯一索引
主键索引: 表中的每一行数据都有唯一的主键。每个表只能有一个主键索引,且主键值不能为 NULL。InnoD8 中主键索引是聚簇索引结构实现的
联合索引: 由多个列组成的索引,适用于多列的查询条件,能够提高包含多个条件的查询的性能。联合索引中的列是按照指定顺序排列的
唯一索引: 保证索引列中的值是唯一的,可以有效防止重复数据的插入。唯一索引允许 NULL值,但一个列中可以有多个 NULL
1.3.2 MySQL 索引算法演变:二叉树,二叉平衡树,红黑树,B -Tree, B+Tree?
二叉树(Binary Tree)
解决的问题:相比顺序遍历,利用二分法快速定位数据
局限性:退化为链表:数据有序插入时(如递增ID),树退化为线性结构,查询复杂度由O(logN)退化为O(N)。
磁盘IO问题:树高不可控,数据量较大时树层级过深,导致磁盘IO次数过多(每次查询需多次磁盘访问)
平衡二叉树(AVL树)
解决的问题:避免二叉树退化为链表,强制左右子树高度差≤1,保证查询复杂度
解决的问题:在平衡二叉树基础上放宽平衡要求(最长路径≤2倍最短路径),减少旋转次数,提升插入/删除效率
优势:
近似平衡:插入/删除最多3次旋转,复杂度稳定在O(logN)
内存友好:适合内存数据结构(如Java的TreeMap)
局限性:磁盘场景不适用:树高仍随数据量增长,无法解决海量数据下磁盘IO问题
B-Tree(多路平衡查找树)
解决的问题:针对磁盘IO优化,通过多节点存储降低树高
关键优化:
多路分支:每个节点存储多个键值(阶数m),子节点数=键值数+1,显著减少树高(如阶数500,百万数据仅3层)
节点预读:磁盘按页(如16KB)读取,单节点存多键值,减少IO次数
局限性:
范围查询效率低:非叶子节点存储数据,范围查询需跨层多次遍历
空间冗余:键值与数据混合存储,节点容量受限
B+Tree(B-Tree优化版)
解决的问题:优化B-Tree的查询效率与存储结构,适配数据库场景
核心改进:
非叶子节点仅存索引:不存数据,单节点容纳更多键值,进一步降低树高
叶子节点链表连接:所有数据存于叶子节点,并按顺序形成双向链表,支持高效范围查询与顺序扫描
聚簇索引优化:
InnoDB主键索引叶子节点直接存数据行,减少回表优势:
优势:
磁盘IO更少:树高更低,百万数据仅需3次IO
范围查询高效:通过叶子节点链表快速遍历区间数据
全表扫描更快:叶子节点包含全部数据,避免非必要分支访问
最终选择B+Tree的原因:
磁盘友好:树高可控,减少IO次数
范围查询高效:叶子链表天然支持范围扫描
存储利用率高:非叶子节点仅存索引,容纳更多键值
与数据库设计匹配:聚簇索引、覆盖索引等特性直接依赖B+Tree结构
1.3.3 索引树高度影响因素有哪些?
表的数据行数过多办法:表分区;定期归档(工具pt-archiver)
索引列长度过长办法:使用前缀索引
数据类型不当(char/varchar)
1.3.4 详细说一说B+树在磁盘IO方面的优势
MySQL中一次IO操作最小的单位是page,每个page设计为16kb,以业务常用的8字节的bigint为例,8字节加上6字节指向下一元素的指针共14字节,每个page可以存下约1000左右的数据,那么三层高度的树就可以存下共1000^3个元素,这样就算每次只往内存加载一层,最多三次IO也就能定位到要找的元素在那个位置了,page大小可以指定,但是最好就使用16kb的设置,因为它是符合操作系统底层IO设计的--一次查一页4kb,但每次一并返回周围的三块页共页也就是16kb
1.3.5 MySQL 8.0索引的新特性
隐藏索引:8.0 开始支持隐藏索引,不可见索引不会被优化器使用,但仍需维护
降序索引:8.0 开始真正支持降序索引
隐式索引:不再对
GROUP BY操作进行隐式排序函数索引:支持在索引中使用函数计算后的值
1.3.6 创建索引时应当注意什么(什么时候适合创建索引)?
需要创建索引:
频繁作为where查询的字段 (select,update,delete 的where 条件)
DISTINCT 字段需要创建索引
经常使用GROUP BY 和 ORDER BY 的列
注意事项:
字段的数值具有唯一性限制 (业务上具有唯一特性的字段,即使是组合字段,也必须组成唯一索引)
对列的类型小的创建索引 (数据类型越小查询速度越快)
列值长度较长的索引列,建议使用前缀索引 (截取字符串前面的一部分建立索引(前缀索引),全文索引会占用空间和查询时间)
使用散列度高的列作为索引 (但不一定 例如性别,在男性多的中查找女性,如果对女性做索引就能增加查询速度)
使用最频繁的列放到联合索引的左侧
多表连接时创建索引
连接表的时尽量不要超过三张
对于连接的字段创建索引 (JOIN ON )
最好使用唯一值多的列作为索引,如果索引列重复值较多,可以考虑使用联合
索引维护要避开业务繁忙期
1.3.7 什么时候不适合创建索引
在where中使用不到的字段,不要设置索引
数据量小的表不要使用索引 (全表扫描更快)
有大量重复数据的列上不要建立索引
避免对经常更新的表创建过多的索引
不建议用无序的值作为索引 (尽量单调递增)
删除不再使用或者很少使用的索引
不要定义夯余或者重复的索引
1.3.8 什么情况会造成索引失效?
主键插入顺序出现忽大忽小,或从中间插入值
函数导致索引失效
类型转换导致索引失效
不等于 <> !=
is null ,is not null (有例外)
like 通配符以 %开头
范围条件右边的索引失效 需要将范围查找的值放到最后
OR 前后存在非索引的列,索引失效
where选取范围过大 会从range 转化为 all
查询条件复杂
统计数据不准确,导致成本计算误判
表中两个不同字段进行比较
使用了 order by 但是后面不是主键,或者不是覆盖索引导致不走索引
子查询可能会导致失效
连表查询需要注意不同字段的字符集是否一致,否则也会导致全表扫描
1.3.9 如何获取执行计划?如何理解分析执行计划的输出?
为什么分析执行计划?
分析比较慢的执行语句
上线新的业务,可能包含很多
select update delete提前发现
如何产生的执行计划:
优化器得出的,代价最低的SQL语句执行方案
如何获取执行计划:
使用
EXPLAIN SQL语句使用
DESC SQL语句
执行计划字段解释
id:选择标识符select_type:查询类型(简单查询或复杂查询)table:当前操作的表type:操作类型(ALL、INDEX、RANGE、REF等)possible_keys:可能使用的索引key:实际使用的索引key_len:索引覆盖长度(字节)rows:预估需要扫描的行数extra:额外信息(如Using index、Using where等)
1.3.10 什么是回表查询?如何减少回表
回表查询:InnoDB中,数据以B+树的形式进行组织,聚簇索引叶子节点存的是主键所对应的行所有字段的数据,而非聚簇索引叶子结点仅存该索引所对应的主键ID。如果某条查询走了非聚簇索引但又需要返回整行数据的话,则需要进行回表操作,会损耗一定的性能(覆盖索引的情况下则无需回表)
回表的问题:增加磁盘 IO 次数(IOPS),增加吞吐量
减少回表的方法
建立合适的联合索引,尽可能将查询条件的数据包含在联合索引中
精细查询条件,尽量使用等值查询,符合联合索引规则,覆盖的列越多越好
索引优化器:
ICP(Index Condition Pushdown):索引下推优化
MRR(Multi-Range Read):在辅助索引阶段获取主键值后排序回表
1.3.11 聚簇索引和非聚簇索引有什么区别?
聚簇索引中,索引的叶子节点存储的的是数据行,可以直接访问到完整的数据
每个表中只能有一个聚簇索引,通常是主键索引,适合范围查询和排序
非聚簇索引中,索引的叶子节点存储的数据行的主键和对于索引列,需要通过主键才能访问完整的数据行
一个表中可以有多个非聚簇索引,适用于查找特定列的数据
如果使用非聚簇索引查询字段信息,且查询的字段不在where 的查询字段中,需要回表查询
1.3.12 描述 MySQL 的 B+ 树中查询数据的全过程
数据从根节点找器,根据键值的大小确定左子树还是右子树,从上到下定位到叶子节点;
叶子节点中存储事务的数据行记录,但一页只有16KB大小,存储数据不止一条
叶子节点中数据行以组的形式划分,利用页的目录结构中slot,通过二分法可以定位到对应的组
定位组之后,利用链表遍历就可以找到对应的数据行
1.3.13 唯一索引与普通索引的区别?
区别在于更新时,需要检查更新后的值是否具备唯一性,这个在启用了 changeBuffer时影响较大,当使用唯一索引时,更新后的值无法直接存入changeBuffer,而是要做一次磁盘查询,来确定更新后的值的唯一性,因此性能相对较差,因此应当尽量使用业务来保证数据的唯一性。
1.3.14 详细说说最左前缀匹配
MySQL索引的最左前缀匹配原则指的是使用联合索引时
查询条件必须从索引的最左侧开始匹配数据 a* b c
selech from where a=xx / a>=xx / a<=xx创建联合索引需要将索引选择度高的列放在最左边 name-索引选择度高 gender 减少辅助索引查询数据IO消耗
最左原则应用情况:
最左列最好是等值查询(=,>=,<=),不能范围查询 (> <)
一定条件信息包含最左列,但其他列信息可以不包含,或可以不用等值查询,因为可以借助索引下推功能,减少IO消耗查询数据
当最左列索引选择度低时,可以在查询信息时,不定义最左列信息,利用skip scan优化功能,会自动添加左列信息
1.3.15 能说说什么是索引下推吗?
允许MySQL在使用索引查找数据时,将部分查询条件下推到存储引擎层过滤,从而减少需要从表中读取的数据行,减少了IO;
ICP可以在执行阶段提高执行效率,但是在优化阶段并不能改善执行计划
1.3.16 执行计划中你一般关注哪些点?
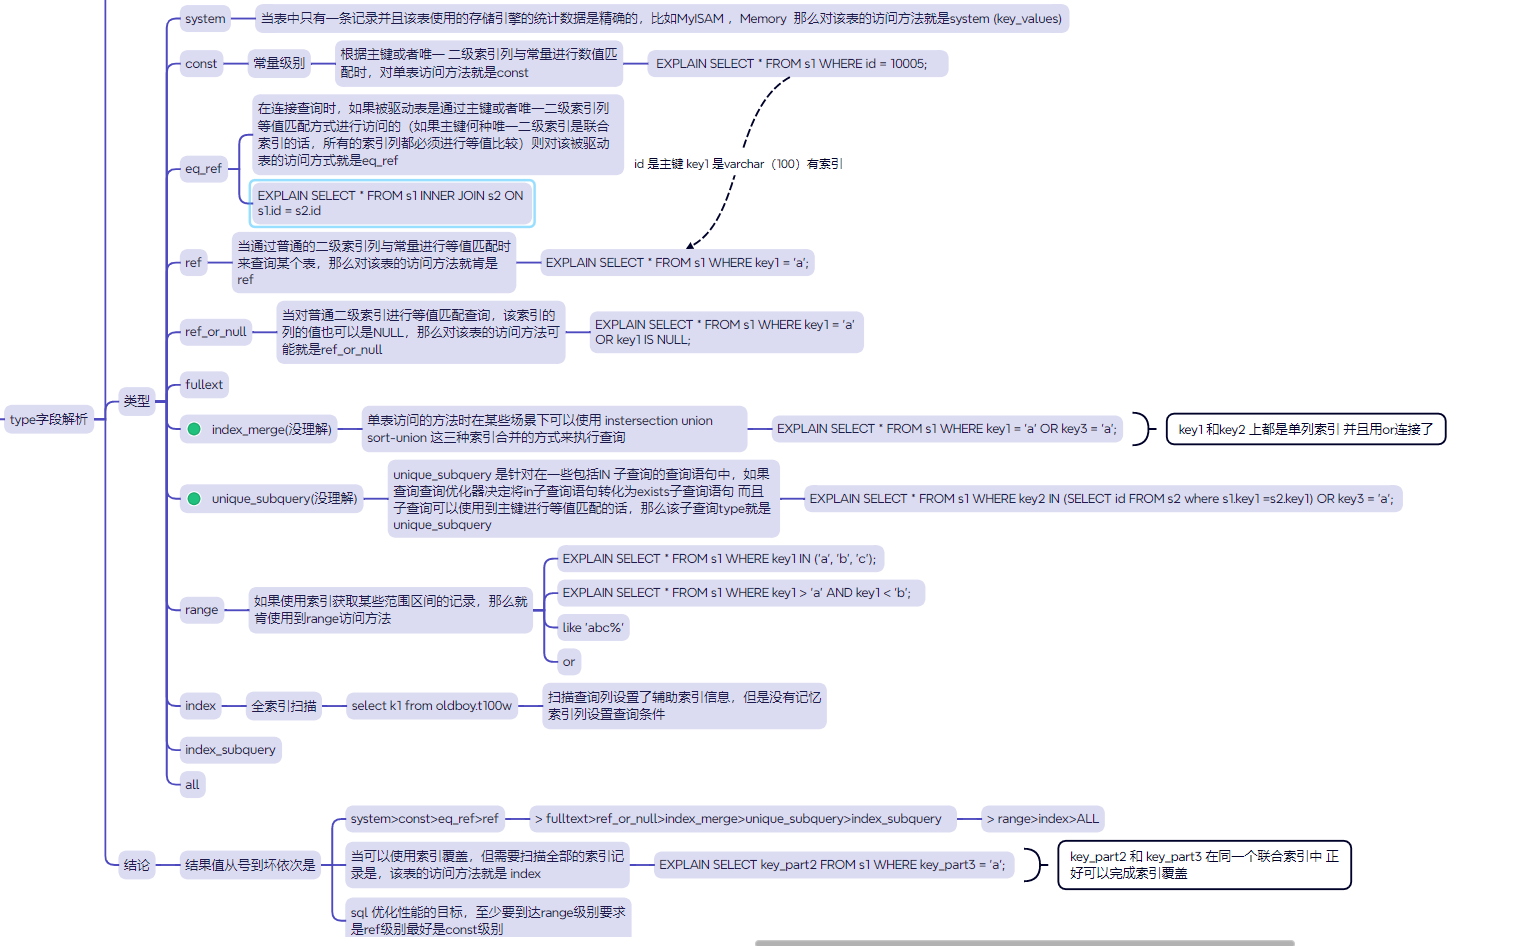
Type 访问类型
key 使用索引
possible_keys 可能使用的索引 太多会造成开销,也不能没有
rows 扫描行数
extra 是否用到了索引,是否用到了索引下推,是否要用文件排序,走不了内存,是否要用临时表等等
1.3.17 MySQL为什么选择 B+tree 查找算法?
擅长范围查找,快速锁定数据范围
1.3.18 一条select语句平常查询时很快,一天突然变慢了的原因?
原因
索引失效:这可能是由于数据库表上的某些列被频繁更新或插入数据导致统计信息变得不再准确。MySQL使用这些统计信息来进行查询优化决策(如选择合适的执行计划)。如果统计信息过期或者不够精确,则可能导致原本高效的索引未被正确利用。
统计数据不真实:与上述点相关联的是,若数据库管理系统未能及时地重新计算并更新关于表结构及其存储的数据分布情况等元数据的话,也可能影响到查询性能下降的问题出现。
解决
手动运行
ANALYZE TABLE table_name;命令以刷新指定表的相关统计信息。检查是否有新的DML操作对涉及该查询条件的字段产生了大量变更,并考虑是否需要调整自动收集统计的时间间隔设置。
1.3.18 聚簇索引构建条件 聚簇索引是如何构建的?
如果表中有主键,主键就被作为聚簇索引
没有主键,第一个不为空的唯一键作为索引
什么都没有,自动生成一个6字节的隐藏列,作为聚簇索引
1.3.19 索引有哪些自优化能力?
AHI(工作于内存中)自适应哈希索引
Change buffer更新的辅助索引缓存
ICP索引下推优化
MRR多范围读取优化,把在辅助索引阶段获得的主键值排序然后再回表查询
1.3.20 如何建立索引才能加快查询?
在where后面的条件以及分组列,排序列上建立索引才能加快查询
在唯一值多的列上建立索引,才能加速查询
1.3.21 建立索引后还会出现慢查询后如何解决及原因?
查询没有用到索引列或没符合联合索引使用条件
索引基数过小,结果集过大
索引失效,索引重建
1.3.22 MySQL 中的数据排序是怎么实现的?
命中索引
利用索引进行排序
未命中索引
则利用文件排序
文件排序中,如果数据量少则在内存中排序,具体会使用单路排序或者双路排序
文件排序中,如果数据量大则在磁盘文件进行外部排序,一般使用归并排序;
1.3.23 MRR多范围读取优化?
MRR(Multi-Range Read Optimization),即多范围读取优化,是MySQL中用来提高索引查询性能的一项重要技术。以下是对其工作的详细解释以及它所带来的优点:
工作机制
初步扫描索引: MySQL首先仅扫描所需的索引来收集匹配记录的键值(通常是主键或其他唯一标识符)。
排序键值: 对这些键值进行排序,以便它们按照数据文件中的实际位置排列。
顺序访问数据行: 使用经过排序的键值列表按顺序从基础表中检索相应的完整数据行。
这种方法的主要目标是从减少随机磁盘I/O转向更多的顺序I/O操作,因为后者通常比前者更快且消耗较少的资源。
主要优势
减少随机I/O: 通过对多个非连续的位置进行一次性的顺序读取,大大降低了因多次跳跃式寻址而导致的高延迟和低吞吐量的情况发生。
提高CPU利用率: 减少了不必要的上下文切换频率,使得处理器能够在同一时间段内专注于单一任务而非频繁中断转跳不同的内存地址处加载新指令集。
增强缓存命中率: 当数据是以相对紧凑的方式存储时,相邻的数据项更容易同时存在于高速缓存之中,进而加快整体响应速度。
适用多种场景: 包括但不限于范围索引扫描、等值连接以及其他依赖于特定索引元组定位的基础表条目提取的任务均可从中受益。
批处理能力: 具备一次性接收来自不同来源的一系列独立请求的能力,并将其合并成统一的大规模输入流供底层子系统进一步加工处理。
1.3.24 MySQL 中的索引数量是否越多越好?为什么?
原因
增加写操作负担:
每次进行INSERT、UPDATE或DELETE操作时,不仅需要修改表中的数据,还要同步更新相关的索引。这会增加写操作的时间开销,尤其是在有大量的索引的情况下
占用更多存储空间:
索引本身也需要占据一定的存储空间。随着索引数量的增多,总的存储需求也会相应增大
降低维护成本:
更多的索引意味着更高的维护成本,包括定期重建索引、监控索引状态等工作
影响事务性能:
过多的索引可能会导致锁定争用增加,从而影响并发事务的性能
复杂化查询优化器的工作:
MySQL的查询优化器需要权衡不同的索引组合来生成最优的执行计划。过多的索引选项会使优化过程变得更加复杂,有时甚至可能导致选择不佳的执行路径
1.3.25 联合索引与单列索引的区别?
联合索引对比每列分别建索引更具优势,因为索引建立的越多就越占磁盘空间,在更新数据特慢
1.3.26 你能看到你查询时间?查询速度?
1.3.27 ⽐如说我查询的表结构是string类型,然后我⽤varchar类型的会⾛索引吗?
在⼤多数数据库中,string 并不是⼀个标准的数据类型,通常在 MySQL 中使⽤ CHAR 或
VARCHAR 来存储字符串。如果表中的字段类型是 VARCHAR,查询时使⽤ VARCHAR 类型的值,并且
该字段上有索引,那么在满⾜索引使⽤条件的情况下,是可以⾛索引的
1.3.28 varchar类型的不是要加单引号吗,然后你不加单引号直接查⼀个数字能查出了吗?(⽐如说;varchar类型是123456,查id=123456能查出来吗?不加单引号)?
可以,数据库会进⾏隐式类型转换,将数字转换为字符串进⾏⽐较。因此,在这种情况下,不加单引号也能查出结果。但是,这种隐式类型转换可能会导致索引失效,影响查询性能
1.3.29 explain查执⾏计划,ID列的执⾏顺序是怎么样的?
同ID 从上到下依次排序,不同ID 从小到大
1.3.30 B+tree构建过程
B+树的构建过程包括以下几个步骤:
初始化树:创建一个空的B+树,包括一个根节点和初始的叶子节点
插入关键字:从根节点开始,按照B+树的插入规则,逐级向下查找适当的叶子节点。如果叶子节点已满,则进行分裂操作,将关键字插入到合适的位置,并调整指针
分裂节点:当一个叶子节点已满时,需要进行分裂操作。将节点中的关键字分成两部分,较小的一部分保留在原节点,较大的一部分移动到一个新节点中,并调整相应的指针
更新父节点:在插入过程中,如果节点发生了分裂,需要更新父节点的关键字和指针。如果父节点也满了,则进行递归的分裂和更新操作
调整根节点:如果根节点发生了分裂,则需要创建一个新的根节点,并将原来的根节点和新分裂出的节点作为其子节点
删除关键字:从根节点开始,按照B+树的删除规则,逐级向下查找要删除的关键字所在的叶子节点。将关键字删除,并进行相应的调整和合并操作
合并节点:当一个叶子节点的关键字数量过少时,可以进行合并操作。将该节点与相邻的兄弟节点合并,调整关键字和指针
更新父节点和根节点:在删除过程中,如果节点合并导致父节点的关键字数量过少,则进行递归的合并和更新操作。如果根节点的关键字数量变为0,则更新根节点
1.3.31 MySQL 中使用索引一定有效吗?如何排查索引效果?
不一定,使用
EXPLAIN语句检查
1.3.32 MySQL 的覆盖索引是什么?
MySQL的覆盖索引(
Covering Index)是指二级索引中包含了查询所需的所有字段,使查询可以仅通过访问二级索引而不需要访问实际表数据(主键索引)
不要在 select 中使用 * 尽量写全
1.3.33 索引下推如何开启?
optimizer_switch='index_condition_pushdown=on';
1.3.34 如何使用 MySQL 的 EXPLAIN 语句进行查询分析?
| 序号 | 字段 | 解释说明 |
|---|---|---|
| 01列 | ID | 表示查询执行顺序的标识符,值越大优先级越高; 简单查询的ID通常为1,复杂查询(子查询和union)的id会有多个 |
| 02列 | select_type | 表示语句查询类型,sipmle表示简单(普通)查询,primary表示主键查询,subquery表示子查询; |
| 03列 | table | 表示语句针对的表,单表查询就是一张表,多表查询显示多张表; |
| 04列 | partitions | 表示匹配的分区信息 |
| 05列 | type | 表示索引应用类型,通过类型可以判断有没有用索引,其次判断有没有更好的使用索引 索引类型应用性能从好到差的顺序是:const>eq_ref>ref>range>index>all |
| 06列 | possible_keys | 表示可能使用到的索引信息,因为列信息是可以属于多个索引的 |
| 07列 | key | 表示确认使用到的索引信息 |
| 08列 | key_len | 表示索引覆盖长度,对联合索引是否都应用做判断 |
| 09列 | ref | 表示当使用索引列等值查询时,与索引列进行等值匹配的对象信息 |
| 10列 | rows | 表示查询扫描的数据行数(尽量越少越好),尽量和结果集行数匹配,从而使查询代价降低 |
| 11列 | fltered | 表示查询的匹配度,显示查询条件过滤掉行的百分比,一个高百分比表示查询条件的选择性好。 |
| 12列 | Extra*** | 表示额外的情况或额外的信息 using index(表示使用覆盖索引) using where(表示使用where条件进行过滤) using temporary(表示使用临时表) using filesort (表示需要额外的排序步骤) |
TYPE 字段
| 序号 | 类型 | 解释说明 |
|---|---|---|
| 01 | system | 表示查询的表只有一行(系统表)。这这是一个特殊的情况,不常见 |
| 02 | const | 表示查询的表最多只有一行匹配结果。这通常发生在查询条件是主键或唯一索引,并且是常量比较 |
| 03 | eq_ref | 表示对于每个来自前一张表的行,MySQL仅访问一次这个表。这通常发生在连接查询中使用主键或唯一索引的情况下。 |
| 04 | ref | MySQL使用非唯一索引扫描来查找行。查询条件使用的索引是非唯一的(如普通索引) |
| 05 | range | 表示MySQL会扫描表的一部分,而不是全部行。范围扫描通常出现在使用索引的范围查询中(如BETWEEN、>,<,>=,<=) |
| 06 | index | 表示 MySQL扫描索引中的所有行,而不是表中的所有行。即使索引列的值覆盖查询,也需要扫描整个索引。 |
| 07 | all(性能最差) | 表示 MVSQL 需要扫描表中的所有行,即全表扫描。通常出现在没有索引的查询条件中 |
存储引擎
1.4.1 MySQL 中 InnoDB 存储引擎与 MyISAM 存储引擎的区别是什么?
InnoDB支持:事务?、mvcc?、聚簇索引!、外键、缓冲区?、AHI?、DW(保证数据保存安全性);MyISAM均不支持
InnoDB支持:行级锁,MyISAM只支持表级锁;
InnoDB支持:数据热备,可以保证业务正常运行,对业务影响低,MyISAM只支持温备份,需要锁表备份;
InnoDB支持:支持CR自动故障恢复,宕机自动恢复,数据安全和一致性可以得到保证;MyISAM不支持,宕机可能丢失当前数据;
MyISAM :
支持全文检索、数据压缩、空间函数,不支持事务和行级锁,只有表级别锁;
适用于 OLAP 场景,也就是分析类的,基本上都是读取,不会有什么写入动作的场景。
应用的索引也是B+树,只是不像InnoDB 那种叶子节点会存储完整的数据;
数据是独立于索引单独存储的,所以主键和非主键索引差别不大。
不支持崩溃后的安全恢复,而InnoDB有个redolog可以支持安全恢复
写入性能差,因为锁的粒度太粗了,不支持行锁,只有表锁,所以写入的时候会对整张表加锁;
不过有个并发插入的开关,开启之后当数据中间没有空洞的时候,也就是插入的新数据是从末尾插入时,读取数据是不会阻塞的。
InnoDB(MySQL默认引擎)
支持事务,实现了四种标准的隔离级别,利用 MVCC 来支持高并发,默认事务隔离级别为可重复读,支持行锁;
利用行锁+间隙锁提供可重复读级别下防止幻读的能力,支持崩溃后的数据安全恢复;
支持外键,不过一般互联网项目都不会用外键的,性能太差,利用业务代码来实现约束即可;
由于使用行级锁定和支持事务,因此在并发性能方面表现较好,特别是在多个用户同时对数据库进行读写操作时;
主键索引称为聚簇索引,也就是数据和索引是放在一起的,并且它的辅助索引(非主键索引)只存储索引值与主键;
因此当辅助索引不能覆盖查询的列时,需要通过找到的主键再去聚簇索引查询数据,这个过程称之为回表
1.4.2 MySQL 有哪些存储引擎?
InnoDB(默认引擎)
MyISAM
Memory
CSV
Federated
NDB
1.4.3 TokuDB 等存储引擎相较于 InnoDB 有什么优势?在什么场景应用?
TokuDB 优势:
高压缩比: 压缩比可达 15 倍以上,节省存储空间
高性能:插入数据性能优于 InnoDB
适用场景:
监控系统(如 Zabbix): 用于存储历史数据和监控数据
归档库:用于存储历史数据,减少存储成本
1.4.4 MySQL 的碎片是如何产生的?你是如何处理的?
产生原因:
删除操作:
DELETE语句删除数据后,空间未被回收,导致碎片产生
更新操作:
更新数据时,可能导致数据页分裂
其他原因
原表长时间不更新,其他的表在插入数据后,原表又插入新数据量
处理方法:
表优化:
使用
OPTIMIZE TABLE命令整理表碎片使用
alter table table_name engine='innodb'命令整理表碎片
表分区:
对大表进行分区,减少单个分区的碎片
定期归档:
使用工具如
pt-archiver将旧数据归档到其他表或库
1.4.5 简述 InnoDB 物理存储结构
日志文件:
Redo 日志:用于记录数据页的变更,支持崩溃恢复。
Undo 日志:用于支持事务回滚。
临时表空间
ibtmp1:可以存储临时表数据信息(排序操作 连表 子查询 -- 内存)
可以保存用户连接时,查询数据信息
利用临时表,可以快速恢复内存数据,减少IO消耗
用户表空间:
.ibd文件:存储表数据和索引.frm文件:存储表结构。早期:ibd文件只保存数据信息 (表.ibd 表.frm(存储表结构信息) 表名.MYI (存储索引信息)?)
当前:ibd文件只保存数据信息 保存表的结构信息 保存表的索引信息
系统表空间:
ibdata1早期: 用于存储数据库服务所有数据信息(元数据信息 数据信息)
当前:用于change buffer数据信息(存储内存区域中的数据)
缓冲池文件:
ib_buffer_pool将内存区域对应buffer_pool中存在的信息(热点数据信息),可以快速恢复
双写缓冲区文件:
ib_logfile*可以保证内存数据到磁盘中,不会出现损坏的数据,避免数据库异常宕机的数据无法加载情况;(利用CR机制)
1.4.6 简述 InnoDB 内存结构?
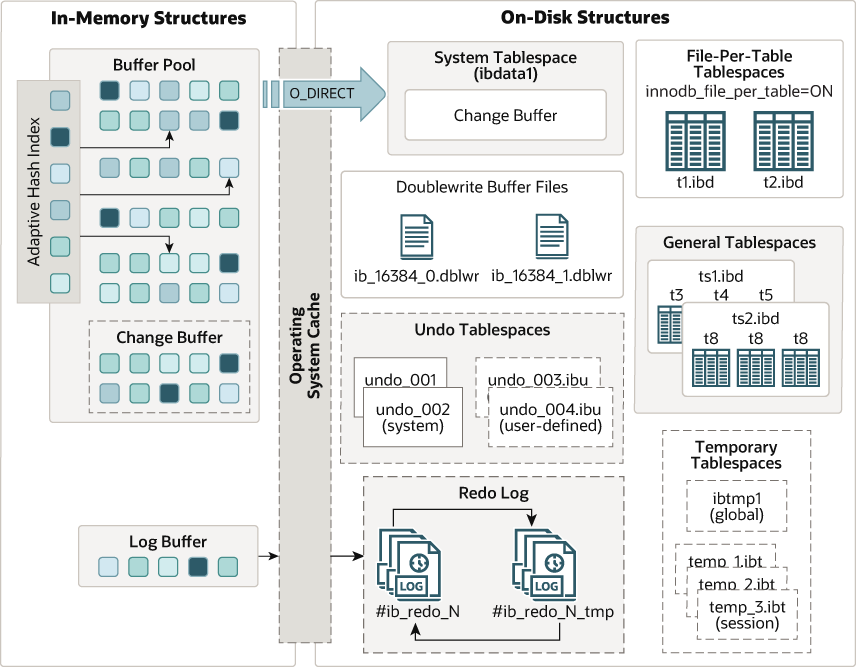
Buffer Pool 存储磁盘中加载数据页信息
Change Buffer 可以给内存区域的热点数据页建立索引,便于从buffer pool区域快速找到所需数据页
Log Buffer 可以减少辅助索引的频繁变更情况,降低对数据业务操作的影响
Adaptive Hash Index 会将数据库产生日志信息先保存到日志缓冲区,在把缓冲区数据写入到磁盘,减少IO消耗
1.4.7 InnoDB 的共享表空间在不同版本有什么变化?
| 版本 | 内容 |
|---|---|
| 5.5 | 包含:系统表、双写缓冲区、Undo 日志、变更缓冲区、临时表空间、用户数据 |
| 5.6 | 包含:系统表、双写缓冲区、Undo 日志、变更缓冲区、临时表空间 |
| 5.7 | 包含:系统表、双写缓冲区、Undo 日志、变更缓冲区 |
| 8.0.19 | 包含:双写缓冲区、变更缓冲区 |
| 8.0.20 | 包含:变更缓冲区 |
1.4.8 简述表空间迁移的过程
示例:将源端 3306/test/t100W 表迁移到目标端 3307/test/t100W
锁定源端表:
xxxxxxxxxxFLUSH TABLES t100W FOR EXPORT;目标端创建相同的库表结构:
xxxxxxxxxxCREATE TABLE t100W (...);删除目标端的空表空间文件:
xxxxxxxxxxrm -f /path/to/3307/test/t100W.ibd拷贝源端的
.ibd文件到目标端目录:xxxxxxxxxxcp -a /path/to/3306/test/t100W.ibd /path/to/3307/test/设置文件权限:
xxxxxxxxxxchown mysql:mysql /path/to/3307/test/t100W.ibd目标端导入表空间:
xxxxxxxxxxALTER TABLE t100W IMPORT TABLESPACE;解锁源端表:
xxxxxxxxxxUNLOCK TABLES;
1.4.10 共享表空间如何扩容?
修改配置文件
my.cnf:xxxxxxxxxxinnodb_data_file_path = ibdata1:12M:autoextend重启 MySQL 服务以生效
1.4.11 如何独立 Undo 表空间?
直接在配置文件中添加独立的 Undo 表空间配置:
xxxxxxxxxxinnodb_undo_tablespaces = 2重启 MySQL 服务
1.4.12 MySQL 的 Doublewrite Buffer 是什么?它有什么作用?
本质:一种内存与磁盘结合的 数据备份机制,通过两次写入(内存→Doublewrite buffer/共享表空间(早期)→数据文件)确保数据页的原子性
机制
写入流程:
内存拷贝:脏页从 Buffer Pool 复制到 Doublewrite Buffer 内存区
顺序写盘:Doublewrite Buffer 内存数据批量顺序写入(共享表空间(ibdata)中的 Doublewrite Files 早期) / /Doublewrite buffer
实际写入:最后将数据写入目标数据文件(.ibd)
崩溃恢复:若数据文件页损坏,通过 Doublewrite Files 中的完整副本恢复损坏页
与 redo log 协作
分工明确:
redo log:记录 逻辑修改(如事务操作),用于崩溃后重放事务
Doublewrite:保存 物理页完整副本,解决页损坏问题
恢复优先级:
崩溃后先检查页是否损坏,若损坏则从 Doublewrite Files 恢复;若未损坏,则通过 redo log 重放事务
1.4.13 从 MySQL 获取数据,是从磁盘读取的吗?(buffer pool)
数据读取流程
优先访问 Buffer Pool
当执行 SQL 查询时,MySQL 首先检查 Buffer Pool(内存缓存区)中是否存在目标数据页。
若存在(缓存命中),直接返回内存中的数据,无需磁盘 I/O。
缓存未命中时触发磁盘读取
若 Buffer Pool 中无目标数据页,触发磁盘 I/O:
从磁盘加载 16KB 的完整数据页(包含目标数据)到 Buffer Pool 的空闲缓存页
更新 Free 链表(空闲缓存页管理)和 哈希表(缓存页映射关系)
返回数据给客户端,并将该页加入 LRU 链表(最近最少使用管理)的热数据区域
1.4.14 MySQL 中的 Log Buffer 是什么?它有什么作用?
Log Buffer
本质:一个内存缓冲区,默认大小 16MB(由参数 innodb_log_buffer_size 控制)
存储内容:事务执行过程中产生的 redo log 记录(记录数据页的物理修改操作)
生命周期:事务提交或后台线程周期性刷盘时,将缓冲区内容写入磁盘的 redo log 文件
作用
| 作用 | 说明 |
|---|---|
| 减少磁盘 I/O | 批量合并多次事务的日志写入,避免每次提交都触发磁盘操作,提升高并发场景下的吞吐量。 |
| 支持事务持久性 | 确保事务提交后修改不丢失(通过参数 innodb_flush_log_at_trx_commit 控制刷盘策略)。 |
| 加速崩溃恢复 | 即使数据库崩溃,未刷盘的 redo log 仍可能存在于 Log Buffer,结合磁盘日志恢复数据一致性。 |
| 优化大事务性能 | 大型事务(如批量插入)的日志可暂存于 Log Buffer,避免频繁刷盘带来的性能抖动。 |
1.4.15 MySQL 中如何解决深度分页的问题?
MySQL 深度分页问题的本质是 大量无效数据扫描导致性能下降(如 LIMIT 100000,10 需要遍历前 10 万行再丢弃)
解决方法
1.优化 SQL 结构
子查询 + 覆盖索引 先通过子查询在索引中快速定位起始 ID,再回表查询数据,避免全表扫描
INNER JOIN 延迟关联 将子查询结果作为临时表,通过主键关联减少回表次数。
2.分页策略调整
标签记录法(游标分页) 记录上一页最后一条记录的 ID 或时间戳,作为下一页的查询起点
3.索引优化
覆盖索引(Covering Index) 查询字段全部包含在索引中,无需回表。
4.业务与架构优化
禁止深度跳页
前端限制最大页码(如只展示前 100 页)
后端拦截异常偏移量(如 offset > 100000 时直接拒绝)
适用场景:用户无需精确跳转页数(如资讯类 APP 瀑布流)
5.分库分表 + 异步预加载
数据按时间或 ID 分片,缩小单次查询范围
后台异步预加载下一页数据到缓存
1.4.16 什么是 Write-Ahead Logging (WAL) 技术?它的优点是什么?MySQL 中是否用到了 WAL?
Write-Ahead Logging (WAL) 是一种数据持久化技术,核心思想是在实际数据修改前,先将操作记录写入日志文件,确保即使系统崩溃也能通过日志恢复数据的一致性
MySQL 的 InnoDB 存储引擎通过 Redo Log 实现了 WAL 机制,具体表现为:
崩溃恢复: 事务提交时,先写入 Redo Log 并标记为“已提交”,再异步将数据页刷盘。若崩溃,重启后通过 Redo Log 重放未落盘的事务
两阶段提交: 与 Binlog 协作时,Redo Log 记录 Prepare 状态,Binlog 写入成功后标记 Redo Log 为 Commit,确保跨日志一致性
1.4.17 MySQL 的查询优化器如何选择执行计划?
将 SQL语句解析为解析树
预处理,包括语法检查、权限验证、查询重写(例如常量表达式计算、子查询展开 等)
生成多个执行计划,并选择成本最低的执行计划。
MySQL会根据成本来选择最终应用的索引,这里成本主要包括 I/0 成本和 CPU 成本
扫描行数*0.2+数据长度/16kb=成本
1.4.18 MySQL 三层 B+ 树能存多少数据?
假设每个叶子节点100 条数据 非叶子节点1000 条数据 大约有 10亿条数据
1.4.19 什么是数据库的逻辑删除?数据库的物理删除和逻辑删除有什么区别?
逻辑删除是一种将数据标记为已删除但实际不会从数据库中移除的删除方式。一般是在表中 添加一个表示删除状态的字段,如 is deleted ,默认是 0 表示末删除,1 表示已删除
物理删除则是直接从数据库中删除记录 一般业务上都是使用逻辑删除,便于后续的数据分析、追溯等
1.4.20 表空间迁移的背景?
包含数据目录的那个文件系统已满,需要移动到拥有更大的容量的文件系统上
有助于减少单个磁盘故障造成的损坏
1.4.21 独立表空间迁移中 5.7 版本的数据库如何迁到 8.0 版本的数据库?N
先通过同版本实例迁移独立表空间,在通过inplace 方式升级到 8.0 数据库中
1.4.22 如何调整buffer pool区域大小, 建议设置多大比较合理?
通用建议: 给Buffer Pool分配机器内存的50%-60%,剩余内存留作其他用途。
更高负载: 如果系统负担较大,可以考虑将Buffer Pool设置为内存的70%-75%。
关键参数介绍
innodb_buffer_pool_size
定义了InnoDB使用的缓冲池总大小。
默认值较小(如128MB),但在生产环境中应该根据实际情况进行调整。
innodb_buffer_pool_instances
控制Buffer Pool的实例数量。
每个实例有自己的链表管理,互不干扰。
默认值取决于innodb_buffer_pool_size,通常小于1G时默认为1。
innodb_buffer_pool_chunk_size
缓冲池的增长单元大小,默认为128MB。
MySQL 5.7.5及以上版本支持动态调整Buffer Pool大小
1.4.23 如何调整Change buffer区域大小,建议设置多大比较合理?
设置
innodb_change_buffer_max_size = 25 默认
innodb_change_buffer_max_sizeis set to 25. The maximum setting is 50更改change buffer 大小的时候 需要判断调整change buffer 后会不会影响到 buffer pool 命中率
设置建议
| 场景类型 | 推荐值 | 原因 |
|---|---|---|
| 写多读少(如日志类) | 30%-40% | 高频DML操作可提升非唯一索引写入效率,减少磁盘IO |
| 读多写少 | 默认25%或更低(如15%) | 避免占用过多缓冲池空间,优先保障数据页缓存 |
| 高并发混合负载 | 25%-35% | 平衡读写性能,避免单一资源过度消耗 |
| 内存紧张/SSD存储 | ≤25%甚至关闭(设为0) | SSD低延迟可抵消部分收益,减少内存占用;关闭后强制实时加载数据页保证一致性 |
1.4.24 Innodb 页的结构有哪些部分,都有什么作用?
一个标准的 InnoDB 数据页大小通常是 16 KB,默认情况下可以通过 innodb_page_size 参数进行配置。数据页被划分为以下几个部分:
File Header(文件头部)
位置:位于数据页的开头
大小:固定占用 38 字节
作用:
存储关于整个文件的一般信息
包含页的标识符(如页号、上一页和下一页的页号)、校验和以及其他元数据
Page Header(页面头部)
位置:紧跟在 File Header 之后
大小:固定占用 56 字节
作用:
记录特定于某个数据页的状态信息
包括页内记录的数量、第一个记录的位置、最后一个记录的位置、页目录中槽的数量等
Infimum and Supremum Record Headers(最小和最大记录头)
位置:紧随 Page Header 之后
大小:每个记录头固定占用 26 字节,共 52 字节
作用:
Infimum 是一个虚拟的最小记录,Supremum 是一个虚拟的最大记录
它们帮助维护 B-tree 结构的有序性,简化插入和删除操作
User Records(用户记录)
位置:介于 Infimum 和 Supremum 之间
大小:动态变化,取决于实际存储的数据量
作用:
存储用户的实际数据记录
每条记录包含记录头信息和具体的字段数据
Gap Locks List(间隙锁列表)
位置:跟随 User Records
大小:动态变化
作用:
支持事务隔离级别下的并发控制
记录间隙锁的相关信息,防止幻读现象的发生
Heap(堆区)
位置:靠近数据页末尾
大小:动态变化
作用:
存储临时变量和其他内部使用的数据
助力优化查询性能和内存管理
Record Free Space(记录自由空间)
位置:分布在 Heap 和其他区域之间的空白区域
大小:动态变化
作用:
提供可用于未来插入新记录的空间
减少频繁的页分裂操作,提高效率
Page Directory(页目录)
位置:靠近数据页末尾
大小:动态变化
作用:
帮助快速定位记录
使用数组形式存储每条记录的指针,加速搜索过程
Fill Factor(填充因子)
位置:隐式存在于各个组件间
作用:
控制数据页内的紧凑程度。
平衡数据分布,减少碎片化
Checksum(校验和)
位置:某些版本的 InnoDB 在数据页末尾添加校验和
作用:
确认数据完整性和一致性
预防数据损坏,在备份还原过程中尤为重要
1.4.25 Innodb 存储引擎中的buffer pool 能介绍一下吗?
1.4.26 链表和数组相比,链表和数组适用于的什么访问?
1.4.27 SQL语句扫描行太多,回表次数太多如何解决?
xxxxxxxxxx1. 建立合适的联合索引,尽可能将查询条件的数据包含在联合索引中2. 精细查询条件,尽量使用等值查询,符合联合索引规则,覆盖的列越多越好3. 索引优化器:- **ICP(Index Condition Pushdown)**:索引下推优化- **MRR(Multi-Range Read)**:在辅助索引阶段获取主键值后排序回表
1.4.28 在执行器中是怎么生成的执行计划?
1.4.29 MySQL的存储机制和MySQL的索引的存储机制?(mysql的表数据存在哪?索引数据在哪⾥?落到磁盘展现形式)
1.4.30 缓冲池机制?
1.4.31 缓冲池为了加快查询或写⼊速度,⼀般先写⼊缓冲池。那么缓冲池和磁盘之间的数据差异,通过什么样的机制去保证数据的⼀致性?
1.4.32 你们⼀般将缓冲池设置成多少?你们的机器规格是多⼤?
1.4.33 MySQL 的 Change Buffer 是什么?它有什么作用?
概述
MySQL 的 Change Buffer(有时在旧版本中称为 Insert Buffer)是 InnoDB 存储引擎的一项优化机制,专门用于缓存对非唯一的二级索引页的修改操作
当执行诸如 INSERT、DELETE 或 UPDATE 等修改二级索引的操作时,如果目标索引页不在 Buffer Pool 中,InnoDB 不会立即读取该页进行修改,而是先将这些修改(例如新增、删除或更新的索引项)记录在 Change Buffer 中。待该索引页后续加载到内存时,系统会将 Change Buffer 中的记录合并到索引页中
主要作用
减少磁盘 I/O 操作:避免了因缺页而频繁进行的随机读取,降低了磁盘访问次数。
提高写入性能:通过批量合并修改,降低了写操作的开销,从而提升系统在写密集型场景下的整体吞吐量。
改善系统并发性:在高并发插入和修改操作下,通过缓冲和合并操作减少了对磁盘的直接写入压力。
需要注意的是,Change Buffer 仅对非唯一的二级索引生效,因为主键数据(聚集索引)的修改操作直接写入数据页,不经过 Change Buffer
1.4.35 索引树的高度多少合适?
对于B+ 数来说 索引的树的高度一般来说控制在4层以内
1.4.36 innodb的核心特性?
日志
1.5.1 如何配置开启通用日志,二进制日志,错误日志,慢查询日志?
配置
xxxxxxxxxx[mysql]# 通用日志general_log=ONgeneral_log_file=/data/3306/log/general.log# 错误日志:默认创建log_error=/data/3306/log/error.log# 二进制日志log_bin=/data/3306/log/binlog# 开启慢查询日志功能slow_query_log# 指定慢查询日志路径/名称slow_query_log_file# 定义超过多长时间执行的语句就是慢查询语句long_query_time# 当没有走索引的查询语句也要记录到慢查询日志log_queries_not_using_indexes 如何查看二进制日志
1.5.2 如何查看二进制日志
在数据库中查看
show binary logs查看数据库生成哪些二进制日志show master status查看数据库中正在加载的二进制的日志show binlog events in binlog.000002查看具体 binlog 文件中的内容
在命令行中进行查看
mysqlbinlog --base64-output=decode-rows -vvv binlog.0000002
1.5.3 binlog二进制日志有哪些格式?有什么区别?你们公司用什么格式?
ROW 行格式进行信息记录 (RBR) DML语句不能直接记录
STATEMENT 语句格式进行信息记录 (SBR) DML语句可以直接记录
MIXED 混合格式进行信息记录 (MBR) 根据DML语句的应用情况 会自动选择明文 和 编码方式记录
RBR:
Row-Based Replication,基于行的复制SBR:
Statement-Based Replication,基于语句的复制MBR:
Mixed-Based Replication,混合复制
选择
公司通常使用 行模式(
ROW)
xxxxxxxxxxbinlog_format 定义binlog日志的格式信息mysql> select @@binlog_format;+------------------------+| @@binlog_format |+------------------------+| ROW |+------------------------+1 row in set (0.00 sec)-- 在进行主从同步数据恢复时,此参数配置可能会影响数据恢复的一致性问题;-- 此参数信息是有三种方式进行配置的,确定了主从复制的级别,只针对DML语句的日志才有效;-- 参数信息配置 statement(SBR):语句格式记录binlog;create database xiaoQ; -- DDL DCL语句只能使用statement 表示的就是原原本本的语句信息,即做什么就记录什么;-- 参数信息配置 row(RBR):行格式记录binlog(默认模式)update t1 set a=10 where id<10; -- 会记录行的变化信息,属于底层的记录信息,可能会有多个变化日志信息记录-- 参数信息配置 mixed(MBR):混合格式记录binlog -- 由数据库服务自行决定,是记录语句信息,还是记录行的变化信息;
1.5.4 二进制日志如何切割
编写脚本实现日志切割
mysql -uroot -p123123 -S /tmp/mysql3306.sock -e 'flush logs'mysqladmin -uroot -p123123 -S /tmp/mysql3306.sock flush-logs
设置数据库服务配置项实现切割
max_binlog_size定义binlog日志大小进行切割binlog_expire_logs_seconds按照秒确认日志切割时间,超过配置时间会自动清理expire_log_days按照天确认切割日志时间,超过配置时间会自动清理
1.5.5 二进制日志如何清理
手动清理
purge binary logs to 'binlog.00000026'
配置项清理
binlog_expire_logs_seconds按照秒确认日志切割时间,超过配置时间会自动清理expire_log_days按照天确认切割日志时间,超过配置时间会自动清理
1.5.6 二进制日志相关配置有哪些?
开关
log_bin=/data/3306/log/binlog日志刷盘
sync_binlog = 1如果为1 表示每次事务提交,立即刷新日志到磁盘中(此方式更加安全)IO消耗更大。
自动清理
binlog_expire_logs_seconds按照秒确认日志切割时间,超过配置时间会自动清理expire_log_days按照天确认切割日志时间,超过配置时间会自动清理
日志格式
默认就是ROW 无需改变
日志大小
max_binlog_size:设置日志文件大小,自动轮询
1.5.7 什么是双一配置?
sync_binlog = 1
如果为0表示由操作系统缓存自己决定,什么时候刷新日志到磁盘中(binlog 文件中)
如果为1 表示每次事务提交,立即刷新日志到磁盘中(此方式更加安全)IO消耗更大
如果为N 表示每组事务提交,按找组的事务次数定义,确定刷新日子到磁盘中的频次
innodb_flush_log_at_trx_commit = 1
设置为0 :表示每次事务提交时不进行刷盘操作(系统默认master thread每隔1s进行一次重做日志的同步)
设置为1 :表示每次事务提交时都将进行同步,刷盘操作( 默认值 )
设置为2 :表示每次事务提交时都只把 redo log buffer 内容写入 page cache,不进行同步。由os自
己决定什么时候同步到磁盘文件
1.5.8 你是如何截取二进制日志的?与GTID 有什么不同点?
传统方式
截取方式
按时间和位置截取:
mysqlbinlog --start-datetime="2024-01-01 00:00:00" --stop-datetime="2024-01-02 00:00:00" binlog.000001
GTID方式
截取方式
mysqlbinlog --skip-gtids --include-gtids='your_gtid_set' binlog.000001
不同点
传统日志:
按时间和位置记录
时间不准确,位置仅在一个文件中唯一
截取和主从复制较复杂
GTID:
全局唯一,不会重复,具备幂等性
截取和主从复制更简单
1.5.9 如何配置慢查询?
参数配置
xxxxxxxxxxslow_query_log = ONlong_query_time = 1log_queries_not_using_indexes = ONlog_throttle_queries_not_using_indexes = 10slow_query_log_file = /path/to/slow.logmin_examined_row_limit = 801.5.10 慢日志如何处理?慢日志在什么时候使用,如何用?
处理方式:
使用 ELK(Elasticsearch、Logstash、Kibana)收集和分析慢日志
解决慢查询:
与开发团队合作,优化 SQL 语句
建立索引。
预防慢查询:
建立 SQL 审核机制(如使用
yearning平台)提交工单审核
招聘开发且强调DBA水平
参与库表设计,优化初始索引
使用 Redis 缓存
搜索框使用 Elasticsearch(ES)
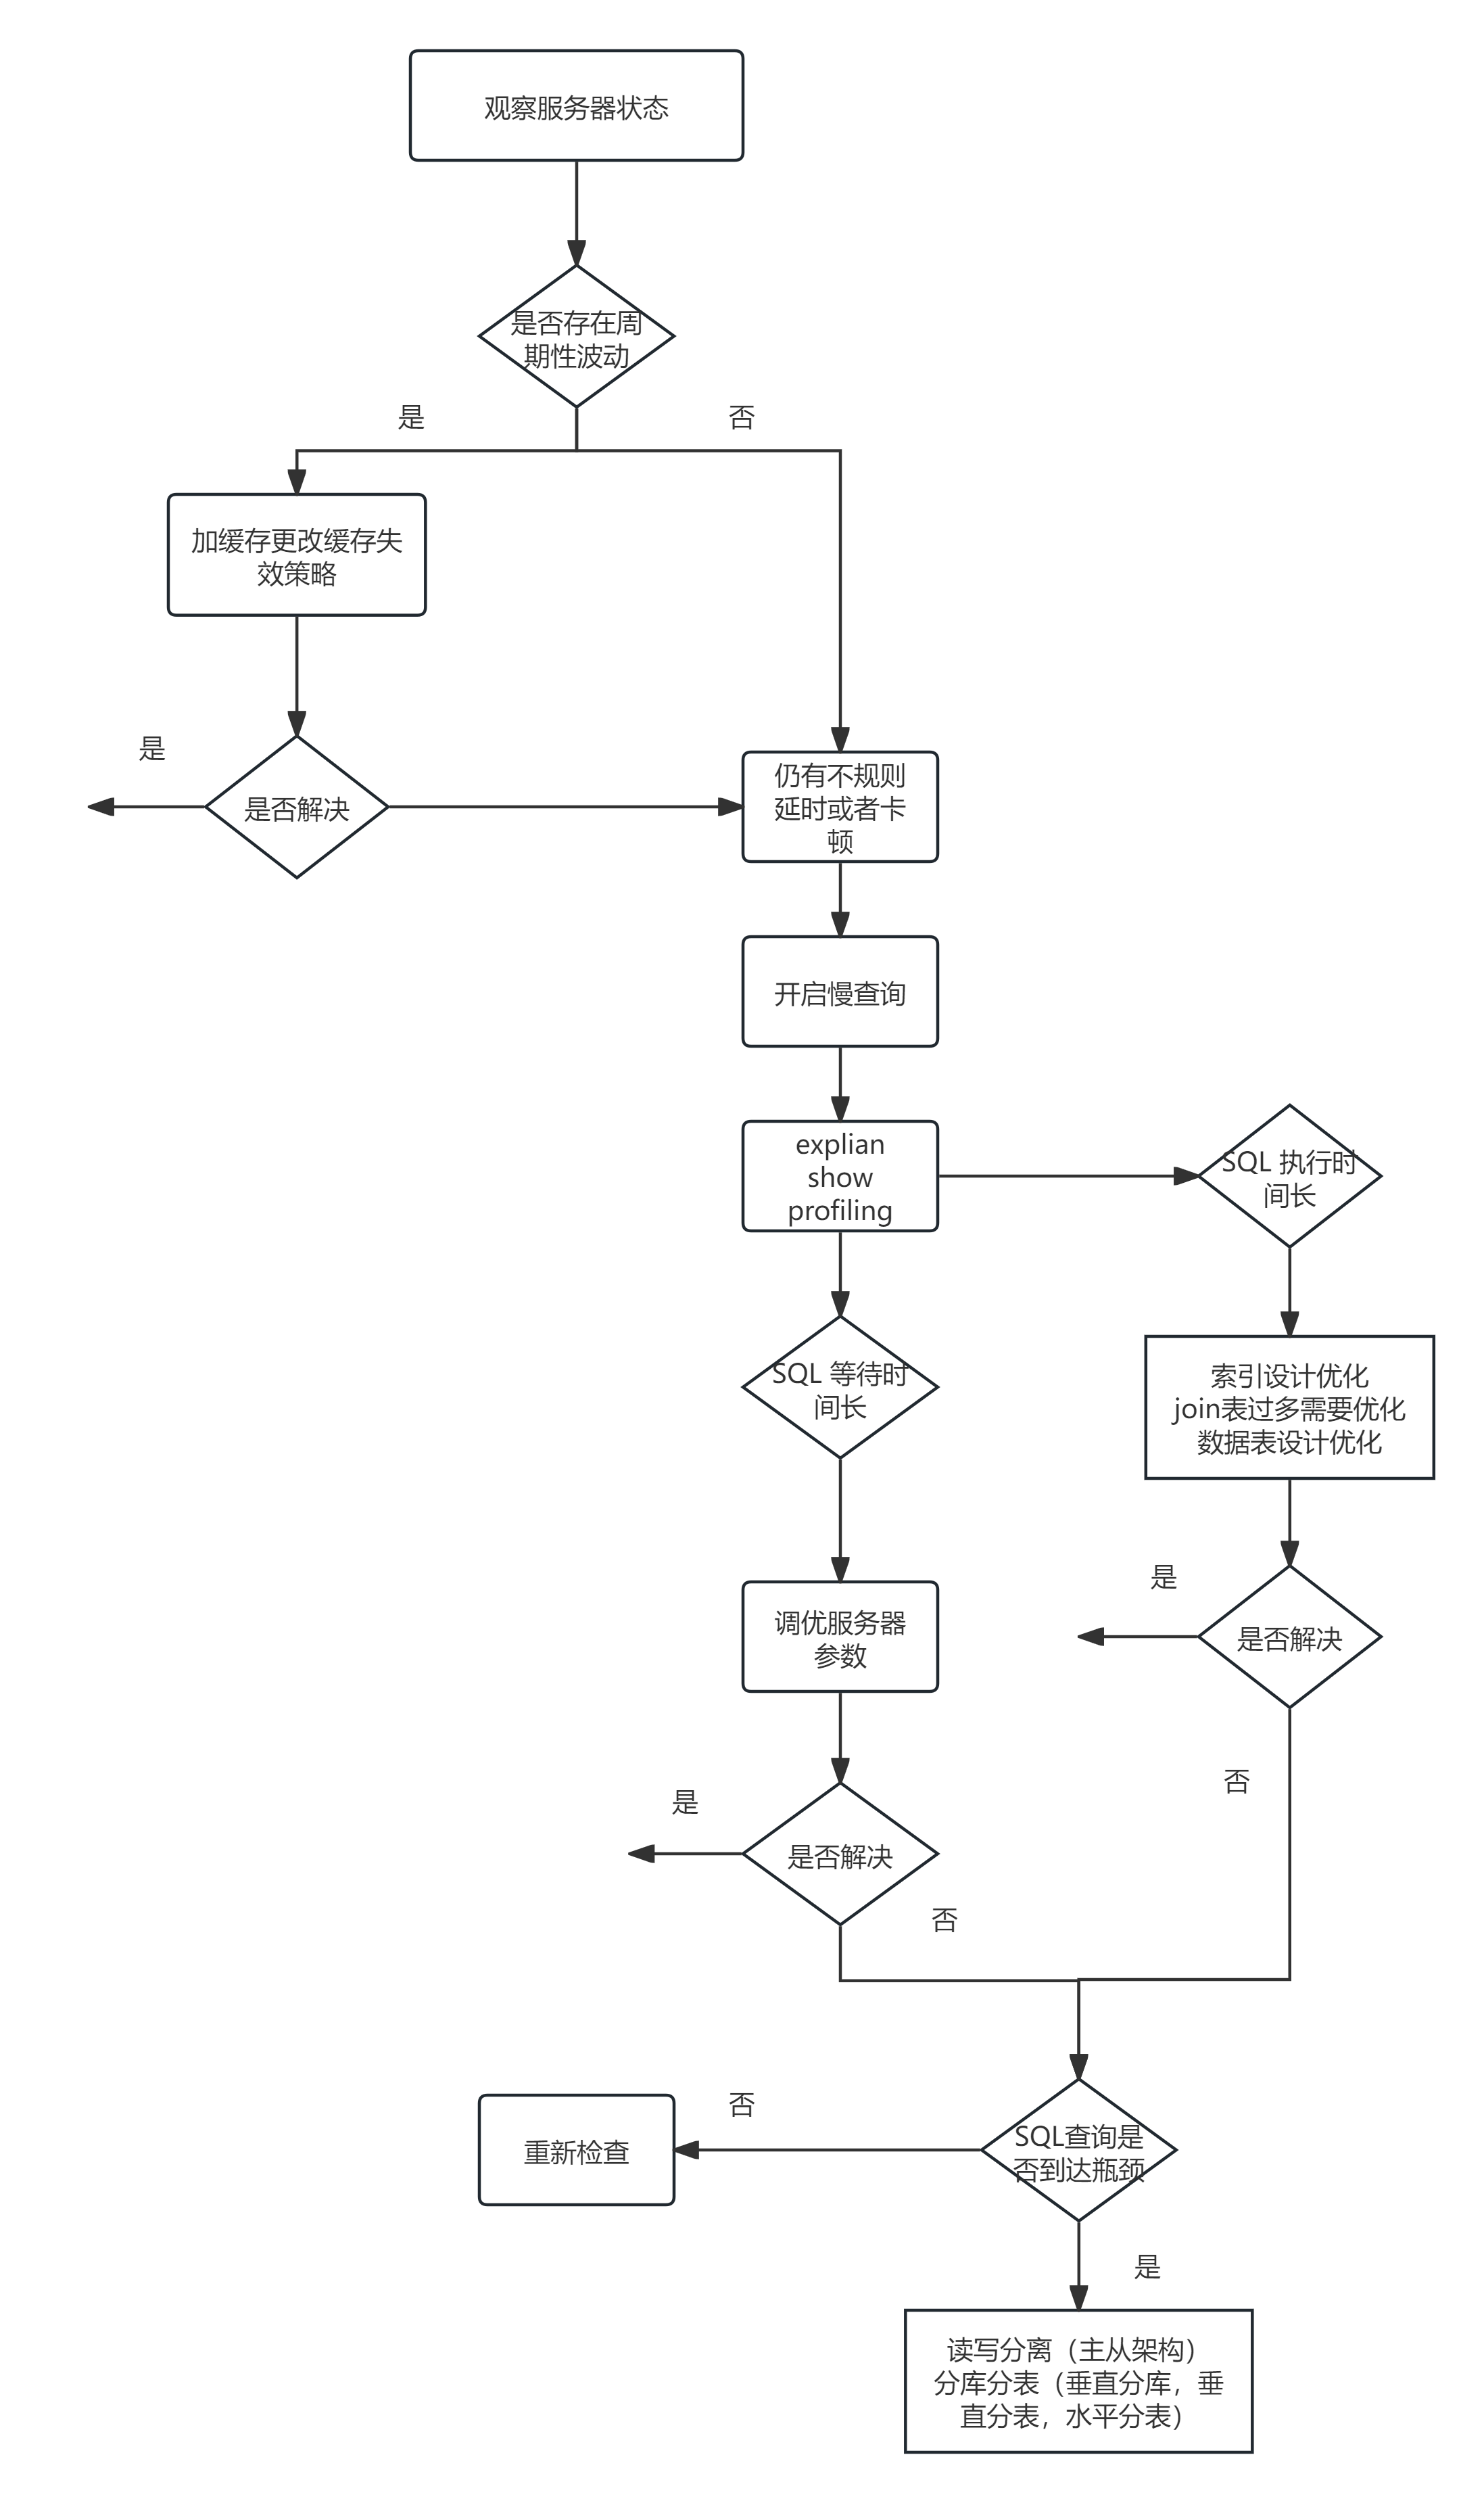
1.5.11 数据库优化流程?
1.5.12 慢日志的配置参数?
slow_query_log = ON
slow_query_log_file = /xxx
long_query_time = 1
log_queries_not_using_indexes = ON
log_throttle_queries_not_using_indexes = 10 -- 不走索引的相同索引语句只记录指定的次数
1.5.13 SBR(statement-based replication)与RBR(Row-Based Replication)记录的优缺点分析 ?
| 记录方式 | 优点说明 | 缺点说明 |
|---|---|---|
| SBR | 可读性强,日志量相对较少; | 数据信息可能不准确,数据一致性不足 |
| RBR | 数据信息记录更准确,数据一致性更强 | 可读性弱,日志量相对较多,数据记录准确 |
| 举例说明 | update t1 set a=10 where id<10000; 记录一条语句即可 | insert into 随机数函数; |
| 举例说明 | update t1 set a=10 where id<10000; 记录多条语句修改信息,生成日志 | insert into 随机数函数; |
数据备份与恢复
1.6.1 你在备份这块都做过什么具体工作?/你公司的备份策略?
备份策略:
小于 50G: 按天使用
mysqldump进行全量备份 保留binlog3-7 天50G-200G: 按天使用
xtrabackup进行物理备份 保留binlog3-7 天超过 200G:按周使用
xtrabackup进行物理备份 + 增量备份 保留binlog7-15 天主从复制备份: 解决物理损坏问题
解决物理损坏问题
延迟从库备份: 解决逻辑问题(如误操作)
解决逻辑问题(如误操作)
增量备份:使用逻辑备份(
mysqldump)或xtrabackup增量备份 保留binlog3 天或 2 周,适合大数据量增量备份每隔一小时,全备一周或一天或30天
1.6.2 你们公司使用什么工具备份 / 备份策略?
备份工具:
mysqldump:逻辑备份工具xtrabackup:物理备份工具Clone Plugin:用于快速克隆数据库实例
备份策略
主从复制备份,解决物理损坏
延时从库备份,解决逻辑问题
增量: 逻辑备份增量备份
Xtrabackup增量:是基于上一次备份LSN变化过的数据页进行备份,在备份同时产生的新变更,会将redo备份
属于全备中的xtrabackup增量备份,不能代替binlog备份,备份binlog保留3天或2周,适合大数据量
1.6.3 请介绍 mysqldump 核心参数:--master-data 和 --single-transaction 的功能?
--master-data:自动记录备份前的
binlog位置点自动加全局读锁(
FLUSH TABLES WITH READ LOCK)配合
--single-transaction减少锁时间(仅适用于 InnoDB 引擎)
--single-transaction:对于 InnoDB 数据,自动解锁
FTWRL,对数据进行快照备份调整隔离级别为
REPEATABLE READ,确保备份一致性
1.6.4 请简述 mysqldump 备份原理
Flash Tables 刷新表
关闭实例上所有打开表,为第二步做准备,防止因为长查询或者大事务导致表无法关闭,进而长期持有全局锁
Flash Tables with Read Lock
加全局读锁,关闭实例上所有打开表,阻止commit 为了获取DB 一致性状态
Set Session Transaction Isolation Level Repeatable Read
确保事务中任何数据都相同
--single-transaction参数的作用,设置事务的隔离级别为可重复读, 即REPEATABLE READ,这样能保证在一个事务中所有相同的查询读取到同样的数据, 也就大概保证了在dump期间,如果其他innodb引擎的线程修改了表的数据并提交, 对该dump线程的数据并无影响
start transaction 获取当前数据库的快照
single-transaction 设置时生效
获取当前数据库的快照,这个是由mysqldump中--single-transaction决定的。
WITH CONSISTENT SNAPSHOT能够保证在事务开启的时候,第一次查询的结果就是
事务开始时的数据A,即使这时其他线程将其数据修改为B,查的结果依然是A。简而言之,就是开启事务并对所有表执行了一次SELECT操作,这样可保证备份时, 在任意时间点执行select * from table得到的数据和 执行START TRANSACTION WITH CONSISTENT SNAPSHOT时的数据一致。【注意】,WITH CONSISTENT SNAPSHOT只在RR隔离级别下有效
obtain Log postion
Master-data:获取备份实例的position信息
--master-data=2表示在dump过程中记录主库的binlog和pos点,并在dump文件中注释掉这一行;
--master-data=1表示在dump过程中记录主库的binlog和pos点,并在dump文件中不注释掉这一行,即恢复时会执行;
dump-slave:获取备份实例的slave的position信息
--dump-slave=2表示在dump过程中,在从库dump,mysqldump进程也要在从库执行, 记录当时主库的binlog和pos点,并在dump文件中注释掉这一行;
--dump-slave=1表示在dump过程中,在从库dump,mysqldump进程也要在从库执行, 记录当时主库的binlog和pos点,并在dump文件中不注释掉这一行;
unlock tales
释放全局锁
从数据库中获取数据信息
利用相应数据对象的查询语句,获取数据库中的操作对象,将对应数据创建的SQL语句进行保存;
1.6.5 mysqldump 是否属于热备份?
严格意义上不属于热备份:只能备份快照之前的数据,备份过程中产生的数据无法备份。真正的热备份可以备份备份过程中产生的数据
1.6.6 mysqldump 是否需要锁表?
备份表的数据时不需要锁表:仅备份表结构及非 InnoDB 引擎数据时,需要使用
FTWRL
1.6.7 请介绍 xtrabackup 工具的备份原理
全量备份
启动 XtraBackup 进程:
创建一些临时文件来跟踪备份进度和状态。
复制 .ibd 文件 (XtraBackup 分配多个线程来并行复制 InnoDB 表空间文件(.ibd 文件))
在复制 .ibd 同时,一个单独的线程负责监视和复制 REDO 日志文件 ,记录LSN (ib_logfile0, ib_logfile1 等),以捕获备份过程中产生的所有变更
全局读锁,执行LOCK INSTANCE FOR BACKUP(8.0取代了 FLUSH TABLES WITH READ LOCK);
备份非InnoDB文件 在全局只读状态下,XtraBackup 备份 MyISAM 表、触发器、视图、存储过程等非 InnoDB 文件
获取binlog位置信息;
记录当前 REDO 日志的位置,以便将来进行增量备份或其他恢复操作
执行UNLOCK INSTANCE释放锁;
移除不再需要的临时文件
创建备份元数据文件,记录备份的重要信息,如备份时间戳、REDO 日志位置等
执行基本的完整性检查,确保备份文件无误
官方原文
https://docs.percona.com/percona-xtrabackup/8.4/how-xtrabackup-works.html
Percona XtraBackup is based on InnoDB’s crash-recovery functionality. It copies your InnoDB data files, which results in data that is internally inconsistent; but then it performs crash recovery on the files to make them a consistent, usable database again.
This works because InnoDB maintains a redo log, also called the transaction log. This contains a record of every change to InnoDB data. When InnoDB starts, it inspects the data files and the transaction log, and performs two steps. It applies committed transaction log entries to the data files, and it performs an undo operation on any transactions that modified data but did not commit.
The --register-redo-log-consumer parameter is disabled by default. When enabled, this parameter lets Percona XtraBackup register as a redo log consumer at the start of the backup. The server does not remove a redo log that Percona XtraBackup (the consumer) has not yet copied. The consumer reads the redo log and manually advances the log sequence number (LSN). The server blocks the writes during the process. Based on the redo log consumption, the server determines when it can purge the log.
Percona XtraBackup remembers the LSN when it starts, and then copies the data files. The operation takes time, and the files may change, then LSN reflects the state of the database at different points in time. Percona XtraBackup also runs a background process that watches the transaction log files, and copies any changes. Percona XtraBackup does this continually. The transaction logs are written in a round-robin fashion, and can be reused.
Percona XtraBackup uses Backup locks where available as a lightweight alternative to FLUSH TABLES WITH READ LOCK. MySQL 8.4 allows acquiring an instance level backup lock via the LOCK INSTANCE FOR BACKUP statement.
Locking is only done for MyISAM and other non-InnoDB tables after Percona XtraBackup finishes backing up all InnoDB/XtraDB data and logs. Percona XtraBackup uses this automatically to copy non-InnoDB data to avoid blocking DML queries that modify InnoDB tables.
Important
The BACKUP_ADMIN privilege is required to query the performance_schema_log_status for either LOCK INSTANCE FOR BACKUP or LOCK TABLES FOR BACKUP.
xtrabackup tries to avoid backup locks and FLUSH TABLES WITH READ LOCK when the instance contains only InnoDB tables. In this case, xtrabackup obtains binary log coordinates from performance_schema.log_status. FLUSH TABLES WITH READ LOCK is still required in MySQL 8.4 when xtrabackup is started with the --slave-info. The log_status table in Percona Server for MySQL 8.4 is extended to include the relay log coordinates, so no locks are needed even with the --slave-info option.
See also
MySQL Documentation: LOCK INSTANCE FOR BACKUP
When backup locks are supported by the server, xtrabackup first copies InnoDB data, runs the LOCK TABLES FOR BACKUP and then copies the MyISAM tables. Once this is done, the backup of the files will begin. It will backup .frm, .MRG, .MYD, .MYI, .CSM, .CSV, .sdi and .par files.
After that xtrabackup will use LOCK BINLOG FOR BACKUP to block all operations that might change either binary log position or Exec_Source_Log_Pos or Exec_Gtid_Set (i.e. source binary log coordinates corresponding to the current SQL thread state on a replication replica) as reported by SHOW BINARY LOG STATUS or SHOW REPLICA STATUS. xtrabackup will then finish copying the REDO log files and fetch the binary log coordinates. After this is completed xtrabackup will unlock the binary log and tables.
Finally, the binary log position will be printed to STDERR and xtrabackup will exit returning 0 if all went OK.
Note that the STDERR of xtrabackup is not written in any file. You will have to redirect it to a file, for example, xtrabackup OPTIONS 2> backupout.log.
It will also create the following files in the directory of the backup.
During the prepare phase, Percona XtraBackup performs crash recovery against the copied data files, using the copied transaction log file. After this is done, the database is ready to restore and use.
The backed-up MyISAM and InnoDB tables will be eventually consistent with each other, because after the prepare (recovery) process, InnoDB’s data is rolled forward to the point at which the backup completed, not rolled back to the point at which it started. This point in time matches where the FLUSH TABLES WITH READ LOCK was taken, so the MyISAM data and the prepared InnoDB data are in sync.
The xtrabackup offers many features not mentioned in the preceding explanation. The functionality of each tool is explained in more detail further in this manual. In brief, though, the tools enable you to do operations such as streaming and incremental backups with various combinations of copying the data files, copying the log files, and applying the logs to the data.
恢复原理:
模拟了InnoDB Crash Recovery(CR)功能,LSN
将备份的数据文件的数据页和备份期间的记录的redo数据页对比
将备份的数据文件进行处理,执行redo log前滚和undo回滚,生成新的数据文件
复制(idb物理文件)到原有数据库的路径下面,重启,才算恢复完成
1.6.8 晚上 23:00 开始备份 mysqldump 和 xtrabackup 两个工具理论上能将数据恢复至几点?
mysqldump:快照备份,恢复到备份开始的时间点(23:00)
xtrabackup:支持备份期间的
Redo Log,恢复到备份结束的时间点(23:30)
1.6.8 xtrabackup 的增量备份是如何实现的?
增量备份原理:
用户选择一个之前的全量备份作为基准(Base Backup)
发起增量备份命令,XtraBackup 启动并初始化备份进程
XtraBackup 通过比较当前数据库的 LSN 和基线备份的 LSN,找出自上次备份以来发生变化的数据页
仅复制那些发生了变化的数据页,而不是整个数据文件,这样可以大幅减小备份体积和时间
与全量备份类似,XtraBackup 不断监视和复制新增的 REDO 日志,确保捕捉到所有变更
执行 Flush tables with read lock 暂停所有 DML 操作,确保数据的一致性,避免不必要的二进制日志写入
记录本次增量备份的起点和终点 LSN,方便未来的增量备份或恢复操作
移除不再需要的临时文件
创建备份元数据文件,记录备份的重要信息,如备份时间戳、REDO 日志位置等
执行基本的完整性检查,确保备份文件无误
1.6.9 xtrabackup 增量备份恢复要注意什么?
注意事项:
第一次增量备份依赖于全量备份
恢复时需要将所有增量备份合并到全量备份中,再统一恢复
恢复顺序必须按照备份顺序进行
1.6.10 mysqldump 和 xtrabackup 备份如何实现基于时间点的恢复?
mysqldump:使用备份文件中的
binlog位置点,结合mysqlbinlog工具截取指定时间范围的日志:xxxxxxxxxxmysqlbinlog --start-datetime='2024-01-01 00:00:00' --stop-datetime='2024-01-02 00:00:00' binlog.000001
xtrabackup:查看
xtrabackup_binlog_info文件获取备份时的binlog文件及位置。结合
mysqlbinlog截取指定时间范围的日志:xxxxxxxxxxmysqlbinlog --start-datetime='2024-01-01 00:00:00' --stop-datetime='2024-01-02 00:00:00' binlog.000001
时间点恢复的缺点:
不精确,依赖于
binlog的时间戳。实际工作中较少使用。
1.6.11 请列举数据库数据损坏场景,然后针对性地提出最佳的恢复方案(假设具有多种类型备份)?
数据损坏场景及恢复方案:
物理损坏:
硬件故障、断电、文件损坏或删除
恢复方案:
使用主从复制或高可用架构,从从库恢复数据
使用物理备份(如
xtrabackup)恢复数据
逻辑损坏:
误操作(如
DROP TABLE、DELETE、TRUNCATE)恢复方案:
使用延迟从库,从延迟从库恢复数据
使用
binlog恢复误操作前的数据(如使用binlog2sql工具)利用表空间进行数据恢复
1.6.12 如何实现分库分表,备份数据库中的表?
备份方法:
使用
information_schema.tables表,通过CONCAT拼接备份语句,实现分库分表备份。示例:
sql复制
xxxxxxxxxxSELECT CONCAT('mysqldump -u root -p --single-transaction ', table_schema, '.', table_name, ' > ', table_name, '.sql')FROM information_schema.tablesWHERE table_schema = 'your_database_name';
1.6.13 数据库宕机没有全量备份,但有物理文件,如何恢复数据?
恢复条件:
有物理文件,可以找到
.frm文件,解析出表结构语句。有物理文件,可以找到表的
.ibd文件。有目录结构,可以找到库名及对应的
.ibd文件。
恢复步骤:
准备恢复环境:
创建目标数据库和表结构。
导入表结构:
使用
CREATE TABLE语句创建表结构。
删除目标表的
.ibd文件:xxxxxxxxxxrm -f /path/to/target_database/table_name.ibd拷贝
.ibd文件到目标位置:xxxxxxxxxxcp /path/to/source_database/table_name.ibd /path/to/target_database/更改权限:
xxxxxxxxxxchown mysql:mysql /path/to/target_database/table_name.ibd导入表空间:
xxxxxxxxxxALTER TABLE table_name IMPORT TABLESPACE;恢复所有库和表:
依次操作所有库和表,恢复完整数据库
根据 Binlog 恢复增量数据:
使用
binlog恢复备份后到宕机前的增量数据
启动数据库并检查数据:
启动 MySQL 服务,检查数据完整性
1.6.14 delete 了数据库中一个表,如何恢复?
主从延时或 redo 重做日志
1.6.15 备份方案中保存 3-7 天和 7-15 天的原因,依赖什么依据这么保存的?
磁盘空间
1.6.15 mysqldump 全备时如何保证数据的不丢失?mysqldump 全备时会对业务造成影响吗?
mysqldump 全备时会调整隔离级别至 RR,让隔离性更好
1.6.16 (单表恢复)8:00全备了一张表,9:00误删除了一张小表,但有binlog,怎么恢复?
找个测试库,恢复全备的表\
Binlog2sql 解析全备后的单表 binlog,删除误删语句,恢复到测试库
导出表数据,恢复到正式库
单库恢复
mysqlbinlog –d利用第三方库,导入库表结构,恢复全备,导出需要的表
1.6.17 生产中备份的文件50G数据库,误删除了一张 t1 表,10M大小,有什么思路可以快速恢复?
从全备中恢复出t1表数据
从增量备份 binlog 中截取t1表的数据
恢复的数据不要重复不要缺少,然后先恢复 t1表全备,再恢复t1表增量日志
1.6.18 进行独立表空间迁移时遇到没有提前保存表结构信息怎么办?
解决方案
| 方法 | 具体操作 |
|---|---|
| 通过元数据提取 | 若原数据库仍可访问: - 使用 SHOW CREATE TABLE 直接导出建表语句 - 查询 information_schema.COLUMNS 表拼接字段定义 |
| 解析.frm文件 | 从原库复制.frm文件(存储表结构定义),使用工具如 mysqlfrm 解析生成建表语句(需对应MySQL版本) |
| 数据逆向推断 | 当仅剩ibd文件时: - 尝试创建同名空表并丢弃表空间 - 使用 ibd2sdi 工具解析ibd文件中的元数据(需MySQL 8.0+) |
| 第三方工具辅助 | 使用 Percona Toolkit 的 pt-show-create-table 或 Navicat 等GUI工具自动生成结构 |
1.6.19 进行独立表空间迁移时遇到数据库中有多张表如何批量进行迁移 (有多个库多个表)?
解决方案
| 场景 | 适用策略 |
|---|---|
| 同构表批量迁移 | 1. 通过脚本遍历所有库表生成迁移命令 2. 示例Shell脚本逻辑: mysqldump -h原库 -u用户 -p密码 库名 表名 --no-data > schema.sql mysql -h新库 -u用户 -p密码 库名 < schema.sql> ALTER TABLE 表名 DISCARD TABLESPACE; scp 原库ibd文件 新库对应目录 ALTER TABLE 表名 IMPORT TABLESPACE; |
| 异构表结构处理 | 1. 使用Python/Java程序连接新旧库,动态对比字段差异 2. 对缺失字段自动填充默认值或忽略(参考CSDN分页迁移方案) |
| 跨服务器迁移 | 结合 rsync 或 scp 批量传输ibd文件,通过 LOAD DATA INFILE 加速数据导入 |
| 工具自动化 | 采用 Percona XtraBackup 或 MySQL Shell Util 的 copyTables 功能实现全库/多表并行迁移 |
补充痛点:数据与文件路径映射
Windows软链接缺失:需手动修改.isl文件指向新路径(如将 ibd 文件移至E盘后,.isl内容改为 E:\new_path\table.ibd)
权限问题:迁移后需确保MySQL进程对新目录有读写权限(Linux下注意SELinux上下文)
1.6.20 为什么mysqldump 为什么不在第一次执行 flush tables 操作的时候加上锁呢?
是为了避免较长的事务操作造成FLUSH TABLES WITH READ LOCK操作迟迟得不到 锁,但同时又阻塞了其它客户端操作
1.6.21 线上备份是怎么实现的?加什么参数?
1.6.22 xtrabackup 备份过程中怎么确保数据一致性?在备份过程中有新增加的数据怎么办?新增加的数据有没有必要进进⾏备份?
1.6.23 mysqldump 进行数据补偿后,新增加的数据怎么办?
1.6.24 mysql的备份⽅式?备份⼯具?是否锁表?
分为物理备份和逻辑备份
逻辑备份 mysqldump
物理备份 xtrabackup
都会执行 Flush table with read lock
1.6.25 你们是怎么做数据恢复的?流程?⽤什么⼯具?(业务说⼏⼗万条数据删错了,你是怎么把它恢复回来)
延时从库 mysqlbinglog 导出数据
binglog2sql 数据闪回
1.6.26 mysql运⾏到⼀半,遭遇断电宕机,在做恢复的时候怎么保障mysql缓冲池中的数据落盘或者不落盘的?可能缓冲池和磁盘数据不⼀致嘛?
1.6.27 你这500G数据用什么工具备份,花费多长时间,恢复要多久?
每套500G数据 备份花费2.5--3小时 恢复6-8小时
备份和恢复数据后需要进行数据校验,通常由开发人员或运维人员使用脚本来测试,所以备份恢复项目所花费总体时间自己可以大概描述
目前总共 200+ mysql 平均每台500G数据参考rds 每日的备份所需时间根据当时服务器的性能状态所影响
1.6.28 一张表使用mysqldump备份,用什么参数保证这三张表在同一时间备份数据?
要确保在使用 mysqldump 备份多张表时,这些表的数据是在同一时刻备份的,可以使用
--single-transaction参数这个参数会在事务隔离级别为 REPEATABLE READ 的情况下启动一个事务,从而在备份过程中保证数据的一致性
假设我们要备份名为 table1、table2 和 table3 的三张表,可以使用以下命令:
mysqldump --single-transaction -u username -p database_name table1 table2 table3 > backup.sql-- username:MySQL用户名-- database_name:包含要备份的表的数据库名称-- backup.sql:输出的备份文件名
1.6.29 flush table 命令有什么作用?
关闭所有已打开的表:FLUSH TABLES命令会关闭所有已打开的表文件,释放相关的内存资源。如果表中有未写入磁盘的数据(如缓冲池中的脏页),会被强制写入磁盘
刷新表缓存:该命令会刷新表的元数据(如索引、统计信息),确保最新的元数据被加载到内存中
影响:FLUSH TABLES命令会等待所有正在运行的SQL请求结束,因此会阻塞其他会话对相关表的操作,包括查询和写操作
1.6.30 MySQL CR 恢复机制,是怎样恢复数据数据的 redo log 和 DoubleWrite buffer 是如何配合的?
在恢复过程中,当InnoDB准备应用redo log时,会先尝试读取数据页。如果发现数据页损坏(比如checksum校验失败),就会从
doublewrite buffer中读取该页的副本,替换掉损坏的页,然后再应用redo log中的变更到该页上。这样顺序就是先恢复Doublewrite 的页,再应用redo log
1.6.31 数据恢复方案?
mysqlbinlog
--include-gtids=事务编号 -- 可以截取需要恢复的事务范围信息
--exclude-gtids=name -- 连续截取多个范围事务信息时,可以排除中间的某个事务不进行截取
--skip-gtids -- 在截取后文件中,不记录gtid信息(主要用于将截取后文件进行恢复数据)
mysqlbinlog -d www --include-gtid=59617675-f589-11ef-9c2f-000c29141679:12-17 >/tmp/www.sql
binlog2sql
python3 binlog2sql.py -h 10.0.0.51 -P3307 -uroot -p123456 -d world -t city --sql-type=delete --start-file='binlog.000008'-- 先确认误操作语句,是否记录到binlog中;
-h 连接数据库服务端(服务端地址)
-h 连接数据库服务端(服务端地址)
-P 连接数据库服务端(服务端端口)
-u 登录数据库服务端(用户名)
-p 登录数据库服务端(密码)
--start-file='binlog.000008' 需要从哪个binlog中读取SQL信息
-d 指定过滤库信息
-t 指定过滤表信息
--sql-type 指定过滤的语句类型
延时从库
1.6.32 周日做的备份,昨天删除了drop了一张表,如何恢复,不知什么时间删除的?
1.6.33 数据损坏了怎么恢复(断电了,误删了)?
事务和锁
1.7.1 MySQL 是如何实现事务的?
MySQL 是通过ACID 四个特性完成的事务 即原子性,一致性,隔离性,持久性
1.7.2 什么是事务的 ACID?ACID 是如何保证的?
ACID 即 原子性,一致性,隔离性,持久性
原子性 (Atomicity)(一组操作要么全部成功,要么全部失败)
Undo Logs:记录事务开始前的数据状态,便于回滚
Redo Logs:记录事务的所有更改操作,确保在崩溃后可以重新应用这些更改
一致性 (Consistency) 事务结束后,数据库应处于一致的状态
约束检查:确保所有数据符合预设的约束条件。
事务提交:只有在所有操作都成功并通过一致性检查后才最终提交事务
隔离性(Isolation) 多个并发事务相互独立,互不影响
锁机制:使用行级锁或表级锁来控制并发访问。
多版本并发控制 (MVCC):允许多个事务同时读取不同版本的数据,减少冲突
持久性 (Durability) 一旦事务提交,结果将永久保存
Redo Logs:确保即使系统崩溃也能恢复到最近一次提交的状态。
双写缓冲 (Doublewrite Buffer):防止部分页面损坏
1.7.3 MySQL 中长事务可能会导致哪些问题?
长时间的锁定资源,阻塞资源:
长事务会持有锁(如行级锁或表级锁),阻止其他事务对该数据进行修改。这种锁的存在会影响数据库的并发性能,降低整体效率
增加存储空间消耗:
在 MySQL 中,为了实现事务的原子性和可恢复性,会对每次更新操作生成相应的回滚信息(undo log)。当事务保持打开状态较久时,这些回滚信息也会随之累积,占用大量磁盘空间
产生死锁风险:
多个长事务相互竞争相同的资源时,很容易形成循环依赖关系,进而触发死锁现象。此时,MySQL 可能会选择终止某些事务以解除 deadlock 条件,但这通常伴随着一定的业务中断和服务降质的风险
引起主从复制延迟:
在具有主从复制架构的 MySQL 系统中,主节点上的长事务会在其完成后才允许从节点同步对应的变更内容。因此,若频繁发生此类情形,则会导致从节点与主节点之间的数据差异增大,进一步恶化复制滞后状况
耗尽数据库连接池资源:
应用程序中的长事务如果不及时释放持有的数据库连接,将迅速占据可用连接数上限,阻碍新来的请求获得必要的数据库交互通道,最终迫使新的用户面临无响应或异常退出等问题
延长垃圾回收周期:
回滚段用于存放旧版数据副本,供事务回滚至先前状态所需。然而,只要有任何活动事务引用到特定范围内的 undo 记录,这部分内存区域便不能立即被重用或清除掉。这意味着随着活跃长事务数量的增长,可用于分配给新生事物的空间逐渐缩减,间接增加了 garbage collection 的负担
影响监控指标准确性:
相关统计参数如平均事务处理时间、最大等待锁的时间长度等均会被拉高,误导DBA误判实际负载水平,不利于合理规划硬件配置或是调整优化措施的方向
回滚导致时间浪费:
如果长事务执行很长一段时间,中间突发状况导致报错,导致事务回滚,之前做的执行都浪费
1.7.4 MySQL 中的 MVCC 是什么?
概述
MVCC(Multi-Version Concurrency Control,多版本并发控制)是一种用于提高数据库并发性能的技术。应于InnoDB 存储引擎。MVCC 允许在同一时间内多个事务可以读取和写入相同的数据行,而不会互相干扰,从增强了系统的并发处理能力
特性
非阻塞读操作
在传统的锁机制下,如果一个事务正在进行写操作,其他试图读取该数据的事务需要等待直到写操作完成并释放锁为止。而在 MVCC 下,读操作不需要获取任何类型的锁,可以直接访问最近提交的数据快照,极大地减少了等待时间和提高了吞吐量
支持多种隔离级别
支持 RC 和 RR 两种隔离级别
实现原理
Undo 日志 (Undo Logs):
用途: 当对某个数据行进行插入、更新或删除操作时,InnoDB 会将这些操作之前的旧版本数据记录到 Undo 日志中
作用:
回滚事务: 如果事务没有正常提交,可以通过 Undo 日志恢复到修改前的状态
提供历史版本: 在读取数据时,可以根据需要访问不同版本的数据
隐藏列:
DB_ROW_ID: 自动递增的唯一标识符,用于区分每一行的不同版本
DB_ROLL_PTR: 指向对应行的上一个版本所在的 Undo 日志的位置
DB_TRX_ID: 记录最后一次修改该行的事务 ID
DB_HEAP_NO: 表示行在一个页中的相对位置
Read View:
定义: 当一个事务开始时,它会创建一个 Read View,表示在这个时刻可见的所有事务状态。
组成:
min_trx_id: 最低活跃事务 ID,小于此 ID 的所有事务都已经结束
max_trx_id: 上界数组,下一个,也是最大值,系统应该分配的一个事务的ID值,之前提交的事务最大值+1
creator_trx_id_: 创建该 Read View 的事务 ID
mids: 事务正在进行,未提交的,活跃的事务
写操作
插入操作:
插入新行时,仅设置 DB_TRX_ID 字段为当前事务 ID,并初始化其他必要字段
不涉及 Undo 日志,因为插入的新行没有任何旧版本可供撤销
更新操作:
更新现有行时,首先将原行数据写入 Undo 日志,以便之后可以回滚
然后更新行数据,并设置 DB_TRX_ID 字段为当前事务 ID
使用 DB_ROLL_PTR 指针指向刚刚写入 Undo 日志的旧版本数据
删除操作:
删除行时,同样将原行数据写入 Undo 日志
标记该行为已删除(软删除),并将 DB_TRX_ID 设为当前事务 ID
DB_ROLL_PTR 指向刚写的 Undo 日志中的完整数据副本
读操作
快照读 (Snapshot Reads):
快照读是指按照某一时间点的视图来读取数据,适用于大多数常见的 SELECT 查询
当事务启动时,会生成一个 Read View,描述了此刻可见的所有事务状态
读取数据时,根据 Read View 规则判断是否能看到某一行:
若行的 DB_TRX_ID < m_low_trx_id,则说明该行已被提交并且对当前事务可见
若行的 DB_TRX_ID == creator_trx_id_,则是由自己创建的行,自然可见
若行的 DB_TRX_ID 出现在 m_upp_trx_ids 数组中,则表示该行是由还在运行的更高优先级事务修改的,不可见
否则,查看 DB_ROLL_PTR 指向的 Undo 日志,寻找合适的旧版本数据返回给调用方
当前读 (Current Reads):
当前读是指实时获取最新版本的数据,主要用于满足一些特殊的需求,例如 UNIQUE 键校验、外键约束验证等
当前读总是看到最新的数据,不受 Read View 影响
执行当前读时,会加上必要的锁(如 S 锁或 X 锁),以确保数据的一致性和完整性
1.7.5 如果 MySQL 中没有 MVCC,会有什么影响?
锁竞争加剧: 这种严格的锁定会导致大量的锁竞争和冲突,尤其是在高并发环境下,严重影响系统的响应速度和吞吐量
读操作阻塞: 没有 MVCC 时,读操作会被写操作阻塞,反之亦然。这种相互排斥的关系使得并发能力大打折扣
降低整体性能: 由于频繁的锁争夺和等待时间延长,整个数据库的性能会明显下滑
死锁发生概率上升: 在缺乏 MVCC 的情况下,更多的锁请求和持有的锁数量增多,容易形成循环等待的情况,进而引发死锁
难以调试和预防: 死锁的发生通常比较随机且不易预测,增加了故障排查难度
丢失更新: 如果多个事务同时读取相同的初始值然后各自做出修改,最终只有一个事务的改动会被保存下来,其余的都被覆盖掉
脏读、不可重复读等问题频出: 在较低的隔离级别下,可能出现脏读(读取到了未提交的数据)、不可重复读(多次读取得到不同的结果)等情况
大量元数据开销: 为了维护精确的锁状态,需要在内存中存储大量的锁相关信息,占用更多资源
更频繁的磁盘访问: 锁的信息也需要持久化到磁盘日志中,增加了 I/O 操作次数,进一步拖累性能
长时间等待: 用户发起的操作经常因锁竞争而陷入漫长的等待阶段,用户体验急剧下降
1.7.6 MySQL 中的事务隔离级别有哪些?
RU (READ UNCOMMITTED) 读未提交
最低级别,在改级别下,一个事务可以看到另一个事务尚未提交的数据修改,可能会造成脏读问题
RC (READ COMMITTED) 读已提交
只能看到已经提交的其他事务所做的修改,这可以避免脏读问题,但是可能会引发不可重复读的问题, 但是可能会引发不可重复读问题
RR (REPEATABLE READ) 可重复读 (默认 )
在这个级别下,确保一个事务的多个查询返回的结果是一致的,这可以避免不可重复读的问题但是,有可能会引发幻读问题
SR (SERIALIZABLE) 串行化
并发执行SQL 事务操作,其效果与这些SQL事务,按某种顺序串行执行的效果相同
是最高的隔离级别,保证事务间的操作结果相当于一个按属性执行的单线程操作
这个隔离模式可以避免所有的并发问题,但会大大降低并发性能
补充说明
MySQL 的SR 类似 RR,但是如果关闭了自动提交事务功能,那么SR 级别的普通 SELEC 会被隐式转化成 SELECT FOR SHARE 即 对读夹共享锁,确保其他事务无法修改正在读取的数据。实现了读的一致性,这个操作就避免了RR 隔离级别下由于快照读和混读造成的幻读问题
1.7.7 MySQL 默认的事务隔离级别是什么?为什么选择这个级别?
RR (REPEATABLE READ) (可重复读)
原因
原因是为了兼容早期 binlog 的 statement 格式问题,如果是使用读已提交、读未提交等隔离级别,
使用了 statement 格式的 binlog 会导致主从(备)数据库数据不一致问题
【问题分析】
进一步分析 binlog statement 格式和可重复级别的影响;
在早期,MySQL binlog 仅支持 statement 格式,这个格式其实存的就是原先的SQL 语句;
这就使得在读末提交(RU)和读提交(RC)两种隔离级别下会出问题。
来实际看个例子:例如有两个事务 A和 B,以下图的时间顺序执行:
事务A 事务B begin; begin; delete from A where a<10 insert into A values (5); commit; commit; 在读已提交隔离级别且手动提交事务的情况下,插入的5这条记录会被保留,但是由于事务B先提交,所以它会先被记录在 binlog 中;
这个操作就导致了问题。
binlog 的记录顺序是:
xxxxxxxxxxinsert into A values (5);delete from A where a<10;使得从库同步 binlog 重放的时候,先执行了 insert 再执行 delete,这就使得从库的数据与主库不一致了,5 这条记录也会被删除了,
所以,为了避免这个问题,只能默认为可重复读级别
因为这个隔离级别下有间隙锁(Gap Locks)、临键锁(Next-Key Locks),所以事务B是无法先提交的,会被事务 A 阻塞;
因此 binlog 的记录只能是先delete再insert ,这样就没问题了
1.7.8 数据库的脏读、不可重复读和幻读分别是什么?
脏读情况: 并行多个会话事务读取数据时,可以读取未提交的修改记录(读取脏页信息)
不可重复读:当利用数据表进行数据统计时,每次统计的数据信息不一致
幻读情况: 当进行范围数据修改时,其他会话同时插入了范围以内数据信息,导致范围修改结果和修改语句不一致(影响范围数据修改调整删除信息)
1.7.9 什么是死锁?
死锁是指两个或两个以上的进程或线程在执行过程中,因为竞争资源或者由于彼此通信而造成的一种互相等待的现象,导致这些进程或线程都无法继续前进,从而进入无限等待的状态。在这种状态下,如果没有外力干预,系统将一直停留在这个状态,无法正常运作
比如我说你给我offer 就我来,你说你先来,我再给你offer
1.7.10 什么是快照读,什么是当前读?
快照读
快照读是一种不加锁的读操作,它读取的是记录的快照版本。这种方式适用于大多数普通的查询操作,在REPEATABLE READ隔离级别下尤为常见
不加锁:不会对读取的数据行施加任何形式的锁,因此不会阻止其他事务对同一数据行进行修改。
基于MVCC:依赖于多版本并发控制(Multi-Version Concurrency Control, MVCC)技术,能够提供一致性的视图。
适合场景:主要用于读取数据而不需要修改的情况,特别是在需要保证一致性但又不想影响其他事务的前提下
当前读
当前读是一种加锁的读操作,它读取的是记录的最新版本,并且会对读取的记录加锁,以防止其他事务同时修改相同的数据行
加锁:可以附加共享锁(Shared Lock)或排他锁(Exclusive Lock),确保数据的一致性和完整性。
实时性:总是读取最新的数据,不受其他事务的影响。
适合场景:主要用于需要精确控制数据访问权限和避免并发修改的情况,常用于事务中的锁定读操
对比
| 快照读 (Snapshot Read) | 当前读 (Current Read) | |
|---|---|---|
| 是否加锁 | 否 | 是 |
| 读取版本 | 记录的快照版本 | 记录的最新版本 |
| 适用隔离级别 | REPEATABLE READ | 所有隔离级别 |
| 典型命令 | SELECT ... | SELECT ... FOR UPDATE, SELECT ... LOCK IN SHARE MODE, UPDATE, DELETE, INSERT |
| 优点 | 高并发性能 | 数据强一致性 |
| 缺点 | 可能看不到最新的更改 | 导致一定的并发瓶颈 |
| 应用场合 | 仅读取数据,无需修改 | 需要精确控制数据访问权限 |
1.7.11 read-view 是如何判断当前事务的看见性的?
DB_TRX_ID < up_limit_id:
行记录的事务ID小于up_limit_id,表明该记录已经在当前事务启动之前提交,因此对当前事务可见。
DB_TRX_ID ≥ low_limit_id:
行记录的事务ID大于或等于low_limit_id,表明该记录是在当前事务启动之后生成的未来版本,因此对当前事务不可见。
up_limit_id ≤ DB_TRX_ID < low_limit_id 并且 DB_TRX_ID ∈ trx_ids:
行记录的事务ID在这个范围内并且存在于活跃事务列表中,表明该记录是由另一个尚未提交的事务生成的,因此对当前事务不可见。
up_limit_id ≤ DB_TRX_ID < low_limit_id 并且 DB_TRX_ID ∉ trx_ids:
行记录的事务ID在这个范围内但不存在于活跃事务列表中,表明该记录已经是过去某个已完成事务生成的旧版本,因此对当前事务可见。
1.7.12 幻读是怎样产生的,会造成什么问题?
幻读的产生原因
并发操作:当两个或多个事务在几乎相同的时间内执行时,如果一个事务插入了新的数据行,而另一个事务在同一时间范围内执行相同的查询,但期望结果保持不变,就会发生幻读
事务隔离级别:在“可重复读”隔离级别下,事务可以多次读取同一范围的数据而不会看到其他事务的更新(除了插入的新行),这导致了幻读现象。而在“读已提交(Read Committed)”隔离级别,每次查询都会看到其他事务已经提交的最新数据,因此不会遇到传统意义上的幻读问题,但可能会遇到其他类型的并发问题
幻读产生的问题
查询结果不一致:在一个事务内部,如果两次执行相同的查询,第一次查询没有看到某些行,但在第二次查询时,由于其他事务的插入操作,这些新行突然出现在结果集中,就像“幻影”一样出现
1.7.13 InnoDB是怎样在可重复读隔离级别下解决幻读的?
使用MVCC 快照读方式 ,一定程度上解决了幻读
1.7.14 简述 MySQL 中锁的种类及作用?
行级锁(Row Lock)
仅对特定的行加锁,允许其他事务并发访问不同的行,适用于高并发场景
表级锁(Table Lock)
对整个表加锁,其他事务无法对该表进行任何读写操作,适用于需要保证完整的小型表
意向锁(Intention Lock)
一种特殊的表锁,用于表示某个事物对某行数据加锁的意图,分为意向共享锁(IS)和意向排它锁(IX);
主要用于行级锁与表级锁的结合
共享锁(shard Lock)
允许多个事务并发读取同一资源,但不允许修改。只有在释放共享锁后,其他事务才能获得排它锁
排它锁(exclusive Lock)
只允许一个事务对资源进行读写,其它事务在获得排它锁之前无法访问该资源
元数据锁(metadata Lock,MDL)
用于保护数据库对象(如表和索引)的元数据,防止在进行DDL操作时,其他事务对这些对象进行修改
间隙锁(Gap Lock)
针对索引中两个记录之间的间隙加锁,防止其他事务在这个间隙中插入新记录,从而避免幻读;
间隙锁不锁定具体行,而是锁定行与行之间的空间
临键锁(Next-Key Lock)
一种等待间隙的锁,用于指示事务打算在某个间隙中插入记录,允许其他事务进行共享锁,但在插入时会阻止其他的排它锁
插入意向锁(Insert Intention Lock)
一种等待间隙的锁,用于指示事务打算在某个间隙中插入记录,允许其他事务进行共享锁,但在插入时会阻止其他的排它锁
自增锁(Auto Increment Lock)
在插入自增列时,加锁以保证自增值的唯一性,防止并发插入导致的冲突。
通常在插入操作时被使用,以确保生成的自增ID是唯一的
1.7.15 MySQL 的乐观锁和悲观锁是什么?
悲观锁(Pessimistic Locking):
假设会发生冲突,因此在操作数据之前就对数据加锁,确保其他事务无法访问该数据;
常见于对数据一致性要求较高的场景。
实现方式是使用行级锁或表级锁;
例如:可以使用select ... for update 或 lock in share mode语句加锁
乐观锁(Optimistic Locking):
假设不会发生冲突,因此在操作数据时不加锁,而是在更新数据时进行版本控制或检验,如果发现数据被其他事务修改;
则会拒绝当前事务的修改,需重新尝试;
实现方式是通过版本号或时间戳来实现,每次更新时检查版本号或时间戳是否一致
悲观锁和乐观锁适用场景:
乐观锁适合并发冲突少,读多写少的场景,不用通过加锁只需通过比较字段版本号(或时间戳)是否发生改变的形式,无锁操作,吞吐量较高;
悲观锁适合并发冲突多,写多读少的场景。通过每次加锁的形式来确保数据的安全性,吞吐量较低;
1.7.16 MySQL 中如果发生死锁应该如何解决,如何检测死锁?
自动检测与回滚:
MySQL自带死锁检测机制(innodb deadlock detect),当检测到死锁时,数据库会自动回滚其中一个事务,以解除死锁。
通常会回滚事务中持有最少资源的那个
也有锁等待超时的参数(innodb lock wait timeout),当获取锁的等待时间超过阈值时,就释放锁进行回滚。
手动 kill 发生死锁的语句:
可以通过命令,手动快速地找出被阻塞的事务及其线程 ID,然后手动 kill 它,及时释放资源
手动Kill 死锁流程
查看事务id(trx_id)
SELECT * FROM INFORMATION_SCHEMA.INNODB_LOCKS;
查看线程id (trx_mysql_thread_id)
SELECT trx_state, trx_started, trx_mysql_thread_id, trx_query, trx_id FROM INFORMATION_SCHEMA.INNODB_TRX
WHERE trx_id = '123456';
trx_mysql_thread_id 与该事务关联的 MySQL 线程 ID,可以用来查找该事务的更多信息
kill导致死锁的进程
kill + 线程id
死锁情况避免方法:
避免大事务
大事务占据锁的时间长,将大事务拆分成多个小事务快速释放锁,可降低死锁产生的概率和避免冲突。
调整申请锁的顺序。
在更新数据的时候要保证获得足够的锁;
举个例子:先获取影响范围大的锁,比如说修改操作,先将排他锁获取到,再获取共享锁。或固定顺序访问数据,这样也能避免死锁的情况。
更改数据库隔离级别。
可重复读比读已提交多了间隙锁和临键锁,利用读已提交替换之可降低死锁的情况。
合理建立索引,减少加锁范围。
如果命中索引,则会锁对应的行,不然就是全表行都加锁,这样冲突大,死锁的概率就高了
开启死锁检测
适当调整锁等待时长
1.7.17 lock in share mode、for update、update、insert、delete分别上什么锁?
1.7.18 MySQL的加锁原则能介绍一下嘛
1.7.19 next-key lock加锁的过程是怎样的?
1.7.20 MySQL 插入一条 SQL 语句,redo log 记录的是什么?
因为 redo log是物理日志,记录“某页(Page)某位置的数据被修改为某值”对页的变更,它不记录逻辑操作(如“插入一行”)而是直接记录对页的变更,所以在插入操作中,redolog记录的是事务在数据页上的修改数据页的插入点、记录的偏移量和插入的实际数据并更新页目录、页头等元数据
1.7.21 MySQL 事务的二阶段提交是什么?
对于MySQL Innodb存储引擎而言,每次修改后,不仅需要记录Redo log还需要记录Binlog,而且这两个操作必须保证同时成功或者同时失败,否则就会造成数据不一致。为此MySQL引入两阶段提交
二阶段提交是MySQL 为了保证redo log 和 BinLog 写入数据一致性的一个机制
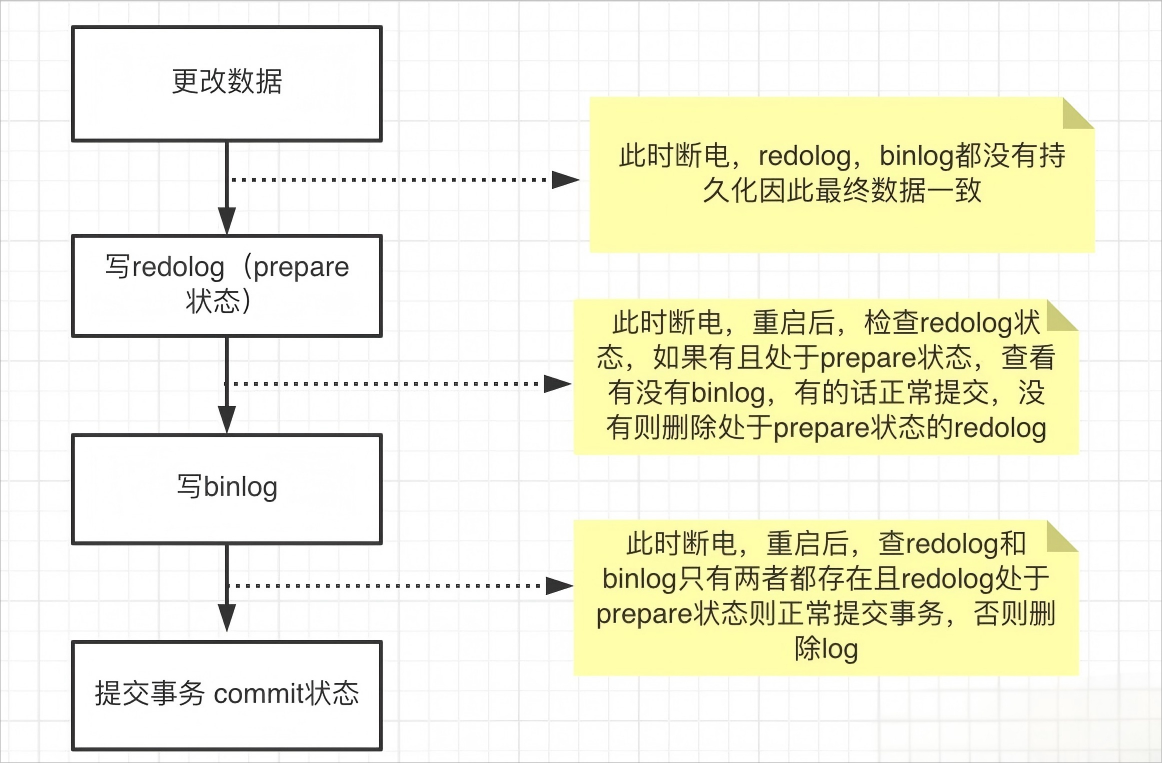
1.7.22 redo log 重做日志作用 ?
重做日志(redo log)是InnoDB 引擎内部的事务日志,用于记录数据页的物理修改。
redo log是固定大小的环形日志,主要用于崩溃恢复。它可以帮助 InnoD8 在崩溃后通过日志重做未写入数据页的数据修改;
从而确保数据的持久性
1.7.23 undo log 回滚日志作用 ?
事务回滚:当事务需要回滚时,Undo log 用于撤销已执行的操作,将数据恢复到事务开始前的状态
多版本并发控制(MVCC):Undo log 支持 MVCC,允许读取操作在不加锁的情况下访问数据的历史版本,从而提高并发性能
数据一致性:在系统崩溃或事务失败时,Undo log 帮助恢复数据到一致状态,确保数据库的完整性
事务隔离:Undo log 提供事务隔离,确保一个事务的未提交修改不会影响其他事务
日志管理:Undo log 记录事务的修改操作,便于系统管理和维护事务日志
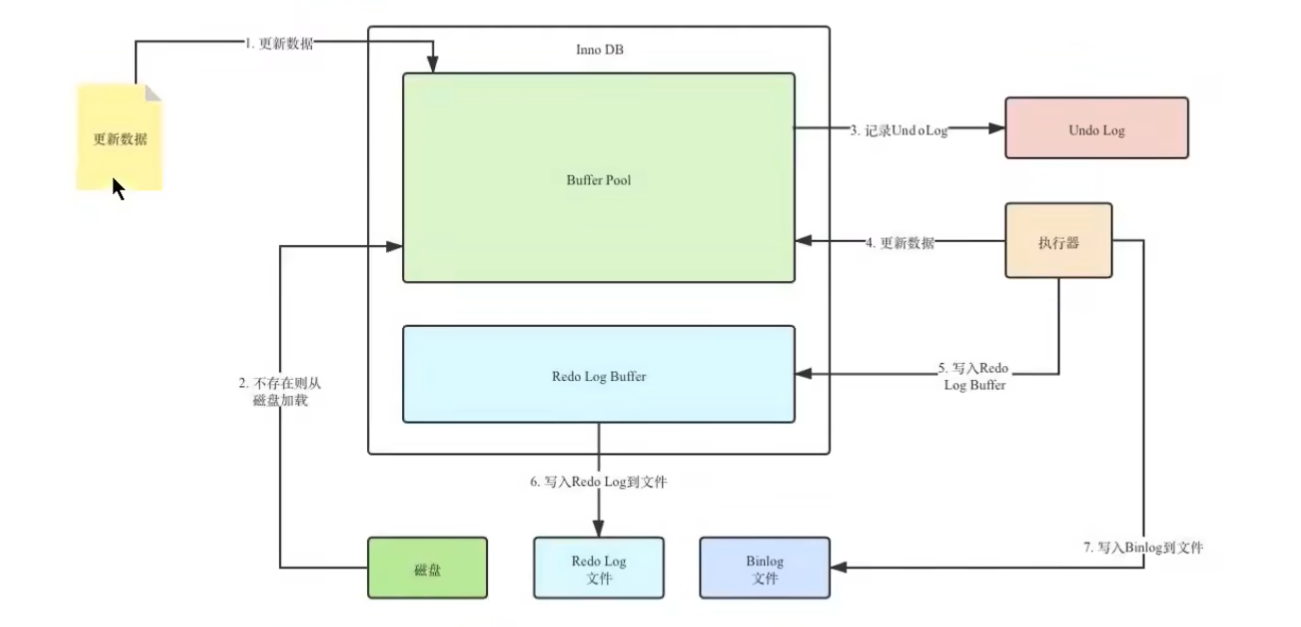
1.7.24 RC 和 RR 在构建 mvcc 的 read view 时有什么区别?
RC 是当前读
RR 是快照读
1.7.25 Innodb 支持事务的原因?
InnoDB实现事务的核心原理主要基于其MVCC和redo日志机制
通过MVCC,InnoDB可以为每个事务提供一个数据快照,使得在一个事务中的查询操作只能看到本事务开始时的数据,这样就能保证事务的隔离性。而redo日志则是为了确保事务的持久性,事务提交时,InnoDB会先将改变写入redo日志,并确保这些日志被持久化到磁盘上,这样即使在事务提交后系统崩溃,也能通过redo日志恢复数据
1.7.26 MVCC 中是如何判断其他事务是否可见?
快照读的机制
DB_TRX_ID < up_limit_id:
行记录的事务ID小于up_limit_id,表明该记录已经在当前事务启动之前提交,因此对当前事务可见。
DB_TRX_ID ≥ low_limit_id:
行记录的事务ID大于或等于low_limit_id,表明该记录是在当前事务启动之后生成的未来版本,因此对当前事务不可见。
up_limit_id ≤ DB_TRX_ID < low_limit_id 并且 DB_TRX_ID ∈ trx_ids:
行记录的事务ID在这个范围内并且存在于活跃事务列表中,表明该记录是由另一个尚未提交的事务生成的,因此对当前事务不可见。
up_limit_id ≤ DB_TRX_ID < low_limit_id 并且 DB_TRX_ID ∉ trx_ids:
行记录的事务ID在这个范围内但不存在于活跃事务列表中,表明该记录已经是过去某个已完成事务生成的旧版本,因此对当前事务可见。
1.7.27 事务的持久性是如何实现的?主要参数是什么?
持久性主要通过 Redo Logs (重做日志)来实现
主要的四个参数
innodb_flush_log_at_trx_commit
sync_binlog
sql_log_bin
innodb_file_per_table
详细说明
innodb_flush_log_at_trx_commit (影响持久性 影响redo信息记录redo日志) innodb_flush_log_at_trx_commit=1 -- 每次提交事务都会写入log buffer,并写入redo
innodb_flush_log_at_trx_commit=0 -- 每次log buffer 和 redo信息的写入,会间隔1s钟; innodb_flush_log_at_trx_commit=2 -- 每次提交事务先写入log buffer,每间隔1s,将log buffer信息写入到redosync_binlog 影响binlog信息记录到binlog文件
sync_binlog=0 -- 禁止写入binlog信息 sync_binlog=1 -- log buffer 有新的binlog信息,会马上同步到binlog文件 sync_binlog=N -- log buffer 有新的binlog信息, 积攒到N个事务之后,才会同步到binlog文件
sql_log_bin 是否有些事务操作,进行binlog记录 (恢复数据信息 / 不需要同步从库数据信息) sql_log_bin=1 -- 会做事务操作记录到binlog sql_log_bin=0 -- 不会做事务操作记录到binlog
innodb_file_per_table 影响表数据保存位置 innodb_file_per_table=1 -- 表示表数据信息会单独保存到对应独立表空间文件中 t1.ibd innodb_file_per_table=0 -- 表示表数据信息会汇总保存到共享表空间文件 ibdate1
1.7.28 为什么需要两阶段提交,那么如果没有两阶段提交,会发生什么呢?
如果没有二阶段提交,关于这两个日志:要么就是先写完 redo log,再写 binlog 或者先写 binlog 再写 redo log
来分析一下会产生什么后果
先写完redolog,再写binlog
写完redo log后,MySQL异常宕机,binog 还未写入数据。
重启后redolog记录了,因此可以从 redo log 恢复事务的修改,但是binlog 并没有本次事务提交的数据。
后续通过 binlog 恢复的时候,本次事务的修改就丢了
先写完binlog,再写redolog
写完 binlog 后,MySQL异常宕机,redolog 还未写入数据。
重启后因为redo log中没有记录,所以无法恢复本次事务的修改,但是binlog记录了本次事务提交的数据。
后续通过 binlog 恢复的时候,本次事务的修改可以复原,但是这和原库的数据又不一致了
如有有二阶段提交,MySQL 异常宕机恢复后如何保证数据一致呢?
redo log 处于 prepare 阶段,binlog 还未写入,此时 MySQL 异常宕机
这个阶段很好理解,由于 redo log 还末 commit ,所以异常恢复后,redolog 中记录的数据也不作数,binlog 内也没有记录数据;此时数据是一致的
redo log 处于 prepare 阶段,binlog 已写入,但 redo log 还未 commit,此时 MySQL 异常宕机
此时仅需对比 redo log 中 prepare 的数据和 binlog 中的数据是都一致即可
如果一致,则提交事务。不一致,则回滚事务
1.7.29 MySQL 如何监控长事务,避免长事务?
识别长事务
监控表 Information_schema.innodb_trx表
xxxxxxxxxxSELECT *FROM information_schema.innodb_trxWHERE TIME_TO_SEC(TIMEDIFF(NOW(), trx_started)) > 60; -- 查找持续超过60秒的事务使用 Percona Monitoring and Management (PMM) (可以提供详细的事务统计信息,帮助快速定位长事务)
使用 Prometheus & Grafana: 结合 Prometheus 和 Grafana 构建自定义仪表盘,监控事务时间和活跃事务数量
启用 General Query Log 记录所有 SQL 请求,通过分析日志找出执行时间较长的查询
SET GLOBAL general_log = 'ON';-- 开启一般查询日志
配置
Slow Query Log收集执行时间超出指定阈值的查询xxxxxxxxxxslow_query_log_file=/var/log/mysql/slow-query.loglong_query_time=2log_queries_not_using_indexes=true编写自动化脚本来定期扫描 information_schema.innodb_trx 表,并发送警报通知管理员
避免长事务
最小化事务范围:确保每个事务只包含必要的操作,不要将无关紧要的任务纳入同一个事务中
批量操作分解:对于大规模的数据导入导出或批处理任务,将其分割成较小的批次逐一提交 如果没有索引可以利用主键作为索引进行联合查询条件进行分批删除操作
调整隔离级别:根据业务需求选择合适的隔离级别。较低的隔离级别(如 READ COMMITTED)可以提高并发性能,但需要注意数据一致性问题
限制单个语句的最大执行时间:使用 max_execution_time 参数来控制每个 SQL 语句的最长执行时间
异步处理:将耗时的操作(如 RPC 调用、外部 API 请求)移出事务外,单独处理
消息队列:使用消息队列(如 Kafka、RabbitMQ)来调度后台任务,减轻事务负担
索引优化:确保常用字段上有适当的索引,加快查询速度
查询重构:简化复杂的查询逻辑,减少不必要的子查询和联接操作
缓存机制:利用缓存(如 Redis、Memcached)减少频繁的数据库访问
代码审核:定期审查现有代码,寻找潜在的长事务来源
性能基准测试:进行负载测试和性能基线评估,及时发现并解决问题
使用分布式事务管理器 XA 事务 和 Saga 模式
动态设置变量:根据具体情况动态调整 MySQL 的配置参数,如 innodb_rollback_segments 和 innodb_max_purge_lag_delay
SET GLOBAL innodb_rollback_segments = 128;
1.7.30 如何解决幻读?
提高隔离级别:将事务隔离级别设置为“串行化(Serializable)”,虽然可以完全避免幻读,但会显著降低并发性能
使用锁:在查询时使用锁定机制,如SELECT ... FOR UPDATE或SELECT ... LOCK IN SHARE MODE,来防止其他事务在当前事务处理期间插入新记录
MVCC优化:在支持多版本并发控制的数据库中(如MySQL的InnoDB),通过Next-Key Locks等机制来减少幻读的发生,尽管这增加了锁的复杂性
应用层面的解决方案:设计应用逻辑时,考虑使用乐观锁或悲观锁策略,或者通过业务规则避免对最新数据的依赖
1.7.31 MVCC 解决幻读了吗?
多版本并发控制(MVCC)在很大程度上缓解了幻读问题,尤其是在“可重复读(Repeatable Read)”隔离级别下,但它并不能完全解决所有类型的幻读
MVCC 解决了大部分幻读问题:
在“可重复读”隔离级别下,通过生成稳定的Read View,确保事务在其生命周期内看到的数据始终保持一致
大多数普通查询(快照读)都不会受到新插入数据的影响
MVCC 未完全解决问题:
当前读:带有锁的查询(如FOR UPDATE)会立即反映出最新的数据变化,可能导致幻读
Range Queries with Gaps:在某些复杂的范围查询中,如果不启用合适的锁机制(如间隙锁),也可能出现幻读
1.7.32 MySQL为什么会需要redo日志,redo日志的特点和好处?
1.7.33 如何理解undo日志?
1.7.34 MVCC机制、事务隔离级别、undo、redo之间的相互作用?
1.7.35 从数据操作角度锁分为哪几种?从数据粒度来划分,锁分为哪几种?
1.7.36 死锁你是怎么监控?其他还有遇到过锁的?元数据锁?
1.7.37 事务没有提交?事务的堵塞情况?事务运⾏多久?
1.7.38 redo log占⽤磁盘太多是什么导致的?(⽐如说500G的实例,这个⽇志就占200G)
长时间未提交的大事务
如果有持续很长时间的长事务,其对应的 Redo 日志会一直存在于 Buffer 中直到事务提交
拆分大事务:尽量将大事务分解为较小的任务,缩短每个事务的持有时间
监控和告警:使用监控工具检测长时间运行的事务,并及时干预
频繁的小事务
大量的小事务会产生许多 Redo 日志条目,累积起来占用较多空间
批处理操作:尽可能地将多个小操作合并为一个较大的批次
优化 SQL 查询:确保查询高效,减少不必要的重复操作
高并发写操作
水平扩展:增加服务器资源或使用集群架构来分担压力
异步处理:利用消息队列或其他技术延后处理非即时性操作
配置不当
调整日志文件大小:适当增大 innodb_log_file_size 以容纳更多日志,减少切换频率
增加日志文件数量:通过增加 innodb_log_files_in_group 数量来分散 I/O 负荷
数据增长速度快
如果数据库中的数据增长速度很快,相应的 Redo 日志也会随之增多
使用分区表管理大数据集,提高维护效率
相关线程出现问题
Checkpointing:确保 Checkpoint 正常运作,标记哪些日志可以被安全删除。
Purge Thread:确认 Purge 线程正在正确移除不再需要的日志。
异常终止或重启
描述:意外的系统崩溃或强制重启可能导致 Redo 日志未能及时清空
1.7.39 单机的redo log是做什么的?集群
1.7.40 什么时候redo log进⾏数据落盘?
innodb_flush_log_at_trx_commit参数决定了 Redo Log 如何及何时被刷新到磁盘。共有三种模式:
innodb_flush_log_at_trx_commit = 0:
每次事务提交时,仅将 Redo Log 写入 Page Cache。
后台线程每秒钟将 Page Cache 中的内容刷盘一次。
风险:如果发生宕机,最多丢失最后一秒的数据。
innodb_flush_log_at_trx_commit = 1(默认值):
每次事务提交时,立即将 Redo Log 写入 Page Cache 并调用 fsync() 函数将其刷盘。
优势:最高级别的数据安全保障,确保事务提交后数据永不丢失。
劣势:较高的 I/O 开销,可能会影响性能。
innodb_flush_log_at_trx_commit = 2:
每次事务提交时,仅将 Redo Log 写入 Page Cache
后台线程每秒钟将 Page Cache 中的内容刷盘一次
风险:如果发生宕机,最多丢失最后一次事务的数据
优势:较低的 I/O 开销,较好的性能表现
1.7.41 redo 和undo与双写⽂件之间的关系?
以下是 Redo Log、Undo Log 和 DoubleWrite Buffer 之间相互配合的过程:
事务开始:
用户启动一个新的事务
生成 Redo 日志:
InnoDB 为每个事务生成相应的 Redo 日志,并将其写入 Redo Log Buffer
生成 Undo 日志:
同时,InnoDB 也为每个事务生成 Undo 日志,并将其写入 Undo Segment
准备写入数据页:
修改的数据页准备好要写入磁盘
写入 DoubleWrite Buffer:
数据页首先被写入 DoubleWrite Buffer
这一步确保了即使出现部分写入失败,也有一个可靠的副本可供恢复
写入目标数据文件:
数据页随后被写入最终的目标数据文件
Flush Redo Log:
根据 innodb_flush_log_at_trx_commit 参数的不同,Redo 日志会被刷新到磁盘
Mode 0: 写入 Page Cache。
Mode 1: 写入 Page Cache 并调用 fsync() 刷新到磁盘
Mode 2: 写入 Page Cache。
Commit 事务:
一旦 Redo 日志被成功刷新到磁盘,事务被视为已提交
Purge Undo 日志:
已经应用的 Undo 日志可以被 Purge 线程清除,释放空间
1.7.42 mysql读视图概念
readview 快照读
1.7.43 间隙锁和意向锁?
1.7.44 redo log和binlog⽂件写⼊顺序
事务的两阶段
先写入 redo log 再写入 binlog
1.7.45 mysql DDL操作哪些方式不会锁表?
COPY ,是指DDL时,会生成(临时)新表,将原表数据逐行拷贝到新表中,在此期间会阻塞DML;如果使用了主键自增,插入DML语句没有阻塞
INPLACE,无需拷贝全表数据到新表,但可能还是需要IN-PLACE方式(原地,无需生成新的临时表)重建整表。这种情况下,在DDL的初始准备和最后结束两个阶段时通常需要加排他MDL锁(metadata lock,元数据锁),除此外,DDL期间不会阻塞DML;
INSTANT,只需修改数据字典中的元数据,无需拷贝数据也无需重建整表,同样,也无需加排他MDL锁,原表数据也不受影响。整个DDL过程几乎是瞬间完成的,也不会阻塞DML,这个新特性是8.0.12引入的,快速加列采用的是 instant 算法,使得添加列时不再需要 rebuild 整个表,只需要在表的metadata 中记录新增列的基本信息即可。
alter table t1 rename to t2, algorithm = instant;instant功能存在的限制:仅支持在一个语句中添加列,即如果同一语句中存在其他非INSTANT操作,则无法立即执行.比如:alter table sc drop column c1,drop column c3
1.7.46 直接先写完 redo log,再写 binlog,崩溃恢复后直接判断两个日志数据是否完整不就好了? 为什么还要分二阶段?
理论上是可以的,但是从意义上来说有冲突。
因为 redo log 提交了,意味着事务已经提交,此时是无法回滚的。如果 binlog 没写入,此时数据就不一致了。
此时还有一种方案就是崩溃恢复时再补 binlog,补数据还是比较麻烦,还不如直接用两阶段了;
两阶段提交其实是一个经典的分布式解决方案,在协商场景下,每个人都被询问说 ok了才提交,就是为了避免后续的回滚或者补数据的情况
1.7.47 如何对比 redo log 和 binlog 是一致的?
两个日志都有一个字段:XID
因此崩溃恢复的时候,扫描 redolog,如果发现有 prepare 的 redo log 则利用它的 XID 去 binog 查询;
如果找到对应的数据,则说明数据都保存了,事务可以提交,反之事务回滚
1.7.48 MySQL 插入一条 SQL 语句,redo log 记录的是什么?
因为 redo log是物理日志,记录“某页(Page)某位置的数据被修改为某值”对页的变更,它不记录逻辑操作(如“插入一行”),而是直接记录对页的变更,所以在插入操作中。redolog记录的是事务在数据页上的修改数据页的插入点、记录的偏移量和插入的实际数据并更新页目录、页头等元数据
1.7.49 插入操作 redo log 具体执行流程?
修改缓冲页(Buffer Pool):数据先写入内存中的缓冲池,而不是直接写入磁盘
生成 redo log:同时生成一条 redo log,记录插入对数据页的物理修改细节
日志先行(Write-Ahead Logging, WAL):redo log 先被写入磁盘上的 redo log 文件
1.7.50 死锁情况避免方法?
避免大事务
大事务占据锁的时间长,将大事务拆分成多个小事务快速释放锁,可降低死锁产生的概率和避免冲突
调整申请锁的顺序
在更新数据的时候要保证获得足够的锁;
举个例子:先获取影响范围大的锁,比如说修改操作,先将排他锁获取到,再获取共享锁。或固定顺序访问数据,这样也能避免死锁的情况
更改数据库隔离级别
可重复读比读已提交多了间隙锁和临键锁,利用读已提交替换之可降低死锁的情况
合理建立索引,减少加锁范围
如果命中索引,则会锁对应的行,不然就是全表行都加锁,这样冲突大,死锁的概率就高了
开启死锁检测
适当调整锁等待时长
1.7.51 插入操作 redo log 具体执行流程
修改缓冲页(Buffer Pool):数据先写入内存中的缓冲池,而不是直接写入磁盘
生成 redo log:同时生成一条 redo log,记录插入对数据页的物理修改细节
日志先行(Write-Ahead Logging, WAL):redo log 先被写入磁盘上的 redo log 文件
1.7.52 什么是事务?
数据库事务(Transaction)是指作为单个逻辑工作单元执行的一系列操作,用于确保数据操作的正确性和完整性,这些操作要么全部执行,要么全部不执行
1.7.53 MySQL 死锁可以通过哪些视图检测到,如何手动Kill 死锁线程?
INNODB_TRX 视图
查看当前所有未提交事务的详细信息,包括事务 ID、锁状态、等待的锁资源等
INNODB_LOCK_WAITS 视图
直接显示事务之间的锁等待关系
sys.innodb_lock_waits (MySQL 8.0+)
SELECT * FROM sys.innodb_lock_waits
定位阻塞事务
xxxxxxxxxx-- 通过锁等待视图找到阻塞的线程 IDSELECT blocking_pid FROM sys.innodb_lock_waits;
-- 或从 INNODB_TRX 中获取SELECT trx_mysql_thread_id FROM information_schema.INNODB_TRX WHERE trx_state = 'LOCK WAIT'; kill ID
主从复制与架构
1.8.1 简述主从复制原理
在从库上进行主从配置,并会将配置信息保存到master info文件中
在从库上启动主从功能,会在从库中创建两个线程
IO线程: 负责和主库建立连接会话/负责将主机信息保存到从库
SQL线程:负责读取主库同步信息/将主库同步信息进行回放
IO线程出现后,会加载master info文件,向主库发送连接请求
主库确认并验证从库连接请求后,会在主库中创建mysql dump线程
dump线程:负责将主库binlog信息传输给从库IO线程/负责读取或监控主库binlog文件内容
IO线程接收dump线程传输数据后,会保存数据信息到relay log文件,并更新master info文件位置点
SQL线程会读取relay log数据内容,将数据内容进行回放,回放后会将回放的数据内容位置点记录到 relay log info文件,主从同步建立过程完毕
1.8.2 如何为运行了 2 年的数据库,构建一个从库(主从构建步骤)?请说明步骤?是否需要停主库?
1.8.3 如何监控主从复制?请说明监控要点?
1.8.4 请简述你遇到过的主从复制故障?分析、规避、处理?
IO线程故障处理
connecting (正在连接)
网络通信有问题(设备问题,配置问题)
联系网工解决问题
连接信息不正确 (地址,端口,用户,密码)Errno:2003
先 select * from mysql.slave_master_info\G; 记录一下目前和主库同步的binlog文件名字和位置点
停止主从关系 stop slave
清理master_info 信息 reset slave all
change master to
start slave
系统中配置了防火墙安全服务功能
硬件找网工
软件检查 iptables firewall
超出最大连接限制
主库在并发量较大时,主从出现异常了 修改连接数据量 (max_connections = 151)
可能连接的数量超过限制了 修改连接数据量 (max_connections = 151)
NO
主库中需要binlog文件或对应位置点事件不存在 Errno 13114
flush logs 重新生成日志,重新构建主从关系
xxxxxxxxxxstop slave;reset slave all;CHANGE MASTER TOMASTER_HOST='10.0.0.51',MASTER_PORT=3307,MASTER_USER='repl',MASTER_PASSWORD='123456',MASTER_LOG_FILE='binlog.000010',MASTER_LOG_POS=157,MASTER_CONNECT_RETRY=10;start slave;update mysql.slave_master_info set Master_log_name='binlog.000010',Master_log_pos=157 where Number_of_lines=33;# 以上方式可能会产生数据不一致
从库中需要relaylog文件不存在(IO=no SQL=no Errno )13117
(db02-relay-bin.000002 )没有了从库重新创建主从关系
隐患 之前的relay log 中可能有数据还没回放 会造成数据不一致
主从之间的server_id 和 server_uuid 配置信息不能一致(冲突了)Errno 13117
可以查看在 slave_master_info 看到报错, 在 my.cnf 中编辑 server-uuid 信息
SQL线程异常
NO
问题原因
创建的对象已经存在,涉及的对象可能有,库,表,用户,索引
插入(insert)修改(update alter)删除 (delete drop)的操作对象有异常
由于数据库设置的约束信息,与执行的SQL语句产生冲突问题
不同版本进行数据同步时,可能出现配置冲突问题(5.6 可以识别时间0 字段,5.7 不能识别时间0 字段)
造成异常的原因
在进行主从配置时,指定的位置带你出现错误(change master to)
在进行主从配置前,从库被写入相应的数据信息了,与主库同步数据产生冲突(误连接从库进行操作了);
在从库工作繁忙状态时,从库宕机了,业务恢复后可能出现异步同步数据错乱(主库操作创建表操作没同步,同步了插入表操作);
在进行主从切换时(假设进行的是手工切换),没有正确操作锁定源主库和binlog日志信息; 导致切换前主库数据没有完全同步,切换后从库数据(原主库)比主库数据(原从库)信息更全;
在应用数据库双主结构时,没有正确使用(经常导致相互同步数据,主键或唯一键冲突 若企业创建必须使用双主架构,实现双写机制,可以使用全局序列机制,实现主键或唯一键的统一分配;
解决SQL线程回放数据失败问题
删除冲突数据
删除库 删除表 删除数据 删除索引 删除约束(索引-禁用索引)
忽略冲突错误
sql_slave_skip_counter=1; 忽略几个SQL线程回放事件信息 xiaoAA 跳过 xiaoBB 跳过
slave_skip_errors=1007 忽略指定错误码错误信息
避免以上SQL线程异常情况:(未雨绸缪)
super_read_only=ON 限制管理员对数据库服务进行写入操作
read_only=ON 限制普通用户对数据库服务进行写入操作
主从延时问题
外部因素导致的延时问题
网络通信不问他,有带宽阻塞等情况,造成带宽阻塞,造成主从数据传输同步延时
让网络人员需要进行配合,优化网络传输速度 (硬件 软件-Qos)
主从配置差异大,磁盘性能较低,内存和CPU资源都不够充足
尽量让主从配置相同
主从配置区别大,从库配置没有优化,导致并发处理能力低于主库
主库因素导致的延时问题
主要涉及Dump thread 工作效率缓慢,可能是由于主库并发压力比较大
调整内存资源利用率,减少磁盘和内存之间IO消耗
对应业务数据进行拆分,可以实现分库分表操作
进行数据库分布是存储,可以实现并发压力
主要设计主要涉及Dump thread 工作效率缓慢,可能是由于从库数量过多
不要使用太多的从库 (一般 一主三从(备用节点,测试节点,延时节点),最多一主五从)
主要涉及Dump thread 工作效率缓慢,主要由线程本身串行工作方式(利用组提交缓解此类问题-5.6,group -commit)
主库配置
binLog_group_commit_sync_delay # 表示延时多少微秒同步到磁盘
binLog_group_commit_sync_no_delay_count # 表示延时提交的最大事务
从库配置 (开启逻辑时钟功能,并设置SQL多线程回放)
slave_parallel_type=logical_clock # 设置回放方式为 logical_clock
slave_parallel_workers=8 # 设置SQL 回放线程数量
从库因素导致的延时问题
从库产生延时受SQL线程影响较大,由于线程本身串行工作方式导致的
利用不同数据库并行执行事务操作,但是一个库有多张表情况,产生大量并发事务操作,依旧是串型的(5.6开始 多S0L线程回放)
利用logical clock机制进行并发回放,由于组提交事务是没有冲突的,从库并行执行也不会产生冲突(5.7开始 多S0L线程回放)根据日志内容信息,获取logical clock机制的组提交标记信息: (事务级别并发)
其他原因导致的延时问题
由于数据库大事务产生的数据同步延时问题(跟新100W数据/尽量切割事务)
一小部分事务就提交(事务切割)
由于数据库锁冲突机制的数据库同步延时问题 资源被锁定,无法同步 隔离级别配置RR-锁冲突
可以调整RC降低延时,索引主从一致
由于数据库过度追求安全配置也会导致同步延时问题
从库关闭双一参数
1.8.5 传统的主从复制是异步还是同步?会不会出现主从不一致?出现有什么好的方法解决或预防?
1.8.6 延时从库的实现原理?主要可以解决什么问题?
设置参数 change master to master_delay=15; 开启延迟功能,主要影响SQL线程,限制SQL线程读取回放relaylog日志的时间
主要解决误删除数据恢复问题
1.8.7 半同步复制实现原理?作用(解决主从数据最终一致性问题)
1.8.8 请简述 MGR 的工作原理?Paxos 协议工作原理?
1.8.9 如何处理 MySQL 的主从同步延迟?
说明:主从之间必然会出现延迟情况,尽量减少主从延迟情况
外部因素导致的延时问题
网络通信不问他,有带宽阻塞等情况,造成带宽阻塞,造成主从数据传输同步延时
让网络人员需要进行配合,优化网络传输速度 (硬件 软件-Qos)
主从配置差异大,磁盘性能较低,内存和CPU资源都不够充足
尽量让主从配置相同
主从配置区别大,从库配置没有优化,导致并发处理能力低于主库
主库因素导致的延时问题
主要涉及Dump thread 工作效率缓慢,可能是由于主库并发压力比较大
调整内存资源利用率,减少磁盘和内存之间IO消耗
对应业务数据进行拆分,可以实现分库分表操作
进行数据库分布是存储,可以实现并发压力
主要设计主要涉及Dump thread 工作效率缓慢,可能是由于从库数量过多
不要使用太多的从库 (一般 一主三从(备用节点,测试节点,延时节点),最多一主五从)
主要涉及Dump thread 工作效率缓慢,主要由线程本身串行工作方式(利用组提交缓解此类问题-5.6,group -commit)
主库配置
binLog_group_commit_sync_delay# 表示延时多少微秒同步到磁盘binLog_group_commit_sync_no_delay_count# 表示延时提交的最大事务
从库配置 (开启逻辑时钟功能,并设置SQL多线程回放)
slave_parallel_type=logical_clock# 设置回放方式为 logical_clockslave_parallel_workers=8# 设置SQL 回放线程数量
从库因素导致的延时问题
从库产生延时受SQL线程影响较大,由于线程本身串行工作方式导致的
利用不同数据库并行执行事务操作,但是一个库有多张表情况,产生大量并发事务操作,依旧是串型的(5.6开始 多S0L线程回放)
利用logical clock机制进行并发回放,由于组提交事务是没有冲突的,从库并行执行也不会产生冲突(5.7开始 多S0L线程回放)根据日志内容信息,获取logical clock机制的组提交标记信息:(事务级别并发)
其他原因导致的延时问题
由于数据库大事务产生的数据同步延时问题(跟新100W数据/尽量切割事务)
一小部分事务就提交(事务切割)
由于数据库锁冲突机制的数据库同步延时问题 资源被锁定,无法同步 隔离级别配置RR-锁冲突
可以调整RC降低延时,索引主从一致
由于数据库过度追求安全配置也会导致同步延时问题
从库关闭双一参数
1.8.10 请介绍一下你们公司的数据库架构或什么是 MySQL 集群?
1.8.11 请介绍你熟悉的高可用解决方案?
MHA
MGR
1.8.12 请简述 MHA 的搭建过程?
配置基础环境,时间同步,主机名,yum仓库,EPEL仓库,IP地址
配置SSH互信
完成数据库的安装以及主从搭建
主库创建MHA 需要的管理用户
安装MHA的依赖安装MHA软件包
创建MHA配置文件夹,日志补偿文件夹
如果时二进制安装的MySQL需要对 mysql和binlog 两个命令创建软连接
配置VIP漂移脚本,邮件报警脚本
在主库的网卡上创建VIP
在日志补偿文件下启动MySQL binlog远程从主库拉取数据
配置MHA 配置文件
启动MHA 状态检查
启动MHA
1.8.13 请介绍 MHA 重要的脚本及作用?
master_ip_failover
在主节点故障时,将虚拟IP(VIP)从旧主节点切换到新的主节点,确保客户端可以通过VIP无缝连接到新的主节点
master_ip_online_change
用于在线切换主节点的IP地址,支持在不停止数据库服务的情况下完成主节点的切换。
check_relication_health.sh
检查MySQL主从复制的健康状态,确保复制正常运行
start_master_monitor.sh
启动MHA的监控功能,用于持续监控主节点的健康状态
mha_manager
作为MHA的核心管理工具,负责启动、关闭和管理MHA集群
mha_node
部署在每个数据库节点上,用于与MHA Manager通信,在故障转移时保存二进制日志,协助完成故障切换
mha_check_config
用于检查MHA配置文件是否正确,验证配置文件中的参数是否符合要求,确保MHA能够正常运行
apply_diff_relay_logs
在故障转移过程中,将差异的中继日志(relay log)应用到其他从节点,确保所有从节点的数据与新的主节点保持一致
save_binary_logs
在主节点故障时,尝试从宕机的主节点上保存二进制日志,以防止数据丢失 最大程度地保证数据完整性
1.8.14 请简述 MHA 高可用架构原理?
MHA由两部分构成:MHA Manager(管理节点)和MHA Node(数据节点)
在主从复制的MySQL集群中,MHA Manager负责监控主节点的健康状况,当主节点出现故障时,MHA Manager会自动选举出一个从节点升级为主节点,并转移主节点的VIP到新的节点上,同时对新节点进行数据补偿
MHA软件启动
MHA实现监控
MHA选主过程
MHA数据补偿
MHA业务切换
MHA应用透明
MHA故障报警
MHA额外补偿
1.8.15 MHA 如何选主?
会扫描配置文件中的节点信息,然后将扫描后节点信息划分到4个数组中,并根据策略选择数组中的节点成为新主
| alive | 扫描节点是否存活 |
|---|---|
| latest | 扫描节点延迟情况 |
| pref | 扫描节点配置信息是否有(candidate_master=1) 人为定义接替主节点的从节点信息 |
| bad | 不参与选主(no_master=1/log_bin=0/数据差异量-100M) |
4个选主策略
最优策略 (根据节点编号选择 越小越优先)
活着 数据量接近主节点 已经定义接替者身份 不会出现在bad数组中
次优策略 (根据节点编号选择 越小越优先)
活着 数据量接近主节点 不会出现在bad数组中
再次优策略 (根据节点编号选择 越小越优先)
活着 已经定义接替者身份 不会出现在bad数组中
无奈选择 (根据节点编号选择 越小越优先)
活着 不会出现在bad数组中
1.8.16 MHA 优缺点?
MHA的优点
快速故障切换:能够在主库故障时,通常在10-30秒内自动完成主从切换,减少系统停机时间
数据一致性:在故障转移过程中,MHA会尽量保证数据的一致性,尤其是在使用半同步复制或GTID复制时
无需修改现有架构:不需要对现有的MySQL架构进行大规模修改,也不需要额外的存储引擎支持
易于部署:整体部署相对简单,适合中小型企业快速实现数据库高可用
无性能损耗:对数据库的性能几乎没有影响
灵活性高:支持多种故障转移策略和配置选项,可以根据实际需求调整
MHA的缺点
配置复杂性:初始配置需要考虑多个参数,如复制延迟、网络延迟等,对技术人员的经验有一定要求
依赖复制延迟:如果从库的复制延迟较大,可能会导致数据丢失。
单点故障风险:MHA Manager本身可能成为单点故障,需要进行冗余设计
安全隐患:需要配置SSH免密登录,可能会带来一定的安全风险。
不支持读负载均衡:MHA主要关注主从切换,没有提供从库的读负载均衡功能,需要额外的解决方案
资源消耗:在高负载场景下,可能会消耗较多系统资源
1.8.17 请介绍你在维护公司 MHA 架构时主要做了哪些工作或遇到的问题?
数据库服务高可用修复--高可用故障检查
检查节点状态
检查主从关系
修复主从关系
检查虚拟地址
恢复日志同步
调整配置文件
核实互信情况
恢复启动MHA
实现MHA高可用主节点在线切换(手工操作)
可以在主库没有故障的情况下,利用手工方式将主库业务切换到其它的从库节点上,从而解放原有主库节点(维护性操作时应用)
关闭MHA服务程序
编写配置文件信息-手工切换也能实现vip漂移
管理节点上传或者编写脚本
/usr/local/bin/master_ip_online_change编写配置文件
实现主库切换
管理节点执行
xxxxxxxxxxmasterha_master_switch --conf=/etc/mha/app1.cnf --master_state=alive --new_master_host=10.0.0.51 --orig_master_is_new_slave --running_updates_limit=10000--conf=/etc/mha/app1.cnf -- 获取哪个主从架构需要进行主备切换--master_state=alive -- 指定主节点存活状态进行维护切换--new_master_host=10.0.0.51 -- 切换后指定新主机节点信息--orig_master_is_new_slave -- 主从架构需要重构--running_updates_limit=10000 -- 切换等待数据补偿超时时间FLUSH NO_WRITE_TO_BINLOG TABLES #在原有主库执行,切换主库时,新主库进行数据同步时,老主库的binlog日志是稳定的(同步方式最好是半同步复制)
4.验证
关注VIP地址是否切换
关注切换后是否进行了主从重构
关注配置文件信息是否删除
恢复mha(根据数据库维护时长决定)
1.8.18 是否使用过分布式数据库架构?请说明你是如何设计的?
使用过MyCAT
1.8.19 简述 PXC(Percona XtraDB Cluster)高可用集群的工作原理
1.8.20 简述 ProxySQL 读写分离操作步骤
1.8.21 普通半同步与增强性半同步分别在哪个阶段返回 ACK?
普通半同步
在SQL线程回放成功之后会返回ACK
rpl_semi_sync_master_wait_point=after_commit --早期半同步
增强性半同步
在IO线程将信息写入到 relay log 中之后会返回 ACK
rpl_semi_sync_master_wait_point=after_sync --增强半同步
1.8.22 在配置读写分离架构中,下单了一件商品,查询订单时发现没有查寻到结果,说明主从同步还没有写入从库,怎么解决这种问题?
数据库方向:加入半同步
1.8.23 构建多主 mysql 架构,多主同时写,用什么架构搭建?
多主同时写不推荐,原因:主库压力大,可以加 redis,可以分区归档,
分库分表,MHA 构架
1.8.24 什么是双写(架构)?
两主一从
不推荐双写,容易数据不一致
1.8.25 在跨版本搭建主从架构的时候,你遇到过哪些问题,如何解决?
1.8.26 MHA 的探测机制?如何判断主库存活?如何判断MySQL库是否异常?
通过周期性的向主库发送 Ping 和 发送一个 简单的sql 语句(select 1)select user() insert 判断主库是否存活
MHA从0.53版本开始支持ping_type参数来设置如何检查master可用性:
ping_type=select: 基于一个到master的已经存在的连接执行select 1,连接被重复使用,select检查能快速返回结果,但检查过于简单,无法发现更多故障。
ping_type=connect: 在每次执行select 1操作前后创建和断开连接,能更严格和更快速发现TCP连接级别的故障。
ping_type=insert: 基于一个到master的已经存在的连接执行insert语句,连接被重复使用,能更好检测到数据库因磁盘空间耗尽或磁盘IO资源耗尽导致的故障。在0.56版本被引入,在MHA架构中,通常不会直接使用INSERT语句来探测主库存活。MHA主要依赖于从库的复制状态来判断主库的健康状况。然而,在某些定制化的高可用性解决方案中,可以通过INSERT语句向一个心跳表插入一条记录,并检测该记录是否正确复制到从库来监控主库的健康状态
INSERT INTO heartbeat_table (ts) VALUES (NOW());MHA使用ping_interval来设置MHA Manager探测主库故障的间隔,默认间隔3秒,当连续4次ping失败后,则判定master节点发生故障
参考文章 :https://www.cnblogs.com/gaogao67/p/11359667.html
1.8.27 克隆同步用过吗?克隆同步用来干什么的?
1.8.28 克隆同步的原理?
1.8.29主从同步中 如何实现同步过滤?
1.8.30 同步过滤用过吗?有什么作用?
可以控制主从之间同步数据带宽
可以节省从库磁盘资源
1.8.31 主从中断,数据如何恢复?
1.8.32 延迟从库有什么好处?
延时从库可以快速恢复用户删除的数据
1.8.33 如果主库宕机后,HA发⽣切换,这个HA是怎么做的判断?这个没有的⼼跳的机制解决⽹络层⾯或主机层⾯的问题?
1.8.34 什么是GTID,在架构中主库宕机,从库当新主的时候。毕竟主的GTID比从要高,那么从库如何确保GTID?
1.8.35 主库宕机了,哪个从库更接近主库,怎么判断?
1.8.36 新主和从库数据不一致,怎么解决?
1.8.37 主从复制是用GTID实现的吗?原理是什么?GTID起到什么作用?
1.8.38 GTID复制的优点?⽐如说表⾥⾯没有主键怎么处理的?
1.8.39 GTID出来以后为什么推崇使⽤GTID⽅式做复制
1.8.40 ProxySQL读写分离是怎么配置?
1.8.41 半同步什么时候会退化成异步?
rpl_semi_sync_master_wait_point主库等待从库确认消息的超时时间,单位为毫秒。如果超过该时间仍未收到确认消息,半同步复制将退化为异步复制 默认10000ms = 10 s
1.8.42 MHA哪个配置参数是不做候选主节点?
no_master=1
1.8.43 ProxySQL能做到一主几从有限制吗?从库能做到负载均衡吗?
1.8.44 如何让使用人员只能连接主库防止连接错误?
设置从库 read_noly = 1
1.8.45 延迟从库是怎么实现?有什么好处?
从库设置参数
change master to master_delay=15;
开启延迟功能,主要影响SQL线程,限制SQL线程读取回放relaylog日志的时间
作用
可以用于修复主库误操作数据信息
1.8.46 MHA 哪个参数手动指定默认选主
(candidate_master=1) 人为定义接替主节点的从节点信息
1.8.47 如何利用延时从库恢复数据?
停止SQL线程工作,停止主从 ,避免主库误操作行为,在从库回放
xxxxxxxxxxstop slave sql_thread; stop slave;取消延时功能
xxxxxxxxxxchange master to master_delay=0;获取主库误操作事件GTID编号 / 获取主库误操作事件POS位置点
将从库 relay_log 回放到误操作事件之前
xxxxxxxxxxstart slave until relay_log_file='db02-relay-bin.000002', relay_log_pos=1358;使用mysqldump 导出数据
xxxxxxxxxxmysqldump -uroot -B xiaoQ01 --set-gtid-purged=OFF >/tmp/xiaoQ01.sql在主库中恢复数据
xxxxxxxxxxmysql -uroot -S /tmp/mysql3306.sockset sql_log_bin=0;source /tmp/xiaoQ01.sql;set sql_log_bin=1;恢复延时从库
xxxxxxxxxxstop slave;set gtid_next='868db540-f96c-11ef-ba07-000c29141679:24';begin;commit;set gtid_next='AUTOMATIC';start slave;
1.8.48 半同步要关注哪些参数?
主库参数
rpl_semi_sync_master_enabled:是否启用主库的半同步复制功能,取值为 ON 或 OFF
rplsemi_sync_master_timeout:主库等待从库确认消息的超时时间,单位为毫秒。如果超过该时间仍未收到确认消息,半同步复制将退化为异步复制 默认值为10000ms = 10s
rpl_semi_sync_master_wait_for_slave_count: 主库需要等待多少个从库的确认消息才能向客户端返回事务提交成功的信息,默认值为1
从库参数
rpl semi sync_slave_enabled: 是否启用从库的半同步复制功能,取值为 ON 或 OFF
1.8.49 MHA 是如何检查主从数据不一致的
通过对比数据补偿的binlog日志与从库的relay log 日志的差异
1.8.50 proxy sql原理
连接管理:ProxySQL作为中间层,接收客户端的数据库连接请求。它维护一个连接池,与后端数据库服务器建立连接,并根据配置进行连接池管理,包括连接的创建、复用和释放等操作
负载均衡:ProxySQL通过负载均衡算法将客户端请求分发到后端数据库服务器。它可以基于不同的策略(如轮询、最少连接数等)选择目标服务器,从而实现请求的均衡分配,提高整体的并发处理能力和性能
查询分析和重写:ProxySQL可以解析和分析客户端发送的SQL查询语句。通过查询规则和规范的配置,它可以对查询进行修改和重写,以优化查询性能或者实现特定的业务需求。例如,可以进行查询的缓存、路由转发等操作
高可用性和故障转移:ProxySQL可以监控后端数据库服务器的健康状态。当某个数据库节点出现故障或不可用时,它可以自动将请求重新路由到其他可用的节点,实现高可用性和故障转移。同时,它还支持自动检测并剔除故障节点,以避免将请求发送到不可用的服务器上。
查询缓存:ProxySQL提供了内置的查询缓存功能,可以缓存查询的结果
统计和监控:ProxySQL可以收集和记录关于连接、查询和服务器性能等方面的统计信息。ProxySQL还支持与监控系统集成,以实现实时监控和告警功能
1.8.51 mha切换遇到过什么问题,manager在哪个节点,切换原理
MHA手工在线切换后,vip也漂到新主库上,但在其它主机上用vip连接时,却还是连到本主机的从库
解决方法:在所有从库上执行drop_vip.sh即可
mha每次自动切换之后都会结束自身进程,并在日志目录如/app/mha/xxx/下生成成功或失败标记
(sys.failover.complete/error)
下一次要启动mha之前要把这些标记文件删除,否则mha无法正常启动,因为有了这些标记文件,mha认为已经切换结束mha手动切换要指定端口,否则只用ip会被mha认为没有存活
三台物理机相同配置一口咬死防止主从延迟或者宕机后从库顶不住 例如32C核Cpu 128G内存 2T×4 Sata盘1500转 MHA Mannager可以安装一台性能一般的机器上也可以安装在任意从库, 因为安装MHA.Mannger的从库是不参与切换的,只能通过人为切换, 就说安装在一台别的机器上 由于架构方面和软件方面已经实现高可用了,所以在物理层面不用考虑数据冗余问题, 可以考虑性能最大化,比如使用raid0
1.8.52 如何MHA 脑裂会产生什么影响?如何防止MHA脑裂?
多个节点争抢主库角色。会导致多库写入的问题
manager程序与现有主库之间出现网络故障。默认manager是单一心跳检查的。 解决方案∶ 1. 采用多心跳投票机制。例如∶ 多条网络线路(以太网、磁盘网络) (stonith是"shoot the other node in the head"的首字母简写 )
shutdown_script 脚本 利用服务器的远程控制IDRAC等,使用ipmitoo1强制去关机,以避免fence设备重启主服务器, 造成脑列现象.
shutdown_script= /usr/local/bin/power_manager fence∶ 网络fence(ilo、idrac)、电源fence主库被manager节点的monitor检测为失去通信之后触发以下脚本使从库二次检测与主库的通 信从而确定是否进行主从切换 # secondary_check_script脚本
secondary_check_script ="masterha_secondary_check -s 10.0.0.52 -s 10.0.0.53"
1.8.53 分库分表带来了哪些问题?
事务问题。在执行分库之后,由于数据存储到了不同的库上,数据库事务管理出现了困难。如果依赖数据库本身的分布式事务管理功能去执行事务,将付出高昂的性能代价;如果由应用程序去协助控制,形成程序逻辑上的事务,又会造成编程方面的负担。
跨库跨表的join问题。在执行了分库分表之后,难以避免会将原本逻辑关联性很强的数据划分到不同的表、不同的库上,我们无法join位于不同分库的表,也无法join分表粒度不同的表,结果原本一次查询能够完成的业务,可能需要多次查询才能完成。
额外的数据管理负担和数据运算压力。额外的数据管理负担,最显而易见的就是数据的定位问题和数据的增删改查的重复执行问题,这些都可以通过应用程序解决,但必然引起额外的逻辑运算
1.8.54 半同步复制技术与传统主从复制技术不同之处?
在主库提交操作时候会受到阻塞,等待从库IO线程返回ack确认信号后,才能使主库提交操作成功;
从库IO线程接收到binlog日志信息,当日志信息写入到磁盘上的relaylog文件时,会给主库返回ack信号;
在主库上会利用ack_receiver线程接收返回的ack信号;
当主库上的ack_receiver线程接收到ack信号信息时,会产生事件触发机制,告诉主库事务提交操作成功了;
如果在接收ack信号时,等待信号时间超过了预设值的超时时间,半同步复制会切换为原始的异步复制方式;
预设的等待超时时间的数值,由参数rpl_semi_sync_master_timeout设置的毫秒数决定;
1.8.55 主从同步中哪些线程是多线程?
SQL 线程(需要调整参数)
DUMP 线程
1.8.56 SQL 相关参数有哪些,怎么修改SQL 线程数量?
rpl semi sync slave enabled=1
slave-parallel-type=logical clock # 以组方式提交
slave-parallel-workers=8 # 8 个线程
master info repository=table # 存放master信息的形式设置,默认是file
relay log info repository=table # 存放relay日志信息的形式设置,默认是file
relay log recovery=0N # 开启relay日志恢复
1.8.57 描述增强半同步复制和普通半同步复制的区别?
增强半同步复制支持在事务commit前等待ACK
普通半同步复制不支持事务commit前等待ACK,提交数据后等待ACK,然后返回客户端
1.8.58 MHA是怎么预防数据丢失的?
MHA配合半同步复制来降低数据丢失的概率
1.8.59 MySQL 8.0 对死锁的优化?
1.8.60 MySQL 如何实现读写分离?
代码封装
就是代码层抽出一个中间层,由中间层来实现读写分离和数据库连接;
利用个代理类,对外暴露正常的读写端口,里面封装了逻辑,将读操作指向从库的数据源,写操作指向主库的数据源
优点:简单(减少架构服务部署工作量),并且可以根据业务定制化变化,随心所欲
缺点:如果数据库宕机了,发生主从切换之后,就要修改配置重启;如果系统是多语言的话,需要为每个语言都实现一个中间层代码,重复开发
使用中间件
中间件一般而言是独立部署的系统、客户端与这个中间件的交互是通过SQL协议;
所以在客户端看来连接的就是一个数据库,通过SQL协议交互也可以屏蔽多语言的差异;
缺点就是整体架构多了一个系统需要维护,并且可能成为性能瓶颈,毕竟交互都需要经过它中转;
常见的开源数据库中间件有:mysql-router、ProxySQL、Atlas、ShardingSphere、MyCAT等;
1.8.61 什么是读写分离
读写分离就是读操作和写操作从以前的一台服务器上剥离开来,将主库压力分担一些到从库
主库的压力过大,单机数据库无法支撑并发读写,一般而言读的次数远高于写,因此将读操作分发到从库上,这就是常见的读写分离
读写分离还有个操作就是主库不建查询的索引,从库建查询的索引,因为索引是需要维护的
比如:插入一条数据,不仅要在聚簇索引上面插入,对应的二级索引也要插入,修改也是一样的
所以将读操作分到从库之后,可以在主库把查询要用的索引删除了,减少写操作对主库的影响
1.8.62 mysql一个表上亿条的数据怎么保证同步过去,如何解决延时?
1.8.63 使用延时同步恢复数据,比如延时5分钟,怎么保证你停止slave后,新的数据不会丢失
1.8.64 MySqL 并行复制都有哪些 具体说说?
以前从库是通过一个SQL线程按照顺序逐条执行主库的 binlog 日志指令(即从 relaylog重放事件)
对于主库的高并发写入操作,这种串行执行的方式会导致从库的复制速度跟不上主库,从而产生主从延迟问题
所以 MySQL 引入了并行复制,说白了就是通过多个SQL线程来并发执行重放事件
MySQL 5.6 基于库级别的并行复制
假设主库有多个数据库(如 db1和db2),在从库上,db1的事务和db2的事务可以同时执行。
即将不同数据库上的事务分配到不同的 SQL线程中执行。
说明:如果主库大部分事务集中在一个数据库上,这个就没啥用了。
MySQL5.7 基于组提交(GroupCommit)事务的并行复制
进一步细化了并行的颗粒度,从库级别细化到组提交级别。
即MySQL会将组提交的事务视为彼此独立的事务,可以在从库并行重放。
如果主库开启了组提交,且事务之间没有冲突。那么这些事务都可以由多线程并行执行。
binlog中如果两个事务的1ast_comitted相同,说明这两个事务是在同一个 Group 内提交的。
但是粒度还是不够,如果大部分事务都集中在一张表上?
那么只有相同 1ast_committed 可以并发,即使有些数据的更改和当前事务是不冲突的,也无法并发。
MySQL 5.7 基于逻辑时钟(LOGICAL CLOCK)的并行复制
LOGICAL_CLOCK 是基于 Group commit 的并行复制,引入了时间标记的概念。
基于所有在主库同时处于prepre阶段且未提交的事务不会存在锁冲突的情况(就是这些事务在从库执行时都可以并行执行);
将这些事务都打上一个时间标记(实际实现用的是上个提交事务的 seguence number,即上面提到的binlog中的last_committed)。
这样从库在识别到这些事务时,可以并行,进一步的提高并发度。
提升主库的组提交事务数可以让从库复制的并行度更高,所以 MySQL 5.7 引入了两个参数:
xxxxxxxxxx# 在主库进行以下配置binlog_group_commit_sync_delay-- 组提交等待延迟提交的时间;即每次 binlog 组提交时等待一段时间再 fsync;让进入 group 的事务更多,提高并行度。
binlog_group_commit_sync_no_delay_count-- 组提交时允许的最大事务数量,达到该数量时立即触发组提交,而无需等待延识时间(binlog group commit sync delay)-- 即达到期望的并行度后立即提交,缩小等待时长
# 在从库进行以下配置  slave_parallel_type=loglcal_clock-- 设置回放方式为loglcal_clockslave_parallel_workers=8-- 设置SQL回放数据线程数量
MySQL8.0 基于 WriteSet 的并行复制
由于MySQL5.7中,为了提升从库的事务回放速度,需要在主库提高事务的并行度。
主库上的事务越多线程并行提交,备库就能在更大程度上实现并行回放。
然而,这种方式依赖于主库的并行提交情况,当主库事务是串行提交时,备库的回放效率会显著下降。
所以MySQL8.0中, 引入了基于Writeset的并行复制,即使主库上的事务是串行提交的,只要事务之间没有冲突,备库也可以并行回放这些事务,
提升复制效率。
writeset是事务更新行的集合,通过哈希算法对主键或唯一索引生成标识,记录在二进制日志中
即通过 witeset判定事务之间的冲突,如果两个事务的 Writeset没有冲突,则它们可以并行回放
1.8.66 MySQL 8.0 死锁检测视图有哪些?
INNODB_TRX
查看当前所有运行中的事务状态,包括事务 ID、锁等待状态、事务开始时间等
INNODB_LOCK_WAITS
显示正在等待锁的事务与被阻塞的锁信息,明确锁等待的双方关系
INNODB_LOCKS (MySQL 8.0 中已弃用)
performance_schema.data_locks 和 data_lock_waits 表
记录当前所有锁的详细信息,包括锁类型(行锁、表锁)、锁模式(共享/排他)等
监控
1.9.1 MySQL zabbix 你都监控哪些指标?
物理层:cpu,内存,磁盘
传输层:端口,进程,api接口应用层:URL
Mysql业务层:select,insert,update,delete执行频率和数量,吞吐量:接受和发送的字节数
sql慢查询
主从复制双YES
1.9.2 现在有⼀个MySQL有很多慢查询,现在要通过监控,主要观察哪些指标?
1.9.3 shell 脚本都监控那些指标?
1.9.4 日常工作需要监控 MySQL 哪些指标?
MySQL 服务器硬件状态
CPU 利用率:数据库进程的 CPU 使用情况
内存使用:MySQL 守护进程的内存占用情况
系统内存与交换分区使用:观察系统内存的使用情况,避免因内存不足导致的性能下降
数据库数据大小:统计每个数据库和数据表的存储大小情况
MySQL 服务器负载
系统负载:监控服务器的整体负载情况,使用系统的性能监控工具(如 top 或 htop)
I/O 等待:查找 I/O 等待的情况,了解是否存在性能瓶颈
数据库磁盘I/O:数据库的读写磁盘操作次数
MySQL 连接与会话
序号 监控指标 解释说明 01 Aborted_clients 客户端已成功建立,但中途异常断开的连接的次数 02 Aborted_connects 连接 MySQL 服务端失败的次数。 03 Threads_connected 当前连接到数据库的会话线程总数,等于 SHOW PROCESSLIST 的总条数 04 Threads_running 当前正处于运行状态的连接数,等于即 SHOW PROCESSLIST 中非 sleep 状态的连接数 05 Max_connections 数据库配置允许的最大连接数 数据库性能与连接监控指标
序号 监控指标 解释说明 01 Queries 数据库服务接收到的SQL语句处理次数;
可以通过 SHOW GLOBAL STATUS LIKE 'Questions' 查询02 Slow_queries 记录下来的执行时间超过 long_query_time 设置的查询数量 03 Com_select 表示统计select操作的执行次数 04 Com_commit 表示统计commit操作的执行次数 05 Com_rollback 表示统计rollback操作的执行次数 06 QPS (Queries Per Second) 每秒钟执行的查询数 07 TPS (Transactions Per Second) 指每秒钟执行的事务数 TPS监控指标计算方法
监控状态变量
利用如下操作命令,对数据库的状态变量进行监控,从而获取自数据库启动以来的提交事务和回滚事务的总数
xxxxxxxxxxSHOW GLOBAL STATUS LIKE 'Com_commit';-- 获取提交事务数量SHOW GLOBAL STATUS LIKE 'Com_rollback';-- 获取回滚事务数量周期定时监控
记录在给定时间间隔内的事务数量
TPS监控指标计算公式:
xxxxxxxxxxTPS = (当前时间点的 Commit 数 + 当前时间点的 Rollback 数 - 上一个时间点的 Commit 数 - 上一个时间点的 Rollback 数) / 时间间隔(秒)
数据库锁的监控
序号 监控指标 解释说明 01 Innodb_lock_waits 当前有多少锁被请求并等待 02 Innodb_row_lock_time_avg 平均每次锁等待时间 02 Innodb_deadlocks 出现的死锁次数 03 Table_locks_waited 等待表锁的次数 数据库缓冲池监控
序号 监控指标 解释说明 01 Innodb_buffer_pool_size 数据库缓冲池的总大小 02 Innodb_buffer_pool_reads 未从缓冲池读取的次数 03 Innodb_buffer_pool_read_requests 从缓冲池读取的次数 04 Innodb_buffer_pool_pages_total 缓冲池的总页数 05 Innodb_buffer_pool_pages_free 缓冲池的空闲页数 06 Innodb_buffer_pool_bytes_data 数据库缓冲池的数据字节量 可以通过查看InnoDB集群状态信息,计算得出缓冲区域数据命中率
(1-Innodb_buffer_pool_reads/Innodb_buffer_pool_read_requests)*100%
可以通过查看InnoDB集群状态信息,计算得出缓冲区域空间使用率
((Innodb_buffer_pool_pages_total-Innodb_buffer_pool_pages_free)/Innodb_buffer_pool_pages_total)*100%
数据库主从监控
复制延迟(Seconds Behind Master)
主库dump线程
IO线程/SQL线程运行状态
中继日志空间使用
主从数据一致性校验结果
高可用指标
集群节点健康状态
故障切换次数
.VIP漂移状态
MHA/Proxy中间件状态
连接池>80%、复制延迟>30s、缓冲池命中率<95%、磁盘空间<20%
1.9.5 数据库集群监控信息?
基础资源层
CPU使用率(user/system/iowait)
内存利用率(包括swap使用)
磁盘IOPS/吞吐量/延迟
存储空间(数据目录/二进制日志/临时表空间)
连接管理
当前连接数/最大连接数占比
活跃连接数眠连接教
连接失败率(Aborted connects)
线程缓存命中率(Threads created/Connections)
查询性能
慢查询数量(Slow_queries)
查询吞吐量(QPS/TPS)
临时表创建率(Created tmp tables)
排序合并率(Sort merge_passes)
全表扫描率(Select scan)
复制拓扑(主从架构)
复制延迟(Seconds Behind Master)
IO线程/SQL线程运行状态
中继日志空间使用
主从数据一致性校验结果
InnoDB引擎
缓冲池命中率/利用率/脏页比例
行锁等待/死锁数量(Innodb row lock waits)
日志写入量(lnnodb os log_written)
检育点年龄(Checkpoint age)
Undo表空间使用趋势
高可用指标
集群节点健康状态
故障切换次数
.VIP漂移状态
MHA/Proxy中间件状态
连接池>80%、复制延迟>30s、缓冲池命中率<95%、磁盘空间<20%
1.9.6 你平常如何监控锁状态的?
全局锁:Global Read lock
监控:show processlist;
行锁:row lock wait
监控:Show status like ‘innodb_row_lock%
死锁
1.9.7 数据库主从监控有哪些方式?
利用数据库命令监控
show slave status 监控关注信息 Seconds_Behind_master
利用PT工具进行监控
pt-heartbeat --user=xx --password=xxx -h master --create-table --database xxx --update --daemonize --interval =1
pt-heartbeat --user=xx --password=xxx -h slave --databasecrn --monitor --daemonize --log /tmp/slave_lag.log
数据库设计
1.10.1 数据库范式有哪些?
基础范式
第一范式(1NF)
核心要求:字段值不可再分,每个属性都是原子数据
例子:避免存储复合数据(如“地址”拆分为省、市、区)
意义:确保数据存储的最小单位,为后续范式奠定基础
第二范式(2NF)
核心要求:在满足1NF的基础上,所有非主属性完全依赖主键(消除部分依赖)
例子:订单表中商品名称仅依赖商品ID(联合主键的一部分),需拆分为订单表和商品表
意义:解决数据冗余(如重复存储商品名称)和更新异常
第三范式(3NF)
核心要求:在满足2NF的基础上,非主属性之间无传递依赖
例子:学生表中“学院电话”依赖“学院”,需拆分为学生表和学院表
意义:消除间接依赖,避免冗余和更新异常
高级范式
巴斯-科德范式(BCNF)
核心要求:所有主属性必须直接依赖候选键,消除主属性之间的传递依赖
例子:若“课程→教师”且“教师→学院”,需拆分为课程-教师表和教师-学院表
意义:比3NF更严格,解决主键属性间的依赖问题
第四范式(4NF)
核心要求:消除多值依赖(同一主键下存在多个独立属性组)
例子:若员工有多个技能和语言,需拆分为技能表和语言表
意义:解决多值数据冗余。
第五范式(5NF,完美范式)
核心要求:消除连接依赖(数据关系需通过多个表联合表示)
例子:供应商-产品-客户关系需拆分为三个两两关联的表
意义:确保数据关系的无损失分解
1.10.2 数据库的三大范式是什么?
第一范式(1NF):原子性
表中的每个字段不可再拆分,存储最小单位的单一数据 避免混合存储多个值,便于查询和统计 比如:广东省深圳市南山区 拆分成省,市,区 三个字段
第二范式(2NF):完全依赖
在满足1NF的基础上,所有非主键字段必须完全依赖主键(而非主键的一部分) 消除部分依赖,解决数据冗余和更新异常 比如:订单表(订单号、商品ID、商品名称、单价)中,若主键是“订单号+商品ID”,则“商品名称”仅依赖商品ID(主键的一部分),需拆分为订单表(订单号、商品ID、单价)和商品表(商品ID、名称)
第三范式(3NF):消除传递依赖
在满足2NF的基础上,非主键字段之间不能存在依赖关系(即间接依赖主键) 避免冗余存储和更新异常 比如:学生表(学号、姓名、学院、学院电话)中,“学院电话”依赖“学院”,而非直接依赖主键“学号”。需拆分为学生表(学号、姓名、学院)和学院表(学院、电话)
1.10.3 为什么要分库分表
是提高性能:随着数据量的增加,单个数据库或表的读写、查询性能会显著下降。分库分表可以将负载分散到多个数据库或表中,减少单点压力,提高查询响应速度和事务处理能力。
避免硬件限制:数据库的大小和性能往往受到所在服务器硬件的限制。分库分表使得数据库能够跨多个服务器扩展,突破单机硬件资源的限制。
增强可用性和容错性:将数据分布在多个数据库或表中,可以降低单点故障的风险。即使某个数据库或表发生故障,也不会影响到整个系统的可用性。
提高管理效率:对于极大的数据集,进行分库分表后,可以更方便地进行数据维护、备份和恢复等操作,因为操作可以在更小的数据集上进行,减少了处理时间和复杂度。
支持数据的地理分布:根据用户地理位置将数据分布在不同的数据库中,可以减少数据传输延迟,提高用户体验,数据本地性的逻辑
1.10.4 什么是分库分表?分库分表有哪些类型(或策略)?
分库分表用于解决单个数据库或单个数据表在数据量巨大或并发访问高时所带来的性能瓶颈和扩展性问题
其核心思想是将大数据量分散存储到多个数据库或数据表中,从而减轻单个节点的负载,提高整体系统的处理能力和稳定性
分库分表常见的策略有垂直分库/分表和水平分库/分表:
垂直分库/分表:根据业务功能或数据模块将数据进行拆分,比如将用户数据和订单数据分开存储。
水平分库/分表:按照数据记录的某个字段(例如用户ID的范围或取模后的值)将数据行拆分到不同的库或表中,从而实现数据均衡分布。
垂直拆分和水平拆分,细分策略:
垂直拆分
垂直分库:根据业务模块或功能将不同类型的数据放入不同的数据库中。例如,将用户、订单、商品数据分别存储在独立的数据库中。这样可以降低不同业务之间的资源竞争,提升独立性和安全性。
垂直分表:将一张表中不常一起查询的字段拆分成多张表,通常是一对一的关系。这样可以减少单表宽度,优化查询性能。
水平拆分
主要针对单表数据量巨大或高并发场景,将表中的数据记录拆分到多个子表中,常见方式包括:
同库水平分表:所有子表位于同一数据库中,适用于单表数据量巨大时减少单表记录数。
多库水平分表:数据不仅分散到多个子表,而且这些子表分布在不同的数据库实例上,从而进一步分散负载和压力
一般业务量到达3000-4000W 行时我们就需要考虑分表
在水平分表中,常用的具体拆分策略有:
哈希分片:对拆分键(如用户ID)进行哈希计算,然后根据哈希值将数据均匀分布到各个分片。优点是数据分布均匀,但对范围查询支持不佳。
范围分片:按照字段值的区间(如ID范围或日期区间)将数据划分到不同的分片上,适合需要做范围查询的场景,但可能会遇到数据倾斜的问题。
一致性哈希分片:基于一致性哈希算法实现数据映射,便于在动态增减节点时减少数据迁移量,适用于需要频繁扩容或缩容的场景。
映射表分片:通过维护一张映射表,记录数据和分片的对应关系,实现灵活的数据路由,适合对分片规则要求灵活调整的场景
取模
枚举
ER 模型
1.10.5 大厂数据库架构
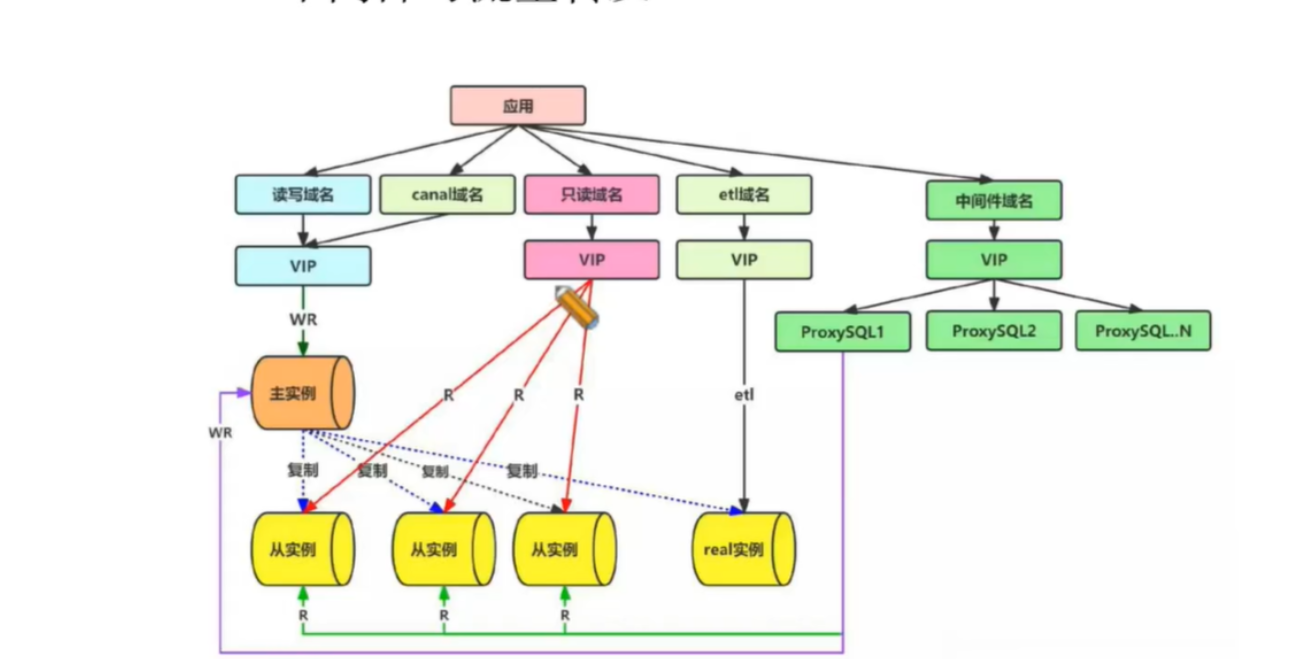
1.10.6 对数据库进行分库分表可能会引发哪些问题?
事务
使用关系型数据库,有很大一点在于它保证事务的完整性。
而分库之后单机事务就用不上了,必须使用分布式事务来解决,而分布式事务相对而言就比较重了,而且大部分的分布式事务只能保证最终一致性;
连表 JOIN 问题
在一个库中还可以利用 JOIN 来连表查询,而跨库了之后就无法使用 JOIN 了。
此时的解决方案就是在业务代码中进行关联,也就是先把一个表的数据查出来,然后通过得到的结果再去查另一张表,然后利用代码来关联得到最终结果。
这种方式实现起来稍微比较复杂,不过也是可以接受的;
还有可以适当的冗余一些字段。比如:以前的表就存储一个关联ID,但是业务时常要求返回对应的Name或者其他字段。
这时候就可以把这些字段冗余到当前表中,来去除需要关联的操作。
或者通过宽表的形式查询,比如将数据全量存储至 ES 中,利用 ES 来查询数据。
全局ID 唯一性问题
以前单库单表直接使用数据库的自增ID即可,但是分库分表之后,使用自增ID会导致重复主键的情况;
此时需要利用雪花算法或者其他全局唯一ID发号器来生成唯一主键。
排序问题
单表直接通过 order by 进行排序即可,分库分表后直接利用数据库是无法实现排序的。
要么利用分库分表中间件的能力进行汇总排序,要么自己在业务代码中排序,要么利用ES存储全量数据排序查询
count 问题
其实和排序问题类似,单表可以直接 count,分库分表后无法支持,只能多表 count 然后业务代码中累加,或者单独搞一个地方来维护总数;
要么还是利用ES
优化
1.11.1 CPU load 和 CPU使用率有了解吗?
1.11.2 集群的稳定性的优化都有哪些方法?
1.11.3 MySQL 的碎片是怎么优化的?
OPTIMIZE TABLE
OPTIMIZE TABLE 命令在执行时会锁定表,影响对表的写入。 在执行 OPTIMIZE TABLE 命令时,MySQL 会创建一个临时表,将原表中的数据复制到临时表中,并在数据复制完成后删除原表,然后将临时表重命名为原表的名称。在这个过程中,原表会被锁定,无法进行写入操作
ALTER TABEL table_name engine=innodb; 原理与 OPTIMIZE TABLE 相同
1.11.4 你观察到⼀个表/库性能下降,现在的引擎已经是innoDB引擎了如何做优化?(你们当时是在什么规格的数据库上,有多少条数据,然后导致性能下降)
1.11.5 在mysql出现性能问题的时候,你是怎么处理的?性能优化案例
1.11.6 MySQL的CPU使⽤率100%,你会怎么处理?
使用 top -h 定位到线程的PID号
mysql中查询 performance_schema.threads 中的 thread_os_id
1.11.7 某⼀个库导致性能慢,你怎么处理?
1.11.8 SQL语句的优化你是怎么优化的?有遇到没有⾛索引的情况?
1.11.9 对于大表你们以前是怎么做优化?
1.11.10 单表多大合适?
数据库中的表要合理规划,控制单表数据 ,对于MySQL数据库来说,建议单表记录数控制在 2000W 以内。
MySQL 实例下,数据库、表数量尽可能少:数据库一般不超过 50 个,每个数数据库下数据表一般不超过 500 个(包括分区表)。
中小型公司 每天存储进MySQL 20~30G.如果是utf8字符集大概是4000万行数据所以得出一个表控制在15G以内较为合适
1.11.11 怎么测试mysql的性能?
Sysbench 款主流的性能测试工具 本身是开源的, 具备多线程压测能力, 覆盖硬件和层面 , 产品隶属于 Percona tpcc-mysql 该工具是 Percona 按照 TPC-C 开发的产品,主要用于 MySQL 压测。 Mydbtest 该工具由知名数据库专家楼方鑫先生开发 免安装 ,上手快 ,可以针对业务做定制化压测 mysqlslap MySQL 基准测试工具,自 MySQL 5.1.4 版开始推出, 可以通过并发客户端访 MySQL 来执行压力测试
1.11.12 怎么提升mysql的性能?
优化数据库与索引的设计
优化SQL语句
加缓存【Memcached, Redis】
主从复制,读写分离
垂直拆分,其实就是根据你模块的耦合度,将一个包含多个字段的表分成多个小的表,将一个大的系统分为多个小的系统,也就是分布式系统
水平切分,针对数据量大的表,这一步最麻烦,最能考验技术水平,要选择一个合理的sharding key,为了有好的查询效率,表结构也要改动,做一定的冗余,应用也要改,sql中尽量带sharding key,将数据定位到限定的表上去查,而不是扫描全部的表
数据库与索引设计
表字段避免null值出现,null值很难进行查询优化且占用额外的索引空间,推荐默认数字0代替null
尽量使用INT而非BIGINT,如果非负则加上UNSIGNED(这样数值容量会扩大一倍),当然能使用TINYINT、SMALLINT、MEDIUM_INT更好
使用枚举或整数代替字符串类型
尽量使用TIMESTAMP而非DATETIME
单表不要有太多字段,建议在20以内
用整型来存IP。【可去搜索IP地址转为整型】
索引设计
需要创建索引:
频繁作为where查询的字段 (select,update,delete 的where 条件)
DISTINCT 字段需要创建索引
经常使用GROUP BY 和 ORDER BY 的列
注意事项:
字段的数值具有唯一性限制 (业务上具有唯一特性的字段,即使是组合字段,也必须组成唯一索引)
对列的类型小的创建索引 (数据类型越小查询速度越快)
列值长度较长的索引列,建议使用前缀索引 (截取字符串前面的一部分建立索引(前缀索引),全文索引会占用空间和查询时间)
使用散列度高的列作为索引 (但不一定 例如性别,在男性多的中查找女性,如果对女性做索引就能增加查询速度)
使用最频繁的列放到联合索引的左侧
多表连接时创建索引
连接表的时尽量不要超过三张
对于连接的字段创建索引 (JOIN ON )
最好使用唯一值多的列作为索引,如果索引列重复值较多,可以考虑使用联合
索引维护要避开业务繁忙期
SQL优化
使用limit对查询结果的记录进行限定
避免使用select *,将需要查找的字段列出来
使用连接(join)来代替子查询
拆分大的delete或insert语句
不做列运算:SELECT id WHERE age + 1 = 10,任何对列的操作都将导致表扫描,它包括数据库教程函数、计算表达式等等,查询时要尽可能将操作移至等号右边
sql语句尽可能简单:一条sql只能在一个cpu运算;大语句拆小语句,减少锁时间;一条大sql可以堵死整个库
OR改写成IN:OR的效率是O(n)级别,IN的效率是O(logn)级别,in的个数建议控制在200以内
不用函数和触发器,在应用程序实现
避免%xxx式查询
少用JOIN
使用同类型进行比较,比如用'123'和'123'比,123和123比
尽量避免在WHERE子句中使用 != 或 <> 操作符,否则导致引擎放弃使用索引而进行全表扫描
对于连续数值,使用between不用in:select id from t where num between 1 and 5
列表数据不要拿全表,要使用LIMIT来分页,每页数量也不要太大
分页,使用延时关联,和基于游标法
强制走 join 连接算法
分区、分库、分表
把一张表的数据分成n个区块,在逻辑上看最终只是一张表,但底层是由n个物理区块组成的,通过将不同数据按一定规则放到不同的区块中提升表的查询效率
水平分表:为了解决单表数据量过大(数据量达到千万级别)问题。所以将固定的id hash之后mod,取若0~n个值,然后将数据划分到不同表中,需要在写入与查询的时候进行id的路由与统计
垂直分表:为了解决表的宽度问题,同时还能分别优化每张单表的处理能力。所以将表结构根据数据的活跃度拆分成多个表,把不常用的字段单独放到一个表、把大字段单独放到一个表、把经常使用的字段放到一个表
分库: 面对高并发的读写访问,当数据库无法承载写操作压力时,不管如何扩展slave服务器,此时都没有意义了。因此需对数据库进行拆分,从而提高数据库写入能力,这就是分库
1.11.13 MySQL中SQL语句执行慢的排查过程?以及对应怎么进行处理?
MySQL数据库在进行SQL处理过程中,主要有以下方面会造成语句处理过程慢:
数据库服务索引功能没有合理应用
通常数据库服务索引没有合理应用,是数据库服务层优化器没有正确选择索引方案导致;
可以利用explain查看执行计划信息,获取SQL语句的索引使用情况,从而对没有使用索引的SQL语句进行优化;
数据库服务并发连接数量设置过小
数据库连接管理模块是负责管理客户端和MySQL之间的长连接;
假设两者之间只有一条长连接,那么在执行SQL查询过程中,会阻塞新的查询请求;当前面查询请求结果返回后,才能继续处理新的查询请求;
当出现大量并发查询请求时,那么后面的请求都需要等待前面的请求执行完成后,才能开始执行,因此导致出现SQL语句执行慢的情况
数据库服务缓存数据资源空间过小
在数据库应用InnoDB存储引擎时,在内存结构部分会有一个buffer Pool区域,用于缓存磁盘加载的数据信息,从而加速查询效率
当buffer pool空间越大时,存储的数据页信息会越多,因此在SQL语句查询时,越有可能命中缓存中的数据页信息,提高查询数据效率
反之,当buffer pool空间设置过小时,存储的数据页信息会更少,因此在SQL语句查询时,需要从磁盘中调取数据,加载到内存中,查询效率就降低
问题分析
当出现SQL语句执行慢的情况,需要先掌握SQL语句的基本处理流程:
MySQL客户端(发送SQL处理请求)---> MySQL服务端(处理客户端SQL语句请求)
MySQL服务端在进行处理时,会利用Server层对语句进行处理,主要分为调取数据和存储数据,最终都是为了获取数据位置点;
MySQL服务端在进行处理时,会利用engine层控制管理磁盘和内存,最终完成数据信息的存储和调取需求,完成后的结果会返回给客户端。
当掌握了SQL语句处理流程后,可以利用MySQL慢查询日志,获取慢查询SQL语句信息:
在mySQL配置文件中添加或修改如下内容,开启慢查看日志功能:
xxxxxxxxxx[mysqld]slow_query_log = 1slow_query_log_file = /var/log/mysql/mysql-slow.loglong_query_time = 2log_queries_not_using_indexes=1;日志文件会记录哪些SQL语句是慢查询,还会记录执行的开始时间,查询时间,锁定时间,查询行数等信息:
xxxxxxxxxx# Time: 2022-10-01T14:20:00.000000Z# User@Host: root[root] @ localhost [127.0.0.1]# Query_time: 5.123456 Lock_time: 0.000166 Rows_sent: 3 Rows_examined: 1024SET timestamp=1664623200;SELECT * FROM large_table WHERE some_column = 'value';会使用mysqldumpslow命令工具来整理和分析慢查询日志:
xxxxxxxxxxmysqldumpslow -s c -t 10 /data/3306/data/xiaoQ-01-slow.log -- 根据慢查询语句出现次数,进行统计分析前10个出现次数最多的慢查询语句mysqldumpslow -s t -t 10 /data/3306/data/xiaoQ-01-slow.log -- 根据慢查询语句查询时间,进行统计分析前10个查询最耗时的慢查询语句
在慢查询日志中发现SQL语句慢的情况,主要可以利用下面方法进行相关调整和优化:
1)数据库服务并发连接数量设置过小
由于客户端与服务端之间的并发连接数量过小,导致大量SQL语句请求从客户端发送到服务端处理过程是串行化的,影响了后续语句处理效率;
可以适当调整客户端和服务端之间的并发连接数;
xxxxxxxxxxmax_connections=1000-- 单节点建议不高于3000说明:如果出现高并发访问情况,单个数据库能够进行并发处理的能力也会到达上限(1000~5000),次数需要从架构和业务层面进行优化调整
2)数据库服务索引功能没有合理应用
通常对于MySQL进行SQL语句处理时,没有合理应用索引情况可以大体分为两个方面:
SQL语句信息书写问题,无法正确加载索引;
通常SQL语句书写问题,包括:没有定义条件,条件没有对应索引,条件采用匹配查询,条件信息没有符合最左原则;
SQL语句信息书写正确,索引信息应用异常;
通常索引信息应用异常,包括:索引创建不合理,索引应用失效,索引相关优化未配置;
3)数据库服务缓存数据资源空间过小
由于数据库buffer pool空间过小,会造成数据库查询过程,会经常消耗磁盘IO资源,影响数据查询效率,所以可以调整缓存大小;
提高buffer pool空间大小,可以增加查询数据的命中率,从而提高SQL语句的查询效率,也减少磁盘的IO资源消耗;
xxxxxxxxxxinnodb_buffer_pool_size = 64G -- 表示定义buffer pool的空间大小(基于128G内存配置,建议不要超过70~80%) 对于buffer pool的大小调整多少合适,以至于不会太小,影响查询效率,可以查看缓存命中率:
xxxxxxxxxxmysql> show status like 'innodb_buffer_pool_%';-- 获取buffer_pool 状态信息+---------------------------------------------------+--------------------------------------------------+| Variable_name | Value |+---------------------------------------------------+--------------------------------------------------+| Innodb_buffer_pool_read_requests | 25709 |-- 表示度请求的次数| Innodb_buffer_pool_reads | 852 |-- 表示从物理磁盘中读数据的请求次数利用以上状态表的信息,可以通过以下公式信息,获取buffer pool缓存命令率数值:
通常buffer pool的命中率都在99%以上,如果计算得到缓存命中率低于这个数值,就需要考虑加大InnoDB buffer Pool的大小
1.11.14 MySQL会做哪些性能优化设置?
数据库服务硬件层面优化
硬件配置建议
品牌: DELL HP IBM 华为 浪潮
CPU :Inter-I系列 E 系列(Xeno) 核心数多
内存:ECC 功能特性内存,提高计算机运行的稳定性和增加可靠性
IO类型:SAS pci-e SSD Nvme flash
Raid选型:Raid 10
网卡选型:单卡单口网卡(使用寿命较长)
云存储选型:ECS RDS PolarDB TDSQL
硬件参数调配
关闭 Numa (早期SMP)
在 BIOS中进行调整
OS GRUB 级别关闭
cat/proc/cmdline
开启CPU 高性能模式
minimal power--->Maximum Performance
关闭 THP (Transparent Huge Pages 透明大页内存)
getconf PAGE_SIZE
网卡绑定操作 binding 技术
操作服务系统层面优化
更改文件句柄和进程数
vim /etc/sysctl.confvm.swappiness = 5使用swap 积极性 值越高使用率越高vm.dirty_ratio= 20vim/dirty_backgroud_ratio= 10
vim /etc/security/limits.confhard nofile 63000可打开的文件描述符的最大数,超过会报错soft nofile 63000可打开的文件描述符lsof -p pid可以查看打开文件数量ulimit -a查看 open file
防火墙和 selinux 安全设置
关闭selinux 和防火墙
文件系统设置
推荐使用 XFS 系统
不建议使用LVM
设置数据库为独立分区,使用 /data 将磁盘阵列单独挂载到 /data
IO 调度优化
echo deadline > /sys/block/sda/queue/scheduler
数据库服务参数配置优化
连接层优化
xxxxxxxxxxmax_connections=1000-- 单节点建议不高于3000max_connect_errors=999999-- 定义最大连接失败的次数,当超过定义的数值,就会影响正常的连接建立wait_timeout=600-- 定义连接会话的超时时间(释放更多的连接数),具体指定sleep连接会话的超时时间interactive_timeout=3600-- 定义连接会话的超时时间(释放更多的连接数),定义交互式的超时时间net_read_timeout=120net_write_timeout=120-- 定义网络传输读或写数据包的超时时间;max_allowed_packet=32M-- 定义允许的最大数据包大小服务层优化
xxxxxxxxxx# 服务层相关优化参数sql_safe_updates = 1-- 设置当使用update或delete命令时,必须加上where才能执行slow_query_log = ONslow_query_log_file = /xxxlong_query_time = 1log_queries_not_using_indexes = ONlog_throttle_queries_not_using_indexes = 10 -- 不走索引的相同索引语句只记录指定的次数-- 进行数据库慢日志信息相关配置sort_buffer_size = 262144join_buffer_size = 262144read_buffer_size = 131072read_rnd_buffer_size = 262144-- 定义session级别的缓冲区大小,不建议设置大小超过8M,因为是根据每个会话进行的缓冲区分配;tmp_table_size = 16777216max_heap_table_size = 16777216-- 生成的临时表空间建议不超过128Mmax_execution_time = 28800-- 当跑大的事务操作时,可以设置事务最大的执行时间,建议再跑批量操作时,可以设置大些lock_wait_timeout = 60-- 表示设置锁等待的时间,当锁定时间到达指定时间后,会实现自动解锁(主要针对元数据锁,默认是1年)lower_case_table_names = 1-- 表示创建表时,自动将表名的大写信息转化为小写;(必须初始化时进行设置)thread_cache_size = 64-- 表示设置线程缓存的个数信息,可以使线程缓存资源进行复用,从而减少CPU工作压力;(比如连接线程就可以应用)character_set_server = utf8mb4-- 设置数据库服务端字符集,建议设置为utf8或utf8mb4log_timestamps = SYSTEM-- 表示设置日志信息的时间尽量和系统时间信息保持一致init_connect = '普通用户登录信息'init_connect='insert into auditdb.access(thread_id,login_time,localname,matchname) values (connection_id(),now(),user(),current_user());'-- 一般在进行审计时进行使用,表示普通用户登录时,自动进行相应语句的操作-- 参考链接说明:https://blog.csdn.net/mingli_a/article/details/115351986event_scheduler = OFF-- 事件调度信息一般不用使用,关闭即可secure-file-priv=/tmp/-- 当需要在数据库子系统中把信息导出到当前系统指定目录文件中时,进行使用expire_logs_days = 10sync_binlog = 1log_bin = ONlog_bin_basename = /data/3306/binlog/mysql-binlog_bin_index = /data/3306/binlog/mysql-bin.indexmax_binlog_size = 500Mbinlog_format = ROWmax_binlog_cache_size = 2Gmax_binlog_stmt_cache_size = 2G-- 表示和binlog有关的配置信息数据库引擎层优化
xxxxxxxxxx# 引擎层相关优化参数transaction_isolation = "READ-COMMITTED"-- 设置事务默认隔离级别,基本RC级别即可innodb_data_home_dir = /xxx-- 表示定义共享表空间文件ibdate存储路径(了解即可)innodb_log_group_home_dir = /xxx-- 表示定义redo日志文件存储路径(了解即可)innodb_log_file_size = 2048M-- 表示定义redo日志单个文件大小(建议1~4G)innodb_log_files_in_group = 3-- 表示定义redo日志文件的组数(一般可以定义为3~4组)innodb_flush_log_at_trx_commit = 2-- 表示定义事务redo日志刷新到磁盘的策略(双一配置中的其中一个),有binlog日志时,可以不用设置为1innodb_flush_method = O_DIRECT-- 表示log buffer中的信息是直接写入到磁盘中的,而不经过系统的buffer(建议硬盘配合SSD使用)innodb_io_capacity = 1000innodb_io_capacity_max = 4000-- 表示每次IO可以刷新数据页的数量(SSD盘按照以上配置 SAS盘按照默认即可)innodb_buffer_pool_size = 64G-- 表示定义buffer pool的空间大小(基于128G内存配置,建议不要超过70%~80%)innodb_buffer_pool_instances = 4-- 表示将定义好的buffer pool空间可以拆分为4份,给不同的实例进行使用,避免相同内存空间的争用;innodb_log_buffer_size = 64M-- 定义log buffer空间大小,建议不要超过128M;innodb_max_dirty_pages_pct = 85-- 控制在buffer pool中脏页数量的比例,当达到指定的比例就进行checkpoint操作,将脏页信息进行落盘innodb_lock_wait_timeout = 10-- 主要是控制行锁的等待超时时间,一般控制在10s内innodb_open_files = 63000-- 表示定义最多打开文件句柄的个数,数据库每次访问一个表(即打开一个文件),都会占用一定的文件句柄数量innodb_page_cleaners = 4-- 表示和线程有关的优化(可以忽略)innodb_sort_buffer_size = 64M-- 表示做排序时利用的缓冲区大小innodb_print_all_deadlocks = 1-- 表示将死锁的日志全部记录下来innodb_rollback_on_timeout = ON-- 表示当到达超时时间,会自动解决死锁事务innodb_deadlock_detect = ON-- 表示开启死锁检测功能(默认开启)-- 表示和死锁检测和分析有关的参数-- 对于死锁概念的资料参考:https://blog.csdn.net/java1527/article/details/127105144
数据库服务索引信息优化
非唯一索引按照 'i_字段名称_字段名称[_字段名]' 进行命名
是唯一索引按照 'u_字段名称_字段名称[_字段名]' 进行命名
索引名称使用小写
联合索引中的字段数不超过5个
唯一键由3个以下字段组成,并且字段都是整型时,使用唯一键作为组合主键
没有唯一键或者唯一键不符合上面的条件时,使用自增id作为主键
唯一键不能和主键重复
索引选择度高的列作为联合索引最左条件
ORDER BY、GROUP BY、DISTINCY的字段需要添加在索引的后面,构建联合索引
单张表的索引数量控制在5个以内,若单张表多个字段在查询需求上都要单独用到索引,需要经过DBA评估;
查询性能问题无法解决的,应从产品设计上进行重构
使用EXPLAN判断SQL语句是否合理使用索引,尽量避免extra列出现:Using File Sort,Using Temorary;
UPDATE DELETE 语句需要根据where条件添加索引;
对长度大于50的VARCHAR字段建立索引时,按需求恰当的使用前缀索引,或使用其他方法;
下面的表增加一列url_crc32,然后对url_crc32建立索引,减少索引字段的长度,提高效率;
xxxxxxxxxxcreate table all_url(ID INT UNSIGNED NOT NULL PRIMARY KEY AUTO_INCREMENT,url varchar(255) not null default 0,url_crc32 int unsigned not nullindex idx_url(url_crc32));合理创建联合索引(避免冗余),(a,b,c)相当于(a),(a,b),(a,b,c)
合理利用覆盖索引,减少回表次数;
减少冗余索引和使用率较低的索引:
数据库服务安全方面优化数据库升级与迁移
使用普通nologin用户管理MySQL服务进程;
合理授权用户、设置密码复杂度及最小权限,系统表保证只有管理员用户可以访问;
删除数据库服务中的默认匿名用户信息;
锁定数据库服务中的非活动用户信息;
数据库服务尽量不要暴露到互联网中,需要在互联网中暴露数据库服务地址信息时,要明确设置好白名单信息;
替换数据库默认端口,使用SSL远程连接数据库;
对业务程序代码做好扫描检测优化,防止出现SQL注入漏洞情况;
1.11.15 为什么创建视图可以提升性能?
创建视图,可以提升性能,因为视图可以缓存到buffer pool 中
1.11.16 MySQL8.0 中默认连接数是多少?除了调整连接数 如何优化连接数?
MySQL8.0 默认连接数151
1.11.17 请介绍你使用过的PT工具
Pt-table-checksum负责监控主从数据一致性
Pt-table-sync负责当主从数据不一样时修复数据,让它们保存数据的一致性
Pt-heartbeat负责监控mysql主从同步延迟
Pt-archiver归档数据
1.11.18 MySQL数据库负载高如何处理?
当 MySQL 数据库负载高时,可能会导致性能下降、查询响应慢,甚至会出现服务中断。
对于服务器操作系统出现负载升高,大致有以下10种情况造成:
| 序号 | 情况 | 原因分析 |
|---|---|---|
| 01 | 无限循环情况 | 程序错误导致循环无法停止,从而消耗过多的处理器时间 |
| 02 | 后台进程情况 | 自动任务或更新占用大量资源,大量进程会累积占用CPU资源 |
| 03 | 高并发情况 | 服务器或应用无法应对大量请求,特别是在未适当扩展或优化的情况 |
| 04 | 资源密集型应用情况 | 涉及视频编辑、游戏或科学模拟的应用程序,需要大量的计算能力 |
| 05 | 内存资源不足情况 | 当系统内存不足时,会将磁盘存储作为虚拟内存使用 |
| 06 | 并发进程情况 | 多个进程竞争CPU资源,尤其是当其中许多进程都是资源密集型进程 |
| 07 | 繁忙等待情况 | 进程在不释放CPU的情况下反复检查条件是否满足 |
| 08 | 复杂正则和表达式匹配 | 涉及大量回溯的正则表达式,计算成本高的查询占用大量CPU |
| 09 | 恶意软件情况 | 劫持系统资源来执行未经授权任务的恶意软件,如:病毒、蠕虫或木马等 |
| 10 | IO密集型应用情况 | 出现大量IO资源消耗请求,由于硬件磁盘性能瓶颈,无法短时间处理大量IO资源 |
在MySQL数据库出现负载高时,需要先进行监控和诊断:
可以使用监控工具(MySQL Enterprise Monitor、Prometheus、Grafana 或 Percona Monitoring and Management)监控MySQL服务;
主要监控MySQL的性能指标:CPU使用率、内存占用、磁盘I/O和查询响应的时间等。
可以借助并分析慢查询日志,识别哪些查询耗时较长;并通过 show processlist 查看当前正在执行的查询,找到高负载原因;
xxxxxxxxxxSHOW FULL PROCESSLIST;在数据库服务中,也可以对有些状态指标进行查看或监控:
xxxxxxxxxxSHOW STATUS LIKE 'Threads_connected';-- 表示当前与 MySQL 服务器建立连接的客户端线程的数量SHOW STATUS LIKE 'Threads_running';-- 表示当前正在执行 SQL 语句的线程数量SHOW STATUS LIKE 'Aborted_connects';-- 表示由于某种原因而未能成功建立的连接次数SHOW STATUS LIKE 'Slow_queries';-- 表示执行时间超过设定阈值(通常是 long_query_time 值)的查询总数
在MySQL数据库出现负载高时,后续进行负载高的处理手段:
优化查询
查询优化:对识别出的慢查询进行优化,可能包括使用索引、重写查询语句或引入视图等
使用索引:确保数据库中的常用列(如 WHERE、JOIN、ORDER BY 中使用的列)都已经建立了适当的索引
数据库配置调优
调整数据库参数:评估并可能修改 MySQL 的配置参数(通常在 my.cnf 文件中),例如:
xxxxxxxxxxinnodb_buffer_pool_size;-- 增加 InnoDB 的缓冲池大小,提高数据缓存效率max_connections-- 根据负载增加最大连接数query_cache_size-- 虽然在新版本中已被弃用,但如果使用较旧版本,可以考虑配置查询缓存数据库架构优化
分区设置:对数据量较大的表进行分区,优化查找性能
数据归档:对老旧数据进行归档,减少主表大小,提高查询速度
读写分离:通过主从复制配置读写分离,将读负载分散到从服务器上
使用缓存
应用缓存:在应用层(如 Memcached, Redis等)引入数据缓存,减少数据库访问频率
查询缓存:利用 MySQL 内置的查询缓存(如果适用)存储频繁查询的结果
硬件优化
硬件性能升级:根据负载情况考虑升级硬件,例如增加 RAM、使用更快的 SSD 存储或增加 CPU 核心数
分布式数据库:在流量非常大的情况下,考虑使用分布式数据库解决方案(如 MySQL Cluster 或 Shard)
定期维护
表碎片清理:定期运行 OPTIMIZE TABLE 来清理颗粒度碎片,以提高存储效率和查询性能
分析和更新统计信息:使用 ANALYZE TABLE 更新表的统计信息,以使查询优化器能够选择最佳执行计划
1.11.19 numa 是什么? 为什么要关闭?
在NUMA架构中,每个处理器都有自己的本地内存,但它们也可以访问其他处理器的内存。当处理器需要访问内存时,它们可以通过本地内存子系统直接访问本地内存,或者通过全局内存交换网络来访问远程内存。由于本地内存访问速度更快,处理器会尽可能使用本地内存。这种架构提高了多处理器系统的性能,并使系统更具可扩展性
数据库这种大规模内存使用的应用场景,并且外部的连接大多是随机的,这往往会导致出现大量的Remote Access,当我们是用NUMA避免了BUS的性能瓶颈,而Remote Access又成了新的瓶颈,有点拆了东墙补西墙的感觉。
1.11.20 THP 是什么? 为什么要关闭
THP是一种内存管理机制,它自动创建、管理和使用大页内存。THP通过动态分配大页内存,减少了手动管理大页的复杂性,并且通过优化内存访问来提升系统性能。通常默认启用,但不建议在数据库工作负载中使用,因为可能会导致性能问题
而为什么有些数据库要禁用掉THP ,主要的原因是这类数据库大部分访问内存的方式是分散的,并不是访问连续的页面,而这样的访问模式,就会造成内存的碎片化.访问的page 不也不是大量连续性的. 并且在不启用THP 时申请4KB的内存时,LINUX会分配相应的内存给应用, 但如果是在系统级别启用了THP,则类似数据库申请内存时,即使申请的值是4KB ,但分配是会以大于4KB例如 2MB 来进行分配,这样数据库申请使用内存的方式也会出现问题,和相关的损耗
THP引起的性能波动最典型的症状是系统CPU利用率急剧上升
间接症状:
sys load 上升
https://juejin.cn/post/7382221104503685155
https://cloud.tencent.com/developer/article/1668633
1.11.21 一张很大的表,现在要对这个表结构进行更改,你要怎么做 PT
1.11.22 一条语句执行有问题了,怎么看出来的?
数据库升级与迁移
1.12.1 你们的升级是怎么升级的?遇到过哪些故障?
1.12.2 你做过异构数据库之间的数据迁移吗?(我操作的Redis-mysql)迁移过程中字符集有影响吗?
1.12.3 如何实现数据库的不停服迁移?
【回答重点】
细节,在面试中可以向面试官复述以下几点:
首先关注量级,如果是几十万的数据其实直接用代码迁移,简单核对下就结束了。如果数据量大才需要好好设计方案;
不停服数据迁移需要考虑在线数据的插入和修改,保证数据的一致性;
迁移还需要注意回滚,因为一旦发生问题需要及时切换回老库,防止对业务产生影响;
双写方案:
大部分数据库迁移都会采用双写方案,例如:自建的数据库要迁移到云上的数据库这个场景,双写就是同时写入自建的数据库和云上的数据库;
以下是具体迁移流程:
1)将云上数据库(新库)作为自建数据库(旧库)的从库,进行数据同步(或者可以利用云上的功能,比如阿里云的DTS);
2)改造业务代码,数据写入修改不仅要写入旧库,同时也要写入新库,这就是所谓的双写;
3)在业务低峰期,确保数据同步完全一致的时候(即主从不延迟,这个都是有对应的监控的),关闭同步,同时打开双写开关;
此时业务代码读取的还是旧数据库;
4)进行数据核对,数据量很大的场景只能抽样调查(可以利用定时任务代码进行抽样核对,一旦不一致就告警和记录)
5)如果确认数据一致,此时可以进行灰度切流,比如 1%的用户切到读新的数据库(比如:今天访问前1%的用户或者根据用户ID或其他业务字段)
如果发现没问题,则可以逐步增加开放的比例,比如:5%~20%~50%~100%
6)继续保留双写,跑个几天(或者更久),确保新库确实没问题,此时关闭双写,只写新库,这时候迁移完成
flink-cdc方案:
除了主从同步,代码双写的方案,也可以采用第三方工具。例如:flink-cdc等工具来进行数据的同步;
可以更方便的实现数据迁移,并且支持异构数据(比如: mysql数据同步到pg,oracle等等)的数据源;
1.12.4 MySQL 如何进行数据迁移?
5.6升级5.7
本地升级 (Inplace) 必须进行业务中断 需要提前告知用户中断时间
创建MySQL 5.6 版本实例 (安装部署)
创建测试数据
下载部署5.7数据库程序
提前部署新版本5.7 数据库多实例
进行原有5.6 数据库数据备份(mysqldump xbp 克隆本地)mysqldump 和 xbp 恢复速度太慢了 建议选择 克隆备份
重新编写配置文件,实现数据库升级(挂库升级 让)basedir5.6 和basedir5.7 数据目录上进行关联
进入mysql.5.7 的配置文件 修改 datadir 修改启动端口为56实例的端口
以安全模式启动数据库服务(5.7)
mysqld --default-files=/data/3357/my.cnf --skip-grant-tables --skip-networking避免无法正常启动启动成功时会出现报错(表结构错误)但是不用管,可以正常进入数据库
/usr/local/mysq57/bin/mysql_upgrade -S /tmp/mysql3357.sock /tmp/mysql3357.sock --force
重新启动mysql5.7
进行升级后数据库备份 (mysqldump)
异地升级(Merging)不停止业务进行数据库升级
需要在新的数据库节点安装mysql5.6 程序 (实现主从同步)( 5.6 直接和5.7 简历主从会出现数据无法正常加载)
在从节点安装部署新版本5.7 数据库服务
在从节点上实现 5.6 到5.7 的挂库升级
重新启动5.7 数据库程序,和主库进行数据同步(此时再同步就是业务库信息)
利用MHA高可用服务,实现手工切换主节点
可以再将其他节点依次进行升级
5.7升级8.0
mysql 8.0 以安全模式启动的时候会自动的去调整表结构 其余步骤与上面一样
注意事项
5.7.30 -- 8.0.36
数据库服务版本升级时,只支持在GA(General Availability)版本之间进行升级
数据库服务版本升级时,支持从数据库5.6到5.7再到8.0,跨版本升级,但是需要先将5.6升级到最新小版本,在进行跨版本升级
数据库服务版本升级时,需要提前考虑好版本回退的方案,最好升级前做好数据备份(特别是向8.0版本升级)
数据库服务版本升级时,制定的升级方案和升级步骤,需要尽可能降低数据库服务停机的时间 数据库服务官方参考资料:https://dev.mysql.com/doc/refman/8.0/en/upgrade-paths.html
利用工具进行检测,检测成功,可以顺利升级 https://downloads.mysql.com/archives/shell/ tar xf mysql-shell-8.0.32-linux-glibc2.12-x86-64bit.tar.gz ln -s mysql-shell-8.0.32-linux-glibc2.12-x86-64bit mysqlsh
mysqlsh root:123456@10.0.0.51:3357 -e "util.checkForServerUpgrade()" util.checkForServerUpgrade Errors: 0 -- 检测结束,确认是否有错误信息,有错误信息无法进行版本间直接升级
mysqlcheck -uroot -p123456 -h10.0.0.51 -P3357 --all-databases --check-upgrade
1.12.6 数据库中有张表,怎么移出这张表?
利用表空间迁移方法
故障排错
1.13.1 你最近遇到哪些案例 说一下 你工作中印象最深的一个故障案例 ?
1.13.2 你有没有遇到过MySQL本身有问题?比如写法有问题,你遇到过吗?
1.13.3 在工作中,你是如何发现bug的,什么样算bug,你们是怎么处理的?
1.13.4 在日常维护高可用架构的时候,你发现过哪些问题?
1.13.5 工作中遇到哪些主从延时问题,你是怎么解决的?
1.13.6 主从架构你遇到过什么问题?
我会说主从延时问题,dump线程串行以及sql线程串行的问题,可以通过组提交和逻辑时钟解决,但是面试官会问,你提前怎么没加这两个参数啊?这不是常规配置吗? 这个参数你是从哪里知道的呢
1.13.7 主从同步中 slave_IO 出现错的代码你都见过哪些,都是什么问题,你是怎么处理的?
1.13.8 mysql的逻辑和物理备份 哪个流程你更清楚?请具体说一个备份方式的流程?
1.13.9 客户说11.30 分的时候我删除了一张表,你怎么给他恢复?
1.13.10 遇到的问题,以及解决方法?
1.13.11 你遇到过mysql进程突然没了或突然重启了?如何排查
1.13.12 oom了解吗?(内存溢出)
内存中加载的数据量过于庞大,如一次从数据库取出过多数据 解决:采用分页的方式查询
代码中存在死循环或循环产生过多重复的对象实体
启动参数内存值设定的过小 解决:修改JVM启动参数,直接增加内存
集合类中有对象的引用,使用后未清空,使的JVM不能回收
1.13.13 使用pt工具遇到过哪些故障?
故障
在使用pt-archiver进行 data archive时,发现source与dest总是相差一行数据;
原因:
根据官方解释pt-archiver工具对自增列最大值进行保护,对最大值这一行数据不做任何操作,防止自增列归0,下次归档时报错;如果确实需要全部归档可以增加一个参数--[no]safe-auto-increment进行全部归档,注意业务低峰期进行
1.13.14 数据库内存飙高如何处理?
innodb_buffer_pool_size 参数设置过高导致
show processlist;看正在执行的sql state列是否有sending data等消耗资源sql、或者time执行时间比较久的sql,可以先kill避免mysql oom
total_memory=key_buffer_size+query_cache_size+tmp_table_size+innodb_buffer_pool_size+innodb_additional_mem_pool_size+innodb_log_buffer_size+当前连接数
多表 join、临时表、慢sql、sql返回结果集比较大等
锁 业务反馈报错,经排查有innodb 的next-key lock; 原因:该业务表没有主键,所以innodb的record lock 升级为了next-key lock,导致锁住了整个区间,导致业务报错
1.13.15 有没有遇到内核上的问题无法解决的?
我们8.0.27的mysql集群,在执行一张大表的join 、group by查询时,字段是blob大字段,导致了mysqld crash 该bug发生在线上8.0.27实例上,默认带聚合运算的query使用TempTable引擎;
只有调整temptable相关的配置项(即:temptable_max_ram, temptable_max_mmap),才是有效的操作
当一个带聚合运算的query创建内部临时表时,它使用存储的顺序如下:
创建temp table (TempTable engine), 分配ram内存空间;
ram空间使用超限 -- > 分配mmap空间;
在插入/更新一行时,发现mmap空间使用超限 → 进入步骤2;
将引擎转换为innodb,创建innodb的临时表空间文件(使用磁盘空间),重试插入/更新 1-b中操作的数据;
其中步骤2包含一些 更新指向blob记录指针的操作,在8.0.27上未更新对应指针,导致innodb层尝试在临时表中插入数据时触发bug;
1.13.16 mysql 引起cpu很高的原因?
90%都是sql语句造成的锁等待超时时间 wait_timeout 时间调短一点比如 20
确定高负载的类型 htop,iostat命令看负载高是CPU还是IO 看具体是哪个用户哪个进程占用了相关系统资源,当前CPU、内存谁在使用
监控具体的sql语句,是insert update 还是 delete导致高负载,抓取mysql包分析,一般抓3306端口的数据 看出最繁忙的sql语句了,select子查询尤为常见
检查mysql日志 分析mysql慢日志,查看哪些sql语句最耗时 检查mysql配置参数是否有问题,引起大量的IO或者高CPU操作innodb_flush_log_at_trx_commit 、innodb_buffer_pool_size 、key_buffer_size 等重要参数
检查硬件问题
*redo log写满了*:redo log 里的容量是有限的,如果数据库一直很忙,更新又很频繁,这个时候 redo log 很快就会被写满了,这个时候就没办法等到空闲的时候再把数据同步到磁盘的,只能暂停其他操作,全身心来把数据同步到磁盘中去的,而这个时候,就会导致我们平时正常的SQL语句突然执行的很慢,所以说,数据库在在同步数据到磁盘的时候,就有可能导致我们的SQL语句执行的很慢了
*内存不够用了:*如果一次查询较多的数据,恰好碰到所查数据页不在内存中时,需要申请内存,而此时恰好内存不足的时候就需要淘汰一部分内存数据页,如果是干净页,就直接释放,如果恰好是脏页就需要刷脏页
1.13.17 从库出现 slave 延时你是如何处理的?(魏)
slave延迟带来的风险
异常情况下,主从HA无法切换。HA 软件需要检查数据的一致性,延迟时,主备不一致
备库复制hang会导致备份失败(flush tables with read lock会900s超时)
以 slave 为基准进行的备份,数据不是最新的,而是延迟
如何规避 slave 延迟的问题?
无主键、无索引或索引区分度不高
特征如下
xxxxxxxxxxa. show slave status 显示position一直没有变b. show open tables 显示某个表一直是 in_use 为 1c. show create table 查看表结构可以看到无主键,或者无任何索引,或者索引区分度很差解决方法:
xxxxxxxxxxa. 找到表区分度比较高的几个字段, 可以使用这个方法判断:   select count(*) from xx;    select count(*) from (select distinct xx from xxx) t;   如果2个查询count(*)的结果差不多,说明可以对这些字段加索引
b. 备库stop slave;   可能会执行比较久,因为需要回滚事务
c. 备库   set global slave_rows_search_algorithms='TABLE_SCAN,INDEX_SCAN,HASH_SCAN';
   或者   set sql_log_bin=0;   alter table xx add key xx(xx);
d. 备库start slave
如果是innodb,可以通过show innodb status来查看 rows_inserted,updated,deleted,selected这几个指标来判断
如果每秒修改的记录数比较多,说明复制正在以比较快的速度执行
主库上有大事务,导致从库延时
解决方法
xxxxxxxxxx事前防范,与开发沟通,增加缓存,异步写入数据库,减少业务直接对db的大事务写入。事中补救,调整数据库中io相关的参数比如innodb_flush_log_at_trx_commit和sync_binlog 或者打开并行复制功能主库写入频繁,从库压力跟不上导致延时
此类原因的主要现象是数据库的 IUD 操作非常多,slave由于sql_thread单线程的原因追不上主库
解决方法:
xxxxxxxxxxa 升级从库的硬件配置,比如ssd,fio.b 使用@丁奇的预热工具-relay fetch在备库sql线程执行更新之前,预先将相应的数据加载到内存中,并不能提高sql_thread线程执行sql的能力,也不能加快io_thread线程读取日志的速度。c 使用多线程复制 阿里MySQL团队实现的方案--基于行的并行复制。该方案允许对同一张表进行修改的两个事务并行执行,只要这两个事务修改了表中的不同的行。这个方案可以达到事务间更高的并发度,但是局限是必须使用Row格式的binlog。因为只有使用Row格式的binlog才可以知道一个事务所修改的行的范围,而使用Statement格式的binlog只能知道修改的表对象。大量myisam表,在备份的时候导致slave延迟
由于xtrabackup 工具备份到最后会执行flash tables with read lock ,对数据库进行锁表以便进行一致性备份,然后对于myisam表 锁,会阻碍salve_sql_thread 停滞运行进而导致hang
该问题目前的比较好的解决方式是修改表结构为innodb存储引擎的表
MySQL的改进
为了解决复制延迟的问题,MySQL也在不遗余力的解决主从复制的性能瓶颈,研发高效的复制算法
基于组提交的并行复制
MySQL的复制机制大致原理是:slave 通过io_thread 将主库的binlog拉到从库并写入relay log,由SQL THREAD 读出来relay log并进行重放。当主库写入并发写入压力很大,也即N:1的情形,slave 就可能会出现延迟。MySQL 5.6 版本提供并行复制功能,slave复制相关的线程由io_thread,coordinator_thread,worker构成,其中:
coordinator_thread
负责读取 relay log,将读取的binlog event以事务为单位分发到各个 worker thread 进行执行,并在必要时执行binlog event,比如是DDL 或者跨库事务的时候。
worker_thread:执行分配到的binlog event,各个线程之间互不影响,具体worker_thread 的个数由slave_parallel_workers决定。 需要注意的是 dbname 与 worker 线程的绑定信息在一个hash表中进行维护,hash表以entry为单位,entry中记录当前entry所代表的数据库名,有多少个事务相关的已被分发,执行这些事务的worker thread等信息。
分配线程是以数据库名进行分发的,当一个实例中只有一个数据库的时候,不会对性能有提高,相反,由于增加额外的操作,性能还会有一点回退。 MySQL 5.7 版本提供基于组提交的并行复制,通过设置如下参数来启用并行复制。
slave_parallel_workers>0
global.slave_parallel_type=’LOGICAL_CLOCK’
即主库在ordered_commit中的第二阶段,将同一批commit的 binlog打上一个相同的last_committed标签,同一last_committed的事务在备库是可以同时执行的,因此大大简化了并行复制的逻辑,并打破了相同DB不能并行执行的限制。备库在执行时,具有同一last_committed的事务在备库可以并行的执行,互不干扰,也不需要绑定信息,后一批last_committed的事务需要等待前一批相同last_committed的事务执行完后才可以执行。这样的实现方式大大提高了slave应用relaylog的速度。
xxxxxxxxxxmysql> show variables like 'slave_parallel%';+------------------------+----------+| Variable_name | Value |+------------------------+----------+| slave_parallel_type | DATABASE |#默认是DATABASE 模式的,需要调整或者在my.cnf中配置| slave_parallel_workers | 4 |+------------------------+----------+2 rows in set (0.00 sec)mysql> STOP SLAVE SQL_THREAD;Query OK, 0 rows affected (0.00 sec)mysql> set global slave_parallel_type='LOGICAL_CLOCK';Query OK, 0 rows affected (0.00 sec)mysql> START SLAVE SQL_THREAD;Query OK, 0 rows affected (0.01 sec)
启用并行复制之后查看processlist,系统多了四个线程Waiting for an event from Coordinator(手机用户推荐横屏查看)
xxxxxxxxxxmysql> show processlist;+----+-------------+-----------------+------+---------+------+--------------------------------------------------------+------------------+| Id | User | Host | db | Command | Time | State | Info |+----+-------------+-----------------+------+---------+------+--------------------------------------------------------+------------------+| 9 | root | localhost:40270 | NULL | Query | 0 | starting | show processlist || 10 | system user | | NULL | Connect | 1697 | Waiting for master to send event | NULL || 31 | system user | | NULL | Connect | 5 | Slave has read all relay log; waiting for more updates | NULL || 32 | system user | | NULL | Connect | 5 | Waiting for an event from Coordinator | NULL || 33 | system user | | NULL | Connect | 5 | Waiting for an event from Coordinator | NULL || 34 | system user | | NULL | Connect | 5 | Waiting for an event from Coordinator | NULL || 35 | system user | | NULL | Connect | 5 | Waiting for an event from Coordinator | NULL |+----+-------------+-----------------+------+---------+------+--------------------------------------------------------+------------------+7 rows in set (0.00 sec)
核心参数:
xxxxxxxxxxbinlog_group_commit_sync_no_delay_count:一组里面有多少事物才提交,单位 (ms)binlog_group_commit_sync_delay:等待多少时间后才进行组提交
1.13.18 安装部署时遇到过什么故障?
1.13.19 数据库版本升级时遇到过什么故障?
1.13.20 数据库连接不上,可能原因是什么,如何排查?
1.13.21 连接数设置不生效,最多为214,是什么原因?
1.13.22 http 409错误,达到连接数上限。可能是什么原因导致?
1.13.23 在做DDL操作时,数据库夯住了,原因是什么?
1.13.24 一条SQL语句,昨天执行很快,突然变慢可能是什么原因?
1.13.25 Ibdata1共享表空间文件损坏,导致数据库无法启动,备份也失效,有什么好的解决思路
1.13.26 基于binlog+gtid方式截取的日志无法正常恢复,是什么原因导致?怎么解决?
1.13.27 使用mysqldump方式构建主从,添加了-- set-gtid-purged =off导致主从构建失败?
1.13.28 由于宕机,导致主从数据不一致,如何解决?
1.13.29 Zabbix监控2000+台主机,监控显示缓慢,每隔三四个月重新搭建,存储空间经常被占满
1.13.30 有规律的一段时间,会产生性能低谷
1.13.31 过度条带化导致的性能问题
1.13.32 MySQL 连接长时间(7200和1200秒)无法释放
1.13.33 开启QC ,导致性能降低。 QPS ,TPS降低 是为什么?
安全
1.14.1 MySQL 安全方面你是如何优化的?
为MySQL超级用户root设置密码
登录时尽量不要在命令行暴漏密码
锁定非活动用户
初始删除无用的用户,只保留有用用户
授权用户对应的主机不要只用%(尽量172.16.1.%)
权限不要给all,最小化授权, 从库只给select
Linux 与 Shell
1.15.1 看内存⽤什么命令?看磁盘⽤什么命令?
1.15.2 shell脚本都监控那些指标?
1.15.3 grep命令
1.15.4 awk命令
1.15.5 sed命令
NOSQL
1.16.1 你们公司Redis的是什么架构?
1.16.2 Redis的故障案例?
1.16.3 Redis 集群(哨兵)的原理?如何搭建哨兵集群?
1.16.4 Redis 怎么搭建主从?主从搭建的过程?怎么产生主从关系?
1.16.5 Redis 集群执行slaveof以后,发生了什么?
1.16.6 Redis你们⽤来⼲什么?⽤做过分布式锁?
1.16.7 Redis你们平常都会监控什么指标?
1.16.8 Redis的内存是怎么监控的?
1.16.9 redis 用的什么版本 rdb和aof的优缺点?
1.16.10 Redis持久化方式有哪些?有什么区别?
RDB:基于快照的持久化,速度更快,一般用作备份,主从复制也是依赖于RDB持久化功能
AOF:以追加的方式记录redis操作日志的文件,可以最大程度的保证redis数据安全,类似于mysql的binlog
1.16.11 redis存储原理?
Redis通过将数据存储在内存中、采用高效的数据结构和键值管理机制,以及支持数据持久化和缓存过期等特性
1.16.12 在Redis缓存服务中,常用的数据类型有哪些?
| 序号 | 数据类型 | 解释说明 |
|---|---|---|
| 01 | String | 字符数据类型 |
| 02 | Hash | 字典数据类型 |
| 03 | List | 列表数据类型 |
| 04 | Set | 集合数据类型 |
| 05 | Sorted Set | 有序集合类型 |
1.16.13 MongoDB中oplog的作用是什么? 写满后会怎样?
在MongoDB中,oplog(操作日志)是一个特殊的集合,用于记录MongoDB的所有写操作oplog的作用是支持复制和故障恢复。
具体来说,oplog通过记录主节点(Primary)上的所有写操作,将这些写操作传播到备份节点(Secondary),从而实现数据的复制和同步。当主节点宕机或发生故障时,备份节点可以使用oplog中的操作记录进行故障恢复,快速将自己切换为新的主节点。
oplog的写满会导致什么情况取决于副本集的配置和版本
在MongoDB 4.0及以上版本中,oplog采用的是固定大小(默认为5%)的循环缓冲区。当oplog写满时,最旧的操作记录将被覆盖,这意味着较旧的操作记录将不再可用。这不会影响复制和故障恢复的正常操作,因为备份节点只需要保留与主节点保持同步的最新操作记录即可。
但是,在一些特殊情况下,如长时间主节点不可用、备份节点长时间离线等,如果备份节点无法及时同步主节点的oplog,可能会导致备份节点的oplog落后于主节点,超过了可容忍的范围,这时候备份节点可能无法正常恢复并成为主节点,需要手动进行故障恢复。
在MongoDB 4.2及以上版本中,引入了可配置大小的oplog(永久的oplog)来解决上述问题。这样,即使备份节点离线一段时间,它仍然能够保存足够长的操作记录,以便在重新连接时进行快速同步和故障恢复。
1.16.14 redis 淘汰策略有哪些?
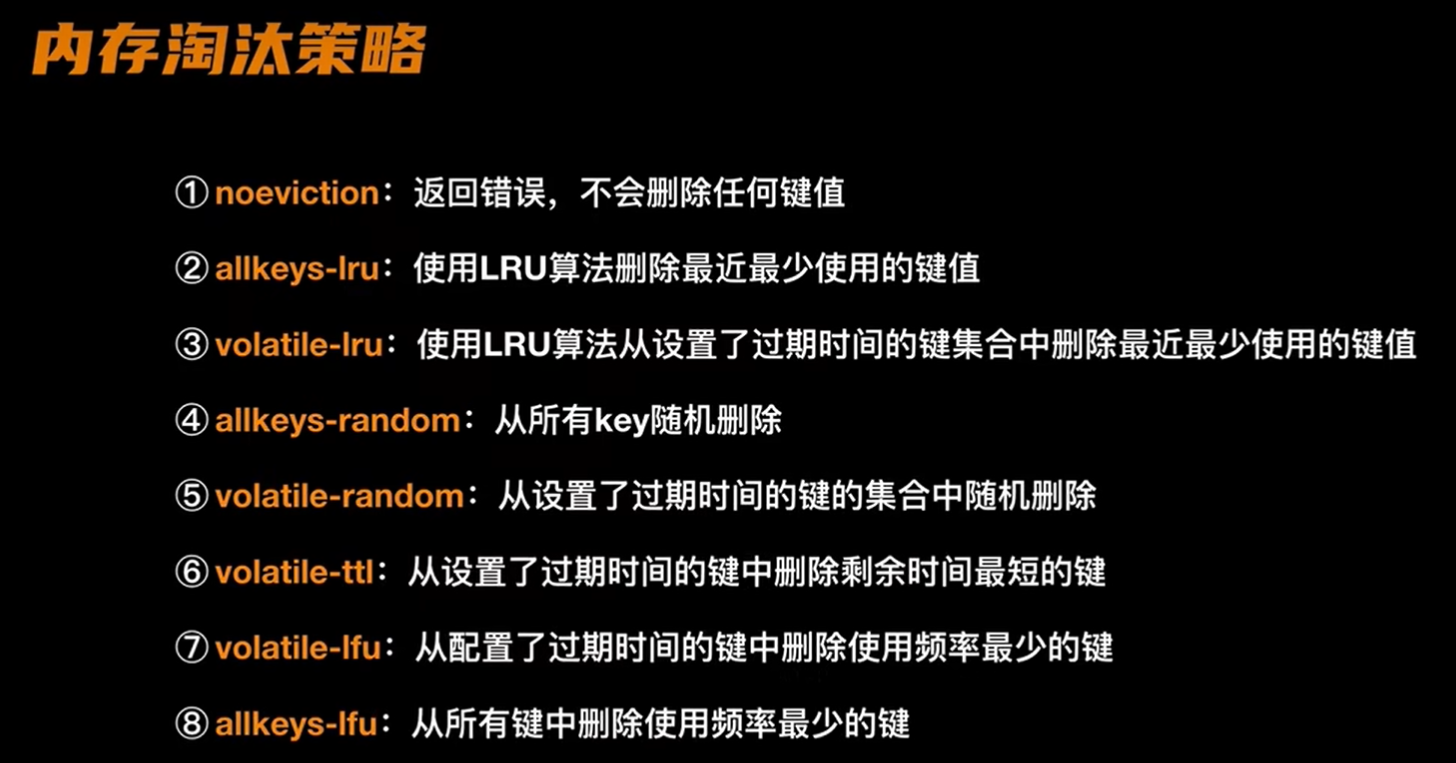
1.16.15 请简述redis数据类型及应用场景?
string:字符类型;应用场景:a:集群后端session共享;b:计数:微博的粉丝数,订阅数,礼物数
hash:字典类型;应用场景:数据前端缓存,如:存储部分变更的数据,如用户信息
list:列表;应用场景:消息队列系统,比如朋友圈
set:集合;应用场景:微博,微信的共同好友
sorted set:有序集合;应用场景:排行,榜取top N操作
1.16.16 请简述redis事务和MySQL事务的区别?
Redis的事务是基于队列实现的
Mysql的事务是基于事务日志和锁机制实现的
Redis是乐观锁机制
1.16.17 请简述redis主从原理
从库通过slaveof+ip+端口命令连接主库,并发送SYNC给主库
主库收到SYNC后立即触发bgsave功能,并生成保存rdb快照,发送给从库
从库收到会应用保存rdb快照
此时主库会陆续将中间产生的新的快照,保存并发送给从库
到此,我们主从复制就正常工作了
再次以后,主库只要发生新的操作,都会以命令的广播方式自动发送给从库
所有复制的相关信息,在info信息中都可以查到,即使重启任何节点主从依然存在
如果主从关系发生断开,重连之后,从库会发送PSYNC给主库后进行断点续传
1.16.18 请简述redis sentinel(哨兵)高可用实现原理?
所有哨兵节点都会检测redis节点,哨兵之间也会互相监督
自动选主,切换采用raft分布式一致性协议进行选主(数据接近住,可以和大部分节点联系,少数服从多数)
重构主从关系
应用透明(自带地址和端口)
自动处理故障节点(剔出集群,修复后重新载入)
1.16.19 请简述redis cluster分布式集群实现原理
在多分片redis节点中,有16384个内存槽位,均匀分布到多个redis分片节点中
存储数据时,将key做crc16计算生成一个数字,然后和16384进行取模,得出槽位值(0-16383之间)
根据计算得出的槽位值,找到相对应的分布节点的主节点,到相对应槽位上存取数据
如果客户端当时连接的节点不是将来要存储的分片节点,分片集群会将客户端连接切换至正真的存储节点进行数据存储
1.6.20 redis 集群用的什么协议??
1.6.21 redis 的数据类型,业务用到了哪些,怎么做的?
云数据库
1.17.1 阿里云或者AWS的RDS使用过程中遇到的问题?
1.17.2 你对阿⾥云的RDS有了解过或者使⽤过吗
1.17.3 阿里云的DTS 你有使用和了解过吗?
容器
1.18.1Docker,部署MySQL,会遇到什么问题(在⽣产中)?
1.18.2 实现docker持久化,通过什么实现?
其他数据库
1.19.1 Oracle加⼀个字段就很快,MySQL却很慢?(同样是千万⾏的表)
1.19.2 分布式数据库ob架构?
1.19.3 OB是怎么将数据分布式存储的?
工作经验
1.20.1 个人及家庭状况
1.20.2 现处城市
1.20.3 未来发展规划
1.20.4 公司规模
1.20.5 业务架构与规模
1.20.6 你们的一套MySQL的qps是多少?(几百)
1.20.7 你们一台物理机是部署一个MySQL还是多套?因为是多实例的,有遇到过实例之间的影响案例吗?
1.20.8 数据规模?(单台实例数据量大小)
1.20.9 MySQL使用的版本和规模?5.7.26 8.0.22?
1.20.10 工作中运维的数据库集群是什么类型的?
1.20.11 mysql 流量你怎么用监控软件监控的?
1.20.12 用户部署了套新架构,你怎么给用户做监控,监控哪些指标?
1.20.13 mysql数据库升级,你常用的是哪个数据库版本的升级?
1.20.14 你们负责数据的ddl和dml的数据发布吗?
1.20.15 DBA应该有哪些品质?如何当好DBA?
1.20.16 你做的好的地方有哪些?
1.20.17 你用过Oracle吗?
1.20.18 DBA 工作职责是什么?
安装和升级数据库服务器,以及应用程序工具构建和配置网络环境;
数据库设计系统存储方案,并制定未来的存储需求计划;
根据开发人员设计的应用系统需求创建数据库存储结构;
根据开发人员的反馈信息,必要的时候,修改数据库的结构;
管理数据库的用户,维护数据库的安全性
控制和监控用户对数据库的存取访问;
监控和优化数据库的性能;
保证数据库的使用符合知识产权相关法规;
维护适当介质上的存档或者备份数据;
制定数据库备份计划,灾难出现时对数据库信息进行恢复;
1.20.19 DBA 工作内容
数据库安装与配置
安装部署服务器:根据企业需求进行数据库软件的安装
配置数据库参数:根据应用型需求和硬件环境调整数据库配置(如 my.cnf 文件)
数据库监控和优化
监控性能:使用监控工具监控查询性能、CPU 使用率、内存使用情况和磁盘 I/O 等
优化查询:通过分析慢查询日志,优化慢查询,使用索引和合适的查询逻辑来提高性能
性能调优:定期学习和研究数据库配置和参数设置,以提高数据库性能
监控数据软件:如 MySQL Enterprise Monitor、Percona Monitoring and Management 等
数据备份与恢复
定期备份:制定和实施备份策略,使用工具(如 mysqldump、mysqlhotcopy、或 Xtrabackup)定期备份数据库
恢复策略:定期测试备份的恢复过程,确保在数据丢失或故障时能够快速恢复
安全管理
用户管理:创建、修改和删除数据库用户及其访问权限,确保数据库安全
访问控制:实施访问控制策略,监控和记录数据库访问,防止未经授权的操作
故障排除与故障恢复
故障诊断:及时识别和诊断数据库故障及性能问题,进行排查和修复
故障恢复:在系统崩溃或数据损坏时,即时采取措施恢复数据库服务
数据库设计与建模
数据库架构设计:参与和配合数据库设计和建模工作,确保数据库设计的合理性和可维护性
数据库迁移升级:进行数据库的迁移和升级工作,如版本升级、数据导入导出等
文档与报告
维护文档:记录数据库的配置、过程、操作手册等相关文档
报告审计:生成性能报告和安全审计,向管理层报告数据库状态及问题
1.20.20 公司几个dba怎么分工
运维技术部
2个运维,2个dba,一个负责mysql,一个负责oracle ,运维负责es,redis等,老大统筹
灰度和生产跑在rds上,测试环境40-50台在公司机房
灰度和生产跑在rds上,测试环境40-50台在公司机房
200套mysql 每套500G数据 每套qps 7k--8k tps 1k-1.5k
定期pt归档,存量5个T
1.20.21 mysql你遇到⽐较严重的问题,收到什么告警,怎么解决的?
1.20.22 binglog 被运维删了,你怎么办?
1.20.23 在不影响业务的情况下怎么进行delete操作,使用的是什么?
1.20.24 你们公司mysql灾难恢复 机制是怎样的
MySQL灾难恢复是指在数据库遭遇意外情况或故障后,采取一系列措施来恢复数据的过程。下面是MySQL灾难恢复的基本步骤:
确定灾难类型:首先要确定灾难的类型,例如硬件故障、软件故障、人为错误等。这有助于决定接下来的恢复策略。
停止数据库服务:在开始恢复之前,停止数据库服务以防止进一步的数据损坏
数据备份:如果有可用的数据备份,将备份数据还原到服务器上。这可以通过使用MySQL的备份工具(如mysqldump)或使用文件系统级别的备份来完成
日志文件恢复:如果无法使用备份数据或备份数据不完整,可以尝试使用MySQL的二进制日志文件进行恢复。这涉及到将二进制日志文件应用到最新的可用数据点
修复和恢复损坏的表:如果在灾难中有数据表损坏或丢失,可以尝试使用MySQL提供的工具(如myisamchk和innodb recovery)来修复和恢复这些表
数据库重建:在极端情况下,如果没有可用的备份数据和有效的日志文件,可能需要重建数据库。这涉及到重新创建数据库架构和重新导入数据
测试和验证:在完成灾难恢复后,对数据库进行测试和验证以确保数据的完整性和一致性
监控和预防:确保在灾难恢复后,对数据库进行定期备份,并实施适当的监控和预防措施,以最大程度地减少未来灾难的风险
1.20.25 公司用的什么服务器,配置什么样
DELL R730 40C 128G 10台、SAS(两组raid10各包含4块磁盘, 2块热备)+512G的SSD放日志
网卡 4块网卡 bonding 做的主备模式真实面试题
1.20.26 接手一个新的项目,怎么很快的开展工作?
了解项目背景
阅读文档:审查项目的所有相关文档,包括需求文档、设计文档、技术文档和使用手册等
了解技术:熟悉项目所使用的技术栈(编程语言、框架、数据库、服务程序等)
与团队沟通
召开项目启动会:与项目团队成员、利益相关者召开会议,明确项目的目标、范围、进度和角色分配
一对一进行交流:与项目的关键成员进行一对一的交流,了解他们的工作内容、挑战和看法
环境搭建
设置开发环境:根据项目的技术栈,搭建本地开发环境,确保能顺利进行开发和测试
获取访问权限:确保能访问相关的代码库、服务器、项目管理工具和文档平台
制定工作计划
明确优先级:理解项目的当前紧急需求和长远目标,制定合理的工作计划
划分任务组:将整体工作拆分成小任务,并根据优先级分配给自己和团队成员
学习与提升
确定学习资源:如果项目中使用了不熟悉的技术或工具,尽快找到学习资源(如在线课程、书籍、社区等)
主动请教专家:向团队和相关专业人士请教,迅速解决工作中遇到的问题
建立沟通渠道
定期会议交流:建立定期的团队会议(如站立会、进度汇报会),保持团队之间的沟通
使用管理工具:利用项目管理工具(如 Jira、Trello、Asana)跟踪任务和进度,提高团队协调的效率
文档与知识分享
建立文档:在工作过程中记录重要的信息和决策,为后续团队成员提供参考
分享经验:在团队中分享你的经验和知识,促进团队的学习和成长
1.20.27 数据库规模有多大,存储量情况,QPS数值 TPS数值?
在电商网站的数据库架构中,采用一主三从的配置是较为常见的(3~5套),特别是在高并发和高可用性要求的场景下。
关于QPS(Queries Per Second)、TPS(Transactions Per Second)、存储数据量和每天数据增长量的问题,
这些参数会因具体的业务情况而有所不同。下面是一些可能的估算和分析
01 QPS(每秒查询数)
| 序号 | 网站规模 | 数值参考 |
|---|---|---|
| 01 | 小型电商网站 | 几十到几百QPS |
| 02 | 中型电商网站 | 几百到几千QPS |
| 03 | 大型电商网站 | 几千到上万QPS |
影响因素:
并发用户数量
网站的商品数量、订单数量和访问量高峰(如促销活动)
数据库优化和缓存策略(如使用Redis等缓存层)
02 TPS(每秒事务数)
| 序号 | 网站规模 | 数值参考 |
|---|---|---|
| 01 | 小型电商网站 | 几十到几百TPS |
| 02 | 中型电商网站 | 几百到几千TPS |
| 03 | 大型电商网站 | 几千到上万TPS |
影响因素:
平均每个订单影响的数据库操作数量(如下单、支付、退款等)
提交事务的频率(如购物车处理、批量订单等)
数据库的设计和表结构(如是否合理分拆、如何索引等)
03 存储数据量
| 序号 | 网站规模 | 数值参考 |
|---|---|---|
| 01 | 小型电商网站 | 10GB到100GB |
| 02 | 中型电商网站 | 几百GB到几TB |
| 03 | 大型电商网站 | 数TB到数十TB |
影响因素:
商品数量和商品详情
用户的数据量(用户信息、历史订单等)
日志和历史数据的存储策略(如是否归档历史数据)
04 数据每天增长量
| 序号 | 网站规模 | 数值参考 |
|---|---|---|
| 01 | 小型电商网站 | 几MB到几GB |
| 02 | 中型电商网站 | 几GB到十几GB |
| 03 | 大型电商网站 | 十几GB到几百GB |
影响因素:
日均活跃用户数
每天的交易量(订单、支付等)
网站的促销活动和季节性变化(如“双十一”期间的巨大流量)
推荐面试话术:(假设运行的是一个中型电商网站)
三套一主三从数据库MySQL架构:
QPS:1000
TPS:300
存储数据量:500GB
每天增长量:10GB(假设每天新增1000个订单,每个订单大约占用10KB)
真实面试题
腾讯一面
工作中运维的数据库集群是什么类型的
MySQL使用的版本和规模?5.7.26 8.0.22
MySQL 5.7 和 8.0 的区别?
索引的优化?MySQL 的索引用的那种?
B+ TREE 和 B TREE 的区别 B+TREE 有什么好处?
链表和数组相比,链表和数组适用于的什么访问?
MySQL 存储引擎有哪些?
Innodb 和 MyISAM 有什么区别?
Innodb 支持事务的原因?
Innodb 的MVCC 原理?
MVCC 中是如何判断其他事务是否可见?
MVCC 是判断哪些版本可以访问?
idb 和 frm 文件是什么?
如何从 frm 中提取表结构?
ibdata 和 ib_log_file 放的什么?
工作中遇到哪些主从延时问题,你是怎么解决的?
某外包二面
你们公司生产环境中,什么样的情况算bug,bug是怎样发现怎么处理的,你又是如何收到这些bug的?如何形成闭环?
在日常维护高可用架构的时候,你发现过哪些问题?
你用过Oracle吗?
你在公司中使用的什么版本的mysql?
你在工作中主从架构遇到过哪些问题?
英姿舞动(上海)
之前在别的城市为什么来上海?
MHA 的流程 和 探测机制?
mysql的逻辑和物理备份 哪个流程你更清楚?请具体说一个备份方式的流程?
xtrabackup 备份原理和流程你说一下?
acid 是什么?
事务的隔离级别有哪几个?
客户说11.30 分的时候我删除了一张表,你怎么给他恢复?
mysql数据库升级,你常用的是哪个数据库版本的升级?
mysql从5.6 升级到5.7 是不是大版本升级?
你做的好的地方有哪些?
redo 和 undo 的区别?
用户部署了套新架构,你怎么给用户做监控,监控哪些指标?
mysql 流量你怎么用监控软件监控的?
双照科技一面(银行外包)
公司是甲方还是乙方?有没有驻场经验?
有没有做过数据迁移?
是从哪里迁移 mysql迁移到mysql 还是别的数据库迁移到另一个数据库?
迁移是怎么做的?
shell 和 python 的开发技能怎么样?
如果运维数据库中,有客户反应sql很慢?很卡 你排查的思路?
实际中遇到的慢查询的经典案例?
部署主从的必要条件?
主从用途是什么?
你有没有部署过主从?主从部署的时候主库要做什么操作配置从库要做什么配置?
mysql千万级的大表怎么优化?之前有做过这个方面的经验吗?
过多的索引有什么问题?
我创建了索引但是不走索引可能有哪些原因?
如何理解死锁,如何避免死锁?如何检测死锁?
上海某公司一面(外包 到金融服务,证券公司)
你之前在公司使用的数据库架构是怎样的?
MHA 了解过吗?MHA的探测机制?如何判断主库存活,如何判断MySQL库是否异常?
MHA 会去检查 MySQL 进程正常吗?(主动去查询,和插入数据去探测)
MGR有了解过吗?复制原理能说一下吗?
慢查询的思路?
如何有个客户说CPU比较高,你是怎么定位到是哪个SQL? 造成的 top mysql - 线程
mysql 执行计划你是怎么看的?
mysql 隔离级别,你能说一下吗?
什么是RR 级别?
主从同步的流程?如何搭建的?
如何使用主从同步延时恢复数据?你在项目中怎么使用的?
你常用的mysql备份是怎么做的?
xtrabackup 备份流程是怎样的?
是否了解过 oceanbase TIDB openguass;
上海某公司一面
MySQL 的内存结构包括哪些块?
MySQL 你维护的版本?
你运维的mysql架构是什么样的?
读写分离,是云上的还是自己建立的?
读写分离是怎么实现的?
MySQL 数据规模,最大的数据库实例是多大?
备份是用什么备份的,什么备份策略?
xtrabackup 备份的时候,你的查询语句会影响你的备份吗?
grep sed awk?
锁的级别种类?
MVCC
主从延时
SQL 性能抖动
死锁视图
死锁检查算法,和底层原理
join 连接原理
从什么维度去找到问题SQL 时间?
使用的mysql 版本
版本升级考虑因素
5.7 和 8.0 的对比
面试公司黑名单
实壹科技公司(上海)
35岁年龄歧视
上海子矛公司
面试骗操作
面试技巧
回答文本尽量全面
熟悉的技术问题,不要一次性所有相关知识都说清楚,保留一部分让面试官去问
面试回答问题最好结合业务去回答,可以举一些例子